1 Introdução
A análise multivariada é o campo da estatística dedicado a compreender conjuntos de dados com múltiplas variáveis correlacionadas. Os métodos multivariados permitem examinar simultaneamente as relações entre elas para extrair padrões e estruturas que de outra forma permaneceriam ocultos. Na prática, esses métodos atacam quatro problemas comuns: resumir conjuntos grandes reduzindo a sua dimensão sem perder variação relevante; descobrir grupos ou classificar novas observações em categorias já conhecidas; investigar a dependência entre variáveis para entender como elas se associam; e fazer previsões ou inferências quando há relações de modelagem estatística em jogo.
As técnicas que perseguem esses objetivos costumam ser separadas em dois grupos. As técnicas de dependência partem de uma divisão prévia entre variáveis dependentes e independentes, e buscam prever ou explicar as primeiras a partir das segundas. Já as técnicas de interdependência tratam todas as variáveis igualmente, sem essa separação, e procuram descrever a estrutura do conjunto como um todo. A escolha da técnica também depende da natureza das variáveis: as categóricas (ou qualitativas) registram categorias e grupos, como gênero ou tipo de produto, enquanto as métricas (ou quantitativas) registram quantidades numéricas, como idade, altura, renda ou temperatura. Cada método foi construído tendo em vista certos tipos de variável, e é essa combinação entre objetivo e natureza dos dados que orienta a escolha.
A Tabela 1.1 reúne as técnicas apresentadas no livro segundo esses critérios, e a Figura 1.1 organiza a mesma informação como um roteiro de decisão, partindo das perguntas que costumamos fazer diante de um conjunto de dados. O diagrama é um guia simplificado e não exaustivo: ele serve para posicionar as técnicas discutidas aqui, e a escolha final deve sempre considerar o contexto do problema e as características detalhadas dos dados.
| Técnica | Objetivo(s) | Tipo de Análise |
|---|---|---|
| Análise de Componentes Principais (ACP) | Relação entre variáveis métricas ou Redução de dimensionalidade | Interdependência |
| Análise de Correspondência Simples (ACS) e Múltipla (ACM) | Relação entre variáveis categóricas | Interdependência |
| Análise Fatorial (AF) | Fatorização conjunta de variáveis métricas | Interdependência |
| Análise de Agrupamento | Formação de grupos homogêneos | Interdependência |
| Análise Discriminante | Classificação de observações | Dependência |
| Correlação Canônica (ACC) | Relação entre conjuntos de variáveis métricas | Dependência |
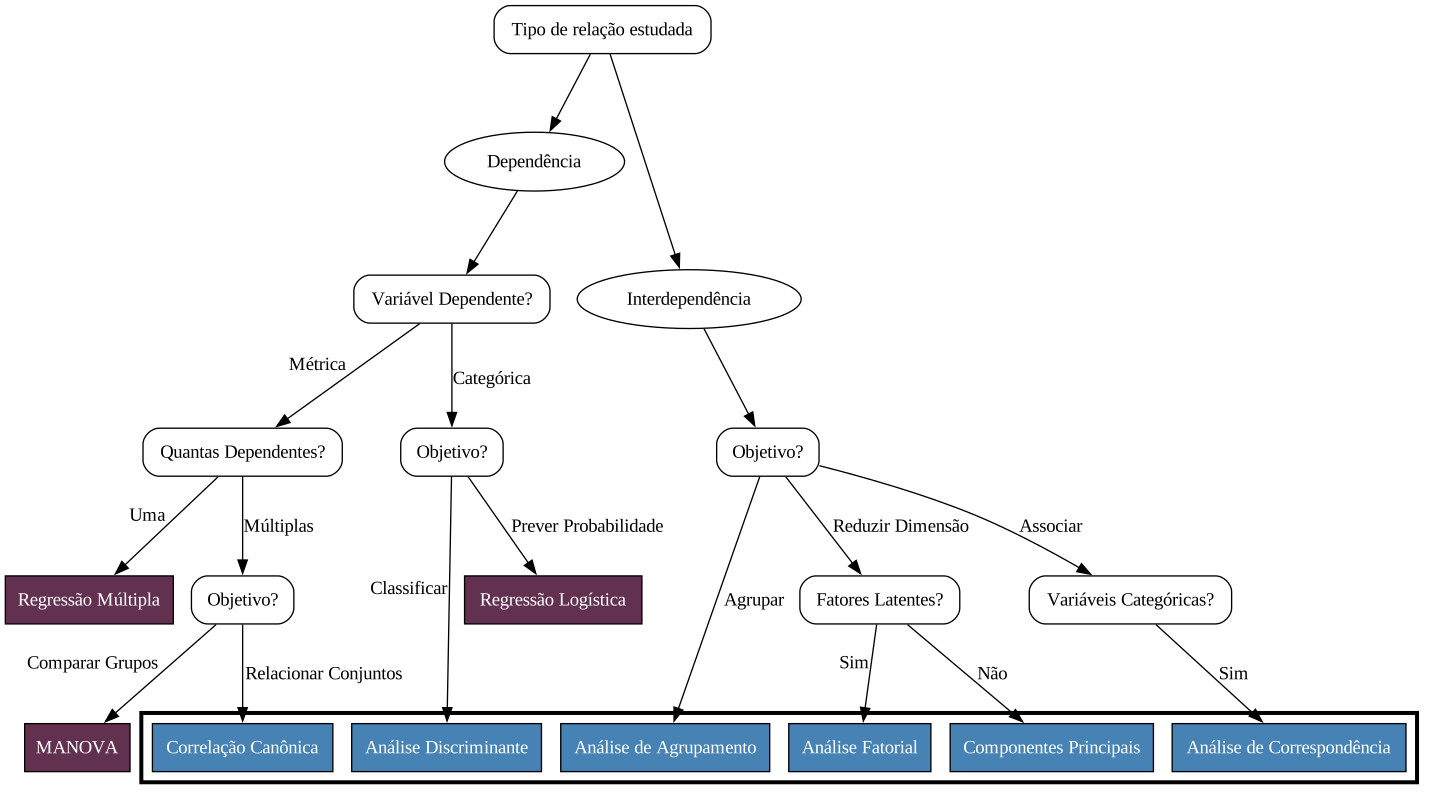
Nos próximos capítulos, construiremos a base teórica para atingir esses objetivos, começando pelo conceito de vetor aleatório e seus parâmetros, para depois explorarmos como as amostras de dados nos permitem estimar e analisar essas estruturas.
1.1 Vetores aleatórios
Em estudos estatísticos multivariados, temos uma população de interesse (como os estudantes de uma universidade) e um conjunto de \(p\) características observadas (como notas em diferentes disciplinas e horas de estudo). Como essas características variam entre os elementos da população, cada uma delas pode ser tratada como uma variável aleatória, com sua própria distribuição de probabilidade. Para facilitar, podemos organizar essas variáveis em um vetor aleatório.
Definição 1.1 (Vetor aleatório) Um vetor aleatório \(\boldsymbol{x}\) é um vetor-coluna cujos componentes são \(p\) variáveis aleatórias, \(X_1, X_2, \ldots, X_p\).
\[ \boldsymbol{x}= \begin{pmatrix} X_1 \\ X_2 \\ \vdots \\ X_p \end{pmatrix} \]
A esse vetor associamos uma distribuição multivariada que governa o comportamento da população. Suas propriedades e estrutura de variabilidade formam a base para todas as técnicas do livro.
- Uma letra minúscula em negrito (e.g., \(\boldsymbol{x}\)) denota vetores em geral, sejam eles aleatórios, observados ou de constantes; o contexto distingue os casos.
- Uma letra maiúscula comum (e.g., \(X_j\)) denota uma variável aleatória escalar, o \(j\)-ésimo componente do vetor.
- Mais adiante, uma letra maiúscula em negrito (e.g., \(\boldsymbol{X}\)) será usada para a matriz de dados (amostral).
- O sobrescrito \(T\) denota transposição: \(\boldsymbol{A}^T\) é a transposta de \(\boldsymbol{A}\). Essa operação troca linhas por colunas; em particular, o vetor-coluna \(\boldsymbol{x}\) da definição acima se torna o vetor-linha \(\boldsymbol{x}^T = (X_1, X_2, \ldots, X_p)\).
Assim como as variáveis aleatórias, os vetores aleatórios são caracterizados por parâmetros como a média e a variância, com o acréscimo de que agora também há parâmetros associados às correlações entre as variáveis em estudo.
Definição 1.2 (Vetor de médias populacional) O vetor de médias populacional, denotado por \(\boldsymbol{\mu}\), é o vetor das expectativas de cada uma de suas variáveis componentes.
\[ \boldsymbol{\mu}= \operatorname{E}\left[\boldsymbol{x}\right] = \begin{pmatrix} \operatorname{E}\left[X_1\right] \\ \operatorname{E}\left[X_2\right] \\ \vdots \\ \operatorname{E}\left[X_p\right] \end{pmatrix} = \begin{pmatrix} \mu_1 \\ \mu_2 \\ \vdots \\ \mu_p \end{pmatrix} \]
Geometricamente, \(\boldsymbol{\mu}\) representa o centróide (centro de massa) da distribuição de probabilidade no espaço \(p\)-dimensional.
Definição 1.3 (Matriz de covariâncias populacional) A matriz de covariâncias populacional, denotada por \(\boldsymbol{\Sigma}\), é uma matriz simétrica \(p \times p\) cujo elemento \((j, k)\) é a covariância entre a \(j\)-ésima e a \(k\)-ésima variável aleatória, \(\sigma_{jk} = \operatorname{Cov}\left(X_j, X_k\right) = \operatorname{E}\left[(X_j - \mu_j)(X_k - \mu_k)\right]\).
\[ \boldsymbol{\Sigma}= \operatorname{Cov}\left(\boldsymbol{x}\right) = \operatorname{E}\left[(\boldsymbol{x}- \boldsymbol{\mu})(\boldsymbol{x}- \boldsymbol{\mu})^T\right] = \begin{pmatrix} \sigma_{11} & \sigma_{12} & \cdots & \sigma_{1p} \\ \sigma_{21} & \sigma_{22} & \cdots & \sigma_{2p} \\ \vdots & \vdots & \ddots & \vdots \\ \sigma_{p1} & \sigma_{p2} & \cdots & \sigma_{pp} \end{pmatrix} \]
Na diagonal estão as variâncias, \(\sigma_{jj} = \operatorname{Var}\left(X_j\right)\), que medem a dispersão de cada variável; fora dela estão as covariâncias, \(\sigma_{jk}\), que medem a tendência de associação linear entre as variáveis \(X_j\) e \(X_k\). A matriz é simétrica, pois \(\operatorname{Cov}\left(X_j, X_k\right) = \operatorname{Cov}\left(X_k, X_j\right)\), o que implica \(\sigma_{jk} = \sigma_{kj}\).
Definição 1.4 (Matriz de correlações populacional) A matriz de correlações populacional, denotada por \(\boldsymbol{\rho}\), é uma versão reescalada da matriz de covariâncias, com elementos \(\rho_{jk} = \frac{\sigma_{jk}}{\sqrt{\sigma_{jj}}\sqrt{\sigma_{kk}}}\).
\[ \boldsymbol{\rho}= \begin{pmatrix} 1 & \rho_{12} & \cdots & \rho_{1p} \\ \rho_{21} & 1 & \cdots & \rho_{2p} \\ \vdots & \vdots & \ddots & \vdots \\ \rho_{p1} & \rho_{p2} & \cdots & 1 \end{pmatrix} \]
Escrevendo \(\boldsymbol{D} = \operatorname{diag}\left(\sqrt{\sigma_{11}}, \dots, \sqrt{\sigma_{pp}}\right)\) para a matriz diagonal dos desvios padrão, a passagem de uma matriz para a outra é imediata:
\[\boldsymbol{\rho}= \boldsymbol{D}^{-1}\boldsymbol{\Sigma}\boldsymbol{D}^{-1}, \qquad \boldsymbol{\Sigma}= \boldsymbol{D}\boldsymbol{\rho}\boldsymbol{D}\]
Seus elementos \(\rho_{jk}\) variam de -1 a 1, fornecendo uma medida de associação linear livre de escala.
Os operadores de esperança e variância no caso multivariado são generalizações diretas dos resultados univariados, e possuem propriedades semelhantes. Seja \(\boldsymbol{x}\) um vetor aleatório \(p\)-dimensional com média \(\boldsymbol{\mu}\) e covariância \(\boldsymbol{\Sigma}\). Sejam \(\boldsymbol{A}\) uma matriz de constantes \(q \times p\) e \(\boldsymbol{c}\) um vetor de constantes \(q \times 1\).
Esperança de uma Combinação Linear: \[ \operatorname{E}\left[\boldsymbol{A}\boldsymbol{x}+ \boldsymbol{c}\right] = \boldsymbol{A}\operatorname{E}\left[\boldsymbol{x}\right] + \boldsymbol{c} = \boldsymbol{A}\boldsymbol{\mu}+ \boldsymbol{c} \]
Covariância de uma Combinação Linear: \[ \operatorname{Cov}\left(\boldsymbol{A}\boldsymbol{x}+ \boldsymbol{c}\right) = \boldsymbol{A}\operatorname{Cov}\left(\boldsymbol{x}\right)\boldsymbol{A}^T = \boldsymbol{A}\boldsymbol{\Sigma}\boldsymbol{A}^T \]
Na prática, não temos acesso a esses parâmetros populacionais (\(\boldsymbol{\mu}\), \(\boldsymbol{\Sigma}\), \(\boldsymbol{\rho}\)), mas podemos usar dados observados para obter estimativas confiáveis deles. Assumimos que coletamos uma amostra aleatória de \(n\) observações da população. Cada observação, \(\boldsymbol{x}_i\) (com \(i=1, \ldots, n\)), é uma realização independente do vetor aleatório \(\boldsymbol{x}\) que definimos neste capítulo. A coleção de todas essas observações forma a nossa matriz de dados.
Definição 1.5 (Matriz de dados) A matriz de dados, denotada por \(\boldsymbol{X}\), é uma matriz de dimensão \(n \times p\), onde cada linha é uma observação multivariada e cada coluna representa uma variável.
\[ \boldsymbol{X}= \begin{pmatrix} \boldsymbol{x}_1^T \\ \boldsymbol{x}_2^T \\ \vdots \\ \boldsymbol{x}_n^T \end{pmatrix} = \begin{pmatrix} x_{11} & x_{12} & \cdots & x_{1p} \\ x_{21} & x_{22} & \cdots & x_{2p} \\ \vdots & \vdots & \ddots & \vdots \\ x_{n1} & x_{n2} & \cdots & x_{np} \end{pmatrix} \tag{1.1}\]
O elemento \(x_{ij}\) representa o valor da \(j\)-ésima variável para a \(i\)-ésima observação.
Na prática, os parâmetros populacionais não são conhecidos e precisam ser estimados a partir da matriz de dados. Embora nosso foco principal não seja a inferência, três estimadores usuais aparecem ao longo de todo o livro:
Definição 1.6 (Vetor de médias amostral) O estimador usual de \(\boldsymbol{\mu}\) é o vetor de médias amostral, \(\bar{\boldsymbol{x}}\). Escrevendo \(\boldsymbol{1}_n\) para o vetor \(n \times 1\) com todas as entradas iguais a 1, ele é dado por
\[ \bar{\boldsymbol{x}}= \frac{1}{n}\boldsymbol{X}^T\boldsymbol{1}_n \]
Elemento a elemento, cada componente \(\bar{x}_j\) é a média das observações da \(j\)-ésima variável:
\[ \bar{x}_j = \frac{1}{n} \sum_{i=1}^n x_{ij} \quad \text{resultando em} \quad \bar{\boldsymbol{x}}= \begin{pmatrix} \bar{x}_1 \\ \vdots \\ \bar{x}_p \end{pmatrix} \]
Definição 1.7 (Matriz de covariâncias amostral) O estimador usual de \(\boldsymbol{\Sigma}\) é a matriz de covariâncias amostral, \(\boldsymbol{S}\). Escrevendo \(\boldsymbol{H} = \boldsymbol{I}_n - \frac{1}{n}\boldsymbol{1}_n\boldsymbol{1}_n^T\) para a matriz de centralização, que subtrai de cada coluna de \(\boldsymbol{X}\) a sua média, temos
\[ \boldsymbol{S}= \frac{1}{n-1}\boldsymbol{X}^T\boldsymbol{H}\boldsymbol{X}\quad \text{ou equivalentemente,} \quad \boldsymbol{S}= \frac{1}{n-1}\left(\boldsymbol{X}^T\boldsymbol{X}- n\bar{\boldsymbol{x}}\bar{\boldsymbol{x}}^T\right) \]
Elemento a elemento, \(s_{jk}\) é a variância amostral (quando \(j=k\)) ou a covariância amostral (quando \(j \neq k\)):
\[ s_{jk} = \frac{1}{n-1} \sum_{i=1}^n (x_{ij} - \bar{x}_j)(x_{ik} - \bar{x}_k) \quad \text{resultando em} \quad \boldsymbol{S}= \begin{pmatrix} s_{11} & s_{12} & \cdots & s_{1p} \\ s_{21} & s_{22} & \cdots & s_{2p} \\ \vdots & \vdots & \ddots & \vdots \\ s_{p1} & s_{p2} & \cdots & s_{pp} \end{pmatrix} \]
Lembrando que a divisão por \(n-1\) (em vez de \(n\)) torna \(s_{jk}\) um estimador não viesado de \(\sigma_{jk}\), ou seja, \(\operatorname{E}\left[s_{jk}\right] = \sigma_{jk}\).
Definição 1.8 (Matriz de correlações amostral) O estimador usual de \(\boldsymbol{\rho}\) é a matriz de correlações amostral, \(\boldsymbol{R}\). Escrevendo \(\boldsymbol{D}_s = \operatorname{diag}\left(\sqrt{s_{11}}, \dots, \sqrt{s_{pp}}\right)\) para a matriz diagonal dos desvios padrão amostrais, definimos \(\boldsymbol{R}\) por:
\[ \boldsymbol{R}= \boldsymbol{D}_s^{-1}\boldsymbol{S}\boldsymbol{D}_s^{-1} \]
Cada entrada \(r_{jk}\) de \(\boldsymbol{R}\) é obtida padronizando a covariância amostral:
\[ r_{jk} = \frac{s_{jk}}{\sqrt{s_{jj}} \sqrt{s_{kk}}} \quad \text{resultando em} \quad \boldsymbol{R}= \begin{pmatrix} 1 & r_{12} & \cdots & r_{1p} \\ r_{21} & 1 & \cdots & r_{2p} \\ \vdots & \vdots & \ddots & \vdots \\ r_{p1} & r_{p2} & \cdots & 1 \end{pmatrix} \]
1.2 Outras estruturas de dados multivariados
A matriz de dados \(\boldsymbol{X}\) é a estrutura de dados costumeira para representar dados multivariados. No entanto, existem outras estruturas importantes que serão úteis durante este livro. Em particular, temos algumas estruturas para dados categóricos.
Definição 1.9 (Tabela de contingência) Sejam \(X\) e \(Y\) duas variáveis categóricas com \(I\) e \(J\) categorias, respectivamente. Uma tabela de contingência (ou matriz de contingência) \(\boldsymbol{N}\) de dimensão \(I \times J\) é uma matriz onde cada elemento \(n_{ij}\) representa a contagem (frequência absoluta) de observações que pertencem simultaneamente à \(i\)-ésima categoria de \(X\) e à \(j\)-ésima categoria de \(Y\).
| \(X \setminus Y\) | Categoria \(1\) | Categoria \(2\) | \(\cdots\) | Categoria \(J\) | Total |
|---|---|---|---|---|---|
| Categoria \(1\) | \(n_{11}\) | \(n_{12}\) | \(\cdots\) | \(n_{1J}\) | \(n_{1.}\) |
| Categoria \(2\) | \(n_{21}\) | \(n_{22}\) | \(\cdots\) | \(n_{2J}\) | \(n_{2.}\) |
| \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\ddots\) | \(\vdots\) | \(\vdots\) |
| Categoria \(I\) | \(n_{I1}\) | \(n_{I2}\) | \(\cdots\) | \(n_{IJ}\) | \(n_{I.}\) |
| Total | \(n_{.1}\) | \(n_{.2}\) | \(\cdots\) | \(n_{.J}\) | \(n\) |
As somas nas margens da tabela fornecem os totais de cada categoria: \(n_{i.} = \sum_{j=1}^{J} n_{ij}\) é o total marginal da \(i\)-ésima linha (categoria \(i\) de \(X\)) e \(n_{.j} = \sum_{i=1}^{I} n_{ij}\) é o total marginal da \(j\)-ésima coluna (categoria \(j\) de \(Y\)). A soma de todas as contagens resulta no número total de observações da amostra, \(n = \sum_{i=1}^{I} \sum_{j=1}^{J} n_{ij}\).
Definição 1.10 (Matriz de correspondência) A matriz de correspondência, denotada por \(\boldsymbol{P}\), é obtida dividindo cada elemento da tabela de contingência \(\boldsymbol{N}\) pelo total geral de observações \(n\). Cada elemento \(p_{ij} = n_{ij}/n\) representa a frequência relativa conjunta das categorias \(i\) e \(j\).
\[ \boldsymbol{P} = \frac{1}{n} \boldsymbol{N} \]
| \(X \setminus Y\) | Categoria \(1\) | Categoria \(2\) | \(\cdots\) | Categoria \(J\) | Total |
|---|---|---|---|---|---|
| Categoria \(1\) | \(p_{11}\) | \(p_{12}\) | \(\cdots\) | \(p_{1J}\) | \(p_{1.}\) |
| Categoria \(2\) | \(p_{21}\) | \(p_{22}\) | \(\cdots\) | \(p_{2J}\) | \(p_{2.}\) |
| \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\ddots\) | \(\vdots\) | \(\vdots\) |
| Categoria \(I\) | \(p_{I1}\) | \(p_{I2}\) | \(\cdots\) | \(p_{IJ}\) | \(p_{I.}\) |
| Total | \(p_{.1}\) | \(p_{.2}\) | \(\cdots\) | \(p_{.J}\) | \(1\) |
As somas marginais da matriz de correspondência formam os vetores de proporções marginais.
Quando existem três ou mais variáveis categóricas, duas outras estruturas são úteis: a matriz indicadora e a tabela de Burt.
Definição 1.11 (Matriz indicadora) Considere uma amostra de \(n\) observações sobre \(Q\) variáveis categóricas, onde a \(q\)-ésima variável possui \(J_q\) categorias, com \(J = \sum_{q=1}^Q J_q\) categorias no total. A matriz indicadora (ou matriz de variáveis dummy), denotada por \(\boldsymbol{Z}\), é uma matriz binária de dimensão \(n \times J\) particionada em \(Q\) blocos:
\[ \boldsymbol{Z} = \begin{pmatrix} \boldsymbol{Z}_1 & \boldsymbol{Z}_2 & \cdots & \boldsymbol{Z}_Q \end{pmatrix} \]
onde cada bloco \(\boldsymbol{Z}_q\) tem dimensão \(n \times J_q\). O elemento \((i, j)\) de \(\boldsymbol{Z}_q\) é igual a \(1\) se a \(i\)-ésima observação pertence à \(j\)-ésima categoria da variável \(q\), e \(0\) caso contrário. Como cada observação assume exatamente uma categoria por variável, cada linha do bloco \(\boldsymbol{Z}_q\) possui uma única entrada igual a \(1\). Consequentemente, cada linha da matriz completa \(\boldsymbol{Z}\) soma \(Q\) (o número de variáveis), e a soma de todos os elementos de \(\boldsymbol{Z}\) é igual a \(n Q\). As somas das colunas de \(\boldsymbol{Z}\) correspondem às frequências marginais de cada categoria.
Definição 1.12 (Tabela de Burt) A tabela de Burt (ou matriz de Burt), denotada por \(\boldsymbol{B}\), é uma matriz simétrica de dimensão \(J \times J\) obtida pelo produto \(\boldsymbol{B} = \boldsymbol{Z}^T\boldsymbol{Z}\). Ela é estruturada em \(Q \times Q\) blocos formados pelas tabelas de contingência entre todas as variáveis tomadas duas a duas:
\[ \boldsymbol{B} = \begin{pmatrix} \boldsymbol{N}_{11} & \boldsymbol{N}_{12} & \cdots & \boldsymbol{N}_{1Q} \\ \boldsymbol{N}_{21} & \boldsymbol{N}_{22} & \cdots & \boldsymbol{N}_{2Q} \\ \vdots & \vdots & \ddots & \vdots \\ \boldsymbol{N}_{Q1} & \boldsymbol{N}_{Q2} & \cdots & \boldsymbol{N}_{QQ} \end{pmatrix} \]
onde cada bloco fora da diagonal, \(\boldsymbol{N}_{qk} = \boldsymbol{Z}_q^T\boldsymbol{Z}_k\) (\(q \neq k\)), é a tabela de contingência entre as variáveis \(q\) e \(k\). Quando \(q = k\), o bloco diagonal \(\boldsymbol{N}_{qq}\) é uma matriz diagonal contendo as frequências marginais da variável \(q\).