4 Análise de componentes principais
A Análise de Componentes Principais (ACP) é uma técnica para estudar e reorganizar a variabilidade de um conjunto de variáveis métricas. A ACP constrói um novo sistema de coordenadas para os dados, possivelmente simplificando as análises. Os novos eixos são combinações lineares das variáveis originais, são mutuamente ortogonais e aparecem em ordem decrescente de variância.
Definição 4.1 (Componentes principais) Dado um vetor aleatório \(p\)-dimensional \(\boldsymbol{x}= (X_1, \dots, X_p)^{T}\), com matriz de covariância \(\boldsymbol{\Sigma}\), os componentes principais (CPs) são um novo sistema de coordenadas \(Y_1, \dots, Y_p\), tal que \[ \begin{aligned} Y_1 &= \boldsymbol{u}_1^{T} \boldsymbol{x}= u_{11}X_1 + u_{21}X_2 + \dots + u_{p1}X_p \\ Y_2 &= \boldsymbol{u}_2^{T} \boldsymbol{x}= u_{12}X_1 + u_{22}X_2 + \dots + u_{p2}X_p \\ &\vdots \\ Y_p &= \boldsymbol{u}_p^{T} \boldsymbol{x}= u_{1p}X_1 + u_{2p}X_2 + \dots + u_{pp}X_p \end{aligned} \]
Em forma matricial, podemos escrever \(\boldsymbol{y} = \boldsymbol{U}^{T}\boldsymbol{x}\), em que \(\boldsymbol{y} = (Y_1, \dots, Y_p)^{T}\) e as colunas da matriz \(\boldsymbol{U} = [\boldsymbol{u}_1\ \boldsymbol{u}_2\ \cdots\ \boldsymbol{u}_p]\) definem as direções das novas coordenadas. Os CPs satisfazem duas propriedades:
- São não correlacionados entre si, isto é, \(\operatorname{Cov}\left(Y_k,Y_l\right) = 0\) para todo \(k \neq l\).
- Suas variâncias são decrescentes: \(\operatorname{Var}\left(Y_1\right) \ge \operatorname{Var}\left(Y_2\right) \ge \dots \ge \operatorname{Var}\left(Y_p\right)\).
Essa mudança de coordenadas pode ter dois propósitos relacionados: descrever a estrutura de dependência entre as variáveis e/ou reduzir a dimensionalidade. Frequentemente, a ACP é uma ferramenta intermediária em uma análise. Isso porque muitas vezes a análise dos dados observados no novo sistema de coordenadas é mais conveniente.
Exemplo 4.1 Suponha que estamos estudando o atraso até o destino de dois ônibus municipais. Sejam \(X_1\) e \(X_2\) os atrasos dos dois ônibus, com \(\boldsymbol{x} = (X_1, X_2)^T \sim N_2(\boldsymbol{0}, \boldsymbol{\Sigma})\), onde
\[ \boldsymbol{\Sigma}= \begin{bmatrix} 1,0 & 0,7 \\ 0,7 & 1,0 \end{bmatrix} \]
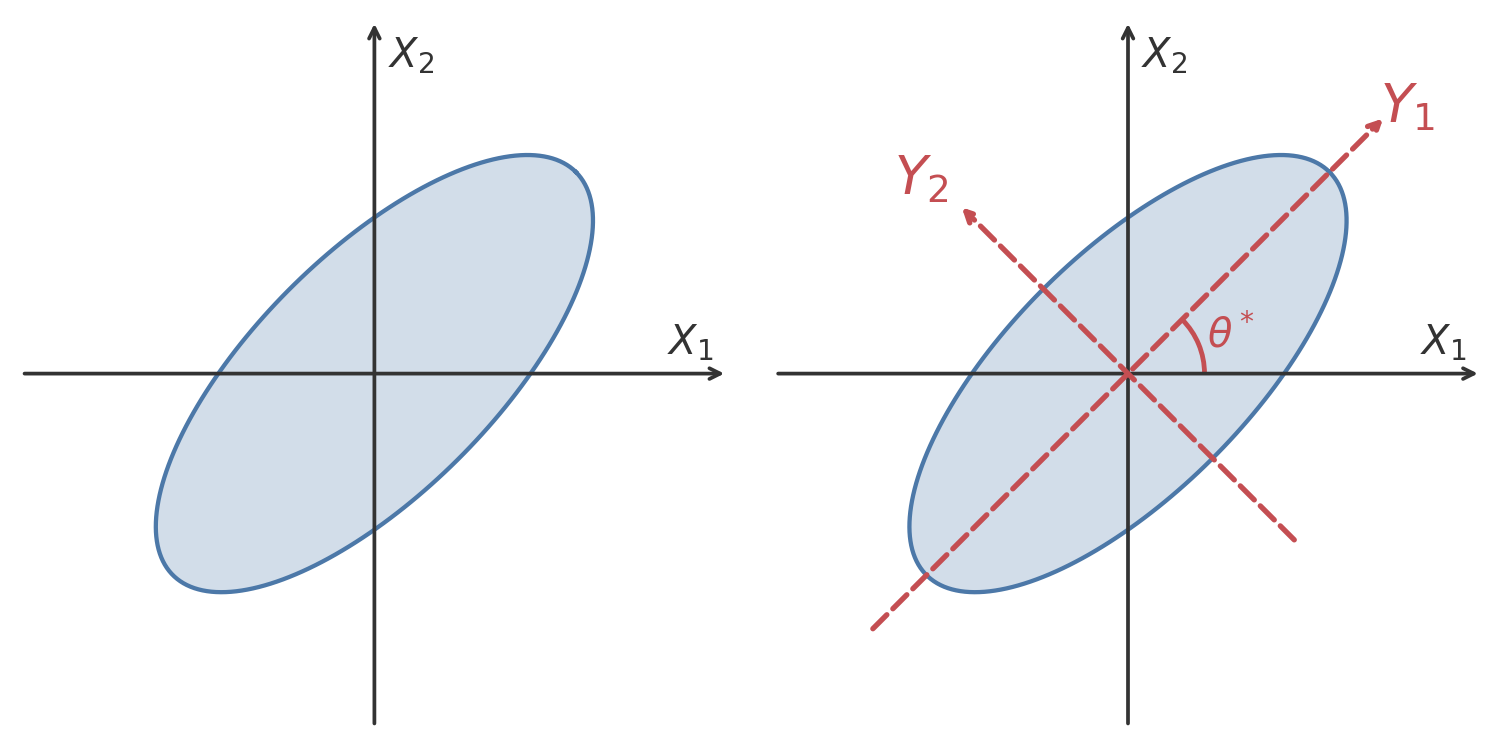
Ou seja, os atrasos médios são zero, os dois atrasos têm a mesma variância populacional, e a alta covariância indica atrasos conjuntos, que podem ser explicados por más condições de trânsito na cidade. A Figura 4.1 (esquerda) mostra uma elipse de concentração dessa distribuição, ou seja, o conjunto de pontos \(\boldsymbol{x}\) que satisfazem \(\boldsymbol{x}^{T}\boldsymbol{\Sigma}^{-1}\boldsymbol{x}= c^2\), para uma constante \(c\) qualquer, fixada apenas para fins de visualização.
Os eixos \(X_1\) e \(X_2\) são perfeitamente válidos, mas não acompanham a orientação principal da elipse. A posição da elipse indica que a dispersão é muito maior ao longo de uma direção diagonal. Ao longo desse capítulo, vamos propor e justificar o uso de novos eixos que acompanhem a direção de maior dispersão dos dados, representadas na Figura 4.1 (direita), os chamados componentes principais.
4.1 Variância como medida de informação
Em estatística, a variância é frequentemente usada como uma medida de informação. Uma variável com alta variância indica que seus valores são bem espalhados, o que nos ajuda a diferenciar as observações. Em um caso extremo, se uma variável tiver variância zero, todas as observações seriam idênticas, ou seja, não teríamos informação útil sobre elas.
Definição 4.2 (Variância total) A variância total de um conjunto de dados com \(p\) variáveis é a soma das variâncias de cada variável individual. Matematicamente, se \(\boldsymbol{x}= (X_1, \dots, X_p)^{T}\) é o vetor de variáveis aleatórias com matriz de covariâncias \(\boldsymbol{\Sigma}\), a variância total é definida como:
\[ \text{Variância Total} = \sum_{j=1}^{p} \operatorname{Var}\left(X_j\right) = \sum_{j=1}^{p} \sigma_{jj} = \operatorname{tr}\left(\boldsymbol{\Sigma}\right) \]
onde \(\sigma_{jj}\) é a variância da \(j\)-ésima variável e \(\operatorname{tr}\left(\boldsymbol{\Sigma}\right)\) é o traço da matriz de covariâncias. Essa medida representa a dispersão total na nuvem de pontos, somando a variabilidade em cada uma das direções dos eixos originais.
Exemplo 4.2 (Interpretação e solução geométrica) Retomando o Exemplo 4.1, a Figura 4.1 (direita) mostra que a busca pelo eixo mais informativo \(Y_1\) pode ser traduzida na busca por um ângulo ideal \(\theta^*\) que define uma rotação do eixo original \(X_1\). Para um ângulo \(\theta\) qualquer, a rotação pode ser expressa pela matriz de rotação
\[ \begin{bmatrix} \boldsymbol{u}_1(\theta) & \boldsymbol{u}_2(\theta) \end{bmatrix} = \begin{bmatrix} \cos\theta & -\sin\theta\\ \sin\theta & \phantom{-}\cos\theta \end{bmatrix} \]
cujas colunas \(\boldsymbol{u}_1(\theta),\, \boldsymbol{u}_2(\theta)\) formam uma base ortonormal, o que garante que as direções \(Y_1\) e \(Y_2\) sejam perpendiculares entre si. As coordenadas dos dados originais nesse sistema são
\[ \begin{aligned} Y_1 &= \boldsymbol{u}_1(\theta)^{T}\boldsymbol{x} =\cos(\theta)X_1+\sin(\theta)X_2 \\ Y_2 &= \boldsymbol{u}_2(\theta)^{T}\boldsymbol{x} =-\sin(\theta)X_1+\cos(\theta)X_2 \end{aligned} \]
Ainda não sabemos como obter o ângulo ideal \(\theta^*\). Podemos, entretanto, formular precisamente o que significa alinhar o primeiro eixo com a maior dispersão. A variância da coordenada \(Y_1\) é
\[ \begin{aligned} \operatorname{Var}\left(Y_1\right) &= \operatorname{Var}\left(\boldsymbol{u}_1(\theta)^{T}\boldsymbol{x}\right) \\ &= \boldsymbol{u}_1(\theta)^{T}\boldsymbol{\Sigma}\boldsymbol{u}_1(\theta) \\ &= \begin{bmatrix} \cos\theta & \sin\theta \end{bmatrix} \begin{bmatrix} 1,0 & 0,7 \\ 0,7 & 1,0 \end{bmatrix} \begin{bmatrix} \cos\theta \\ \sin\theta \end{bmatrix} \\ &= \cos^2\theta + 1,4\sin\theta\cos\theta + \sin^2\theta \\ \end{aligned} \]
Portanto, a variância do primeiro eixo é uma função do ângulo \(\theta\). A ACP escolhe a rotação que maximiza essa função. Nesse exemplo simples, podemos observar isso graficamente. A Figura 4.2 ilustra a solução.
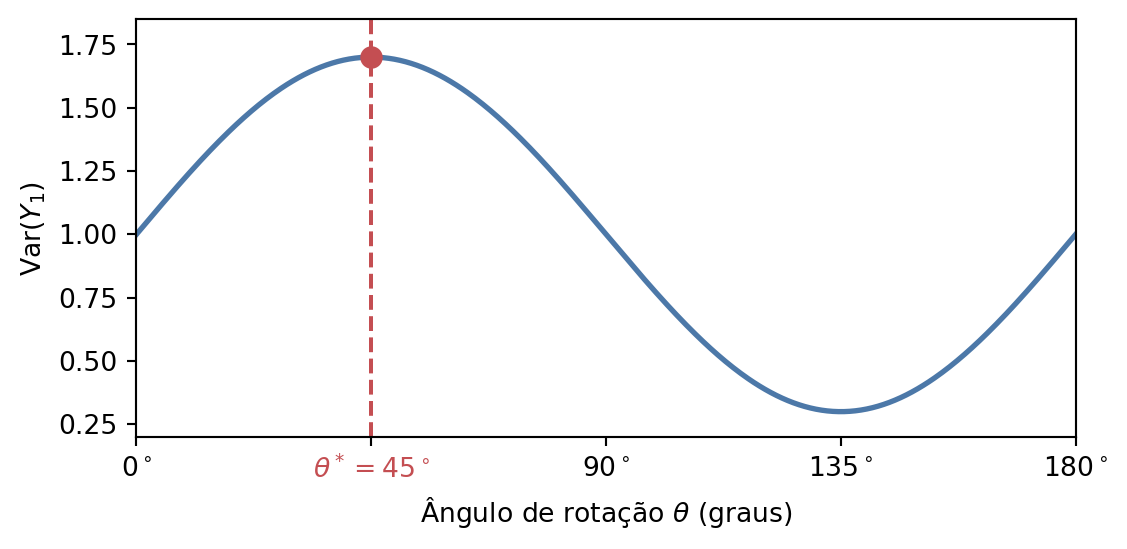
A figura mostra que o ângulo ideal é \(\theta^*=45.0°\), com esse ângulo, temos \(\operatorname{Var}\left(Y_1\right) = \cos^2(45^\circ) + 1,4\sin(45^\circ)\cos(45^\circ) + \sin^2(45^\circ) = 1.7\). As variâncias dos atrasos nos eixos originais, por sua vez, são \(\operatorname{Var}\left(X_1\right) = 1,0\) e \(\operatorname{Var}\left(X_2\right) = 1,0\), de modo que a variância total é \(\operatorname{tr}\left(\boldsymbol{\Sigma}\right) = 2,0\).
Note que \(Y_1\) possui uma variância superior a \(X_1\) e \(X_2\). A variância residual é \(2,0\) - \(1,7\) = \(0,3\). É aqui que introduzimos o segundo novo eixo \(Y_2\). Ele é perpendicular a \(Y_1\) e captura essa variância residual, de modo que \(\operatorname{Var}\left(Y_2\right) = 0,3\). Fica claro como os novos eixos \(Y_1\) e \(Y_2\) definem um par de coordenadas que redistribui a variabilidade. O primeiro eixo \(Y_1\) captura a maior parte da informação, enquanto o segundo \(Y_2\) captura a variância residual.
Enquanto essa solução geométrica é intuitiva em duas dimensões, ela não se estende de maneira conveniente a dezenas ou centenas de variáveis. Em breve, veremos como a solução analítica, baseada em autovalores, resolve o problema de forma geral.
4.2 Centralização e escalonamento
Importante
Antes de aplicar a ACP, precisamos centralizar e avaliar a necessidade de escalonar as variáveis.
Centralização. A ACP busca eixos que descrevam a dispersão interna dos dados em torno do seu centro de massa \(\boldsymbol{\mu}= \operatorname{E}\left[\boldsymbol{x}\right]\). Geometricamente, no entanto, os novos eixos lineares são subespaços vetoriais que obrigatoriamente passam pela origem \((0, \dots, 0)\).
Se os dados estiverem distantes da origem e não forem centralizados, a direção de maior magnitude a partir do zero não refletirá o formato da nuvem, mas apenas a posição do seu centro de massa. Em termos matemáticos, a magnitude quadrática média de uma projeção \(Y = \boldsymbol{u}^{T}\boldsymbol{x}\) em relação à origem decompõe-se em:
\[ \operatorname{E}\left[Y^{2}\right] = \operatorname{Var}\left(\boldsymbol{u}^{T}\boldsymbol{x}\right) + (\boldsymbol{u}^{T}\boldsymbol{\mu})^{2} \]
A primeira parcela, \(\operatorname{Var}\left(\boldsymbol{u}^{T}\boldsymbol{x}\right)\), mede a dispersão real dos dados em torno da média, enquanto a segunda, \((\boldsymbol{u}^{T}\boldsymbol{\mu})^{2}\), mede a distância da origem até a média ao longo da direção \(\boldsymbol{u}\). Se a média \(\boldsymbol{\mu}\) for grande em relação à variabilidade interna, esse segundo termo dominará o cálculo. Com isso, o primeiro eixo resultante apenas ligará a origem ao centro da nuvem, ignorando a verdadeira estrutura de variabilidade dos dados.
Ao centralizarmos o vetor aleatório fazendo \(\boldsymbol{x}- \boldsymbol{\mu}\), garantimos que o centro da nuvem coincida com a origem (\(\operatorname{E}\left[\boldsymbol{x}- \boldsymbol{\mu}\right] = \boldsymbol{0}\)). O termo \((\boldsymbol{u}^{T}\boldsymbol{\mu})^{2}\) desaparece e a análise passa a depender exclusivamente da matriz de covariâncias \(\boldsymbol{\Sigma}\), tornando a ACP invariante a translações. Por conveniência, assumimos daqui em diante que \(\boldsymbol{x}\) já representa o vetor centralizado, com média zero.
Escalonamento. A variância depende diretamente da unidade de medida. Imagine que registramos o atraso de um transporte: medido em horas, a variância pode ser \(1\); se medirmos o mesmo atraso em minutos, a variância salta para \(1 \times 60^2 = 3600\). O fenômeno observado não se tornou mais informativo por ter sido medido em minutos, mas a sua variância numérica explodiu. A ACP, por buscar a direção de maior variabilidade, privilegiaria essa variância artificialmente inflada pela unidade de medida.
Para evitar esse efeito, quando as variáveis possuem unidades distintas ou ordens de grandeza incomparáveis, padronizamos cada uma delas dividindo-a por seu desvio padrão. Todas as variáveis passam a ter variância 1 e tornam-se adimensionais. Com \(\boldsymbol{D}\) a matriz diagonal dos desvios padrão (introduzida em Definição 1.4), a transformação de padronização é \(\boldsymbol{D}^{-1}(\boldsymbol{x}-\boldsymbol{\mu})\). A matriz de variâncias e covariâncias desse vetor de variáveis padronizadas é precisamente a matriz de correlações \(\boldsymbol{\rho}\) de \(\boldsymbol{x}\).
Ou seja, aplicar a ACP sobre as variáveis padronizadas equivale a realizar a decomposição sobre a matriz de correlações \(\boldsymbol{\rho}\), em vez da matriz de covariâncias \(\boldsymbol{\Sigma}\). Quando as variáveis já compartilham a mesma unidade e suas diferenças de dispersão são relevantes, as escalas originais devem ser mantidas.
4.3 Solução dos componentes principais
Para encontrar o primeiro componente principal, partimos da combinação linear \(Y_1 = \boldsymbol{u}_1^{T}\boldsymbol{x}\), em que \(\boldsymbol{u}_1\) é, por enquanto, apenas uma direção candidata. Sua variância é \(\operatorname{Var}\left(Y_1\right) = \operatorname{Var}\left(\boldsymbol{u}_1^{T}\boldsymbol{x}\right) = \boldsymbol{u}_1^{T} \boldsymbol{\Sigma}\boldsymbol{u}_1\), onde \(\boldsymbol{\Sigma}\) é a matriz de covariâncias de \(\boldsymbol{x}\).
Para evitar que a variância seja aumentada simplesmente inflando os coeficientes em \(\boldsymbol{u}_1\), impomos a restrição de que seu comprimento seja unitário, \(\boldsymbol{u}_1^{T}\boldsymbol{u}_1 = 1\). Formalmente, o problema de maximização para o primeiro componente principal se torna:
\[ \begin{aligned} \max_{\boldsymbol{u}_1} \quad & \boldsymbol{u}_1^{T} \boldsymbol{\Sigma}\boldsymbol{u}_1 \\ \text{sujeito a} \quad & \boldsymbol{u}_1^{T} \boldsymbol{u}_1 = 1 \end{aligned} \]
Utilizando o método dos multiplicadores de Lagrange, a função a ser maximizada é:
\[ L(\boldsymbol{u}_1, \lambda_1) = \boldsymbol{u}_1^{T} \boldsymbol{\Sigma}\boldsymbol{u}_1 - \lambda_1 (\boldsymbol{u}_1^{T} \boldsymbol{u}_1 - 1) \]
Derivando em relação a \(\boldsymbol{u}_1\) e igualando a zero, obtemos:
\[ \frac{\partial L}{\partial \boldsymbol{u}_1} = 2 \boldsymbol{\Sigma}\boldsymbol{u}_1 - 2 \lambda_1 \boldsymbol{u}_1 = 0 \implies \boldsymbol{\Sigma}\boldsymbol{u}_1 = \lambda_1 \boldsymbol{u}_1 \]
Chegamos à equação de autovalores e autovetores. A direção candidata \(\boldsymbol{u}_1\) que resolve o problema deve ser um autovetor da matriz de covariâncias \(\boldsymbol{\Sigma}\). Para encontrar a variância, multiplicamos a equação à esquerda por \(\boldsymbol{u}_1^{T}\):
\[ \boldsymbol{u}_1^{T} \boldsymbol{\Sigma}\boldsymbol{u}_1 = \lambda_1 \boldsymbol{u}_1^{T} \boldsymbol{u}_1 \]
Como \(\operatorname{Var}\left(Y_1\right) = \boldsymbol{u}_1^{T} \boldsymbol{\Sigma}\boldsymbol{u}_1\) e a restrição é \(\boldsymbol{u}_1^{T} \boldsymbol{u}_1 = 1\), temos:
\[ \operatorname{Var}\left(Y_1\right) = \lambda_1 \]
Para maximizar a variância de \(Y_1\), devemos escolher o maior autovalor possível. Portanto, \(\lambda_1\) é o maior autovalor de \(\boldsymbol{\Sigma}\). Denotamos por \(\boldsymbol{e}_1\) um autovetor unitário associado a \(\lambda_1\); na solução do problema, a direção candidata se torna \(\boldsymbol{u}_1 = \boldsymbol{e}_1\).
Nota
A matriz de covariâncias \(\boldsymbol{\Sigma}\) é, por construção, simétrica e positiva semidefinida. Conforme discutido em Teorema 2.1, o Teorema Espectral garante que seus autovalores são reais e não negativos e que existe uma base ortonormal de autovetores.
Para obter o segundo componente, consideramos uma nova direção candidata \(\boldsymbol{u}_2\) e escrevemos \(Y_2 = \boldsymbol{u}_2^{T}\boldsymbol{x}\). Como \(\boldsymbol{e}_1\) já determina a direção de maior variância, exigimos que \(\boldsymbol{u}_2\) tenha comprimento unitário e seja ortogonal a \(\boldsymbol{e}_1\). Essa ortogonalidade também garante que os componentes sejam não correlacionados: \(\operatorname{Cov}\left(Y_1,Y_2\right) = \boldsymbol{e}_1^{T}\boldsymbol{\Sigma}\boldsymbol{u}_2 = \lambda_1\boldsymbol{e}_1^{T}\boldsymbol{u}_2 = 0\). Assim, o segundo problema de otimização é
\[ \begin{aligned} \max_{\boldsymbol{u}_2} \quad & \boldsymbol{u}_2^{T} \boldsymbol{\Sigma}\boldsymbol{u}_2 \\ \text{sujeito a} \quad & \begin{cases} \boldsymbol{u}_2^{T} \boldsymbol{u}_2 = 1 \\ \boldsymbol{e}_1^{T} \boldsymbol{u}_2 = 0 \end{cases} \end{aligned} \]
A restrição de ortogonalidade introduz um segundo multiplicador de Lagrange, \(\phi\). A função Lagrangiana e sua derivada são
\[ \begin{aligned} L(\boldsymbol{u}_2, \lambda_2, \phi) &= \boldsymbol{u}_2^{T}\boldsymbol{\Sigma}\boldsymbol{u}_2 - \lambda_2(\boldsymbol{u}_2^{T}\boldsymbol{u}_2 - 1) - \phi\boldsymbol{e}_1^{T}\boldsymbol{u}_2 \\ \frac{\partial L}{\partial \boldsymbol{u}_2} &= 2\boldsymbol{\Sigma}\boldsymbol{u}_2 - 2\lambda_2\boldsymbol{u}_2 - \phi\boldsymbol{e}_1 = \boldsymbol{0} \end{aligned} \]
Pré-multiplicamos a derivada por \(\boldsymbol{e}_1^{T}\). Como \(\boldsymbol{e}_1^{T}\boldsymbol{\Sigma}= \lambda_1\boldsymbol{e}_1^{T}\), \(\boldsymbol{e}_1^{T}\boldsymbol{u}_2 = 0\) e \(\boldsymbol{e}_1^{T}\boldsymbol{e}_1 = 1\), obtemos
\[ \begin{aligned} 0 &= 2\boldsymbol{e}_1^{T}\boldsymbol{\Sigma}\boldsymbol{u}_2 - 2\lambda_2\boldsymbol{e}_1^{T}\boldsymbol{u}_2 - \phi\boldsymbol{e}_1^{T}\boldsymbol{e}_1 \\ &= 2\lambda_1\boldsymbol{e}_1^{T}\boldsymbol{u}_2 - 2\lambda_2\boldsymbol{e}_1^{T}\boldsymbol{u}_2 - \phi \\ &= -\phi \end{aligned} \]
Logo, \(\phi=0\), e a derivada se reduz a \(\boldsymbol{\Sigma}\boldsymbol{u}_2 = \lambda_2\boldsymbol{u}_2\). A segunda direção também deve, portanto, ser um autovetor de \(\boldsymbol{\Sigma}\). Entre os autovetores ortogonais a \(\boldsymbol{e}_1\), a maior variância disponível é o segundo maior autovalor, \(\lambda_2\). Denotando o autovetor unitário correspondente por \(\boldsymbol{e}_2\), a solução é \(\boldsymbol{u}_2=\boldsymbol{e}_2\).
Este processo continua: o \(k\)-ésimo componente principal (\(Y_k\)) é definido pelo autovetor \(\boldsymbol{e}_k\) associado ao \(k\)-ésimo maior autovalor \(\lambda_k\), garantindo que \(\operatorname{Var}\left(Y_k\right) = \lambda_k\) e que todos os componentes sejam mutuamente não correlacionados.
A decomposição espectral reúne todos esses resultados de uma só vez. Na expressão \(\boldsymbol{\Sigma}= \boldsymbol{E}\boldsymbol{\Lambda}\boldsymbol{E}^{T}\), as colunas de \(\boldsymbol{E}\) são as direções dos componentes principais e os elementos da diagonal de \(\boldsymbol{\Lambda}\) são suas variâncias. Ordenando os autovalores do maior para o menor, obtemos simultaneamente todos os componentes principais na ordem desejada.
Nota
A dedução por multiplicadores de Lagrange é direta e estende-se naturalmente aos componentes seguintes. Outra abordagem clássica restringe a norma de \(\boldsymbol{u}_1\) através do quociente,
\[ \operatorname{Var}\left(Y_1\right) = \max_{\boldsymbol{u}_1} \frac{\boldsymbol{u}_1^{T} \boldsymbol{\Sigma}\boldsymbol{u}_1}{\boldsymbol{u}_1^{T} \boldsymbol{u}_1} \]
Trata-se do quociente de Rayleigh. Para qualquer matriz simétrica \(\boldsymbol{A}\), o máximo da forma quadrática \(\boldsymbol{x}^{T} \boldsymbol{A} \boldsymbol{x}\), sujeito a \(\boldsymbol{x}^{T} \boldsymbol{x}= 1\), coincide com o maior autovalor de \(\boldsymbol{A}\), e o vetor que atinge esse máximo é o autovetor associado. Como a matriz de covariâncias \(\boldsymbol{\Sigma}\) é simétrica, o resultado se aplica diretamente ao nosso problema.
Proposição 4.1 (Conservação da variância total) Se \(Y_1,\dots,Y_p\) são todos os componentes principais de \(\boldsymbol{x}\), então a soma de suas variâncias é igual à variância total das variáveis originais:
\[ \sum_{k=1}^p \operatorname{Var}\left(Y_k\right)=\sum_{j=1}^p \operatorname{Var}\left(X_j\right) \]
Prova. Pela Definição 4.2, a variância total das variáveis originais é \(\operatorname{tr}\left(\boldsymbol{\Sigma}\right)\). Usando a decomposição espectral \(\boldsymbol{\Sigma}=\boldsymbol{E}\boldsymbol{\Lambda}\boldsymbol{E}^{T}\), as propriedades do traço, a ortogonalidade de \(\boldsymbol{E}\) e o fato de que \(\operatorname{Var}\left(Y_k\right)=\lambda_k\), obtemos
\[ \begin{aligned} \sum_{j=1}^p \operatorname{Var}\left(X_j\right) &= \operatorname{tr}\left(\boldsymbol{\Sigma}\right) \\ &= \operatorname{tr}\left(\boldsymbol{E}\boldsymbol{\Lambda}\boldsymbol{E}^{T}\right) \\ &= \operatorname{tr}\left(\boldsymbol{\Lambda}\boldsymbol{E}^{T}\boldsymbol{E}\right) \\ &= \operatorname{tr}\left(\boldsymbol{\Lambda}\right) \\ &= \sum_{k=1}^p \lambda_k \\ &= \sum_{k=1}^p \operatorname{Var}\left(Y_k\right) \end{aligned} \]
Portanto, a ACP não cria nem elimina variabilidade; ela apenas a redistribui entre os componentes principais.
A Proposição 4.1 mostra que a soma das variâncias dos componentes principais é sempre igual à variância total das variáveis originais. Essa quantidade é fixa, mas como ela se distribui entre os componentes depende diretamente da estrutura de correlação entre as variáveis originais. Quando as variáveis estão fortemente correlacionadas, essa distribuição tende a ser desigual: um ou dois autovalores concentram a maior parte da variância, e os componentes seguintes têm papel secundário. É esse o cenário do Exemplo 4.1, em que a correlação de 0,7 alonga a elipse de concentração ao longo de uma direção, permitindo que \(Y_1\) sozinho capture a maior parte da informação.
No outro extremo, se as variáveis originais são pouco ou nada correlacionadas, essa distribuição tende a se tornar mais uniforme entre os componentes. No caso limite de variáveis não correlacionadas e com a mesma variância, a elipse de concentração se torna um círculo, e nenhuma direção acumula mais variância do que outra. A ACP deixa de trazer qualquer utilidade nesse caso.
4.4 Interpretação dos componentes
As colunas da matriz \(\boldsymbol{E} = [\boldsymbol{e}_1\ \boldsymbol{e}_2\ \cdots\ \boldsymbol{e}_p]\) contêm os coeficientes que definem os componentes principais. O elemento \(e_{jk}\) (linha \(j\), coluna \(k\)) é frequentemente chamado de carga (loading) e indica o peso da variável original \(X_j\) na formação do componente \(Y_k\). A magnitude de \(e_{jk}\) reflete a importância relativa da variável \(j\) no componente \(k\), mas a comparação direta desses coeficientes é dificultada quando as variáveis possuem unidades e variâncias distintas.
Uma medida mais interpretável e padronizada é a correlação entre as variáveis originais e os componentes principais, \(\operatorname{Corr}\left(X_j, Y_k\right)\). Ela indica o quanto cada variável original está linearmente associada a cada componente, numa escala de \(-1\) a \(1\).
Proposição 4.2 (Correlação entre variáveis originais e componentes principais) Seja \(\boldsymbol{y} = \boldsymbol{E}^{T}\boldsymbol{x}\) o vetor com todos os componentes principais de \(\boldsymbol{x}\), com \(\lambda_k > 0\) e \(\sigma_{jj} = \operatorname{Var}\left(X_j\right) > 0\) para todos \(j\) e \(k\). Então
\[ \operatorname{Corr}\left(X_j, Y_k\right) = \frac{e_{jk}\sqrt{\lambda_k}}{\sqrt{\sigma_{jj}}} \]
ou, reunindo todas as correlações em uma única matriz,
\[ \operatorname{Corr}\left(\boldsymbol{x}, \boldsymbol{y}\right) = \boldsymbol{D}^{-1}\boldsymbol{E}\boldsymbol{\Lambda}^{1/2} \]
em que \(\boldsymbol{D} = \operatorname{diag}\left(\sqrt{\sigma_{11}}, \dots, \sqrt{\sigma_{pp}}\right)\) é a matriz diagonal dos desvios padrão de \(\boldsymbol{x}\).
Prova. Todas as covariâncias entre as variáveis originais e os componentes saem de uma única conta. Usando a decomposição espectral \(\boldsymbol{\Sigma}= \boldsymbol{E}\boldsymbol{\Lambda}\boldsymbol{E}^{T}\) e a ortogonalidade de \(\boldsymbol{E}\),
\[ \operatorname{Cov}\left(\boldsymbol{x}, \boldsymbol{y}\right) = \operatorname{Cov}\left(\boldsymbol{x}, \boldsymbol{E}^{T}\boldsymbol{x}\right) = \boldsymbol{\Sigma}\boldsymbol{E} = \boldsymbol{E}\boldsymbol{\Lambda} \]
O elemento \((j,k)\) dessa matriz é \(\operatorname{Cov}\left(X_j, Y_k\right) = \lambda_k e_{jk}\). Como \(\operatorname{Var}\left(X_j\right) = \sigma_{jj}\) e \(\operatorname{Var}\left(Y_k\right) = \lambda_k\), basta padronizar:
\[ \operatorname{Corr}\left(X_j, Y_k\right) = \frac{\operatorname{Cov}\left(X_j, Y_k\right)}{\sqrt{\operatorname{Var}\left(X_j\right)}\sqrt{\operatorname{Var}\left(Y_k\right)}} = \frac{\lambda_k e_{jk}}{\sqrt{\sigma_{jj}}\sqrt{\lambda_k}} = \frac{e_{jk}\sqrt{\lambda_k}}{\sqrt{\sigma_{jj}}} \]
Essa padronização, feita de uma vez para toda a matriz, corresponde a dividir cada linha \(j\) por \(\sqrt{\sigma_{jj}}\) e cada coluna \(k\) por \(\sqrt{\lambda_k}\), isto é, a multiplicar \(\boldsymbol{E}\boldsymbol{\Lambda}\) por \(\boldsymbol{D}^{-1}\) à esquerda e por \(\boldsymbol{\Lambda}^{-1/2}\) à direita:
\[ \operatorname{Corr}\left(\boldsymbol{x}, \boldsymbol{y}\right) = \boldsymbol{D}^{-1}\boldsymbol{E}\boldsymbol{\Lambda}\boldsymbol{\Lambda}^{-1/2} = \boldsymbol{D}^{-1}\boldsymbol{E}\boldsymbol{\Lambda}^{1/2} \]
Na prática, é essa matriz que se olha para nomear os componentes: a coluna \(k\) de \(\boldsymbol{D}^{-1}\boldsymbol{E}\boldsymbol{\Lambda}^{1/2}\) diz, em uma escala comum a todas as variáveis, quais delas \(Y_k\) de fato resume.
4.5 Componentes principais amostrais
Toda a derivação anterior foi formulada em termos populacionais, supondo conhecidos a matriz de covariâncias \(\boldsymbol{\Sigma}\) e seus autovalores e autovetores. Foi exatamente essa hipótese que nos permitiu desenhar a elipse de concentração exata do Exemplo 4.1. Na prática, onde não conhecemos \(\boldsymbol{\Sigma}\), observamos uma amostra de indivíduos e precisamos estimar essa estrutura a partir dela.
A solução para esse caso é simples: substituímos \(\boldsymbol{\Sigma}\) pela matriz de covariâncias amostral \(\boldsymbol{S}\). Os componentes principais são obtidos da mesma maneira, decompondo a matriz de covariâncias (ou a matriz de correlações no caso padronizado) amostral e as quantidades resultantes são estimativas de seus análogos populacionais:
- O \(k\)-ésimo autovalor amostral, \(\hat{\lambda}_k\), é uma estimativa de \(\lambda_k\).
- O \(k\)-ésimo autovetor amostral, \(\hat{\boldsymbol{e}}_k\), é uma estimativa de \(\boldsymbol{e}_k\).
- O \(k\)-ésimo componente principal amostral, \(\hat{Y}_k = \hat{\boldsymbol{e}}_k^{T} \boldsymbol{x}\), é uma estimativa de \(Y_k\).
A teoria e a interpretação permanecem as mesmas. Para simplificar a notação, omitimos o circunflexo ao longo deste capítulo, lembrando que na prática lidamos sempre com estimativas amostrais.
Exemplo 4.3 (Uma amostra da população) Retomamos o exemplo dos atrasos Exemplo 4.1, mas agora assumindo \(\boldsymbol{\Sigma}\) desconhecido. Observamos uma amostra de \(n=160\) viagens para cada ônibus. A Figura 4.3 (esquerda) mostra a nuvem desses 160 pontos nos eixos originais \(X_1\) e \(X_2\). Como não conhecemos \(\boldsymbol{\Sigma}\), calculamos a matriz de covariâncias amostral \(\boldsymbol{S}\) e a decompomos para estimar os eixos dos componentes principais, \(\hat{\boldsymbol{e}}_1\) e \(\hat{\boldsymbol{e}}_2\); a Figura 4.3 (direita) mostra esses eixos estimados.
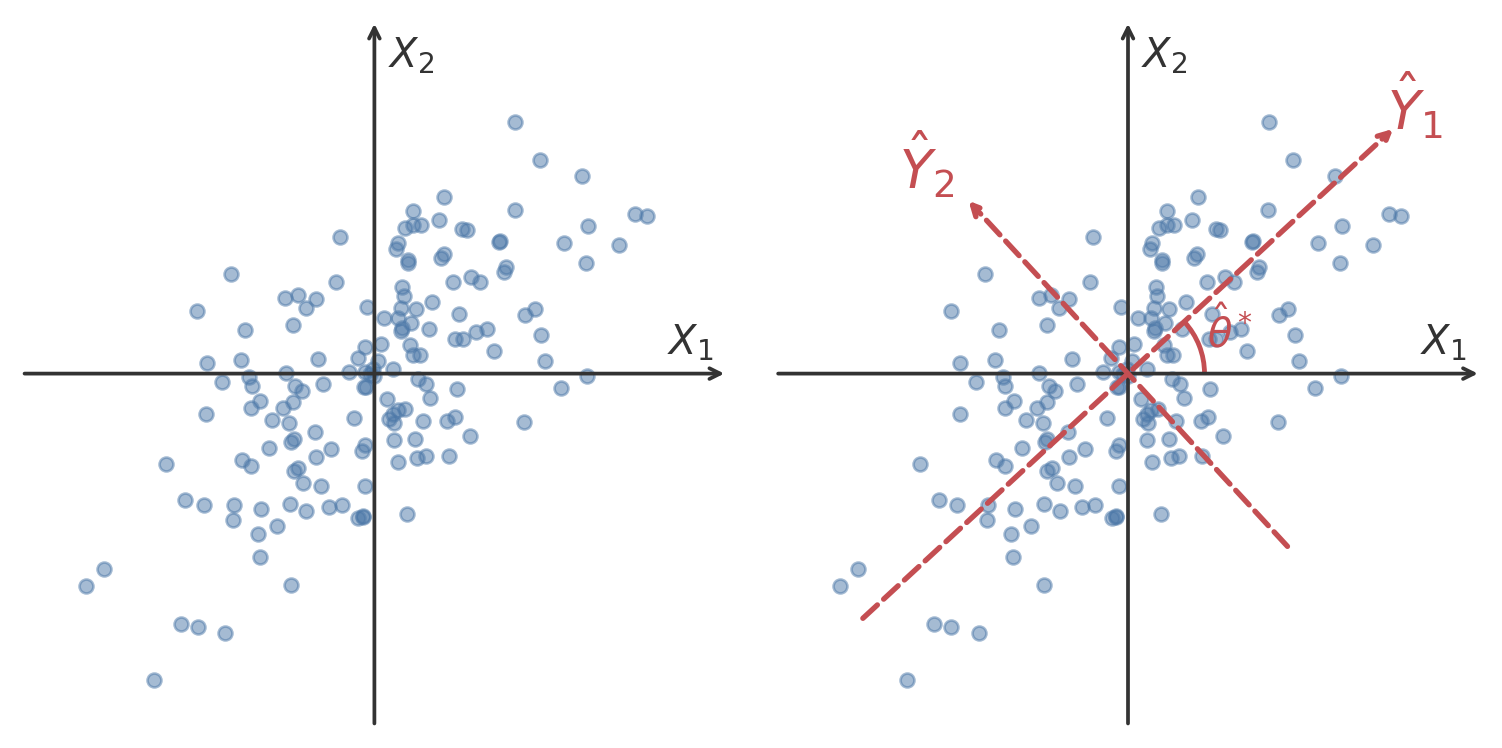
A interpretação geométrica da ACP não muda, ainda buscamos os eixos que maximizam a variância, mas agora segundo a amostra, ou seja, seguimos a direção de maior dispersão da nuvem de pontos. Nesse caso, poderíamos fazer uma estimativa do ângulo ideal de rotação \(\theta^*\). Para esses dados gerados, temos \(\hat\theta^*\approx 42.7°\). O valor é próximo, mas não idêntico, ao ângulo populacional exato do Exemplo 4.1.
4.6 Escores
Até agora, tratamos os componentes principais como direções, vetores \(\boldsymbol{e}_1, \dots, \boldsymbol{e}_p\) que definem o novo sistema de eixos. Quando o interesse está em reduzir a dimensionalidade dos dados ou em representar graficamente as observações nesse novo sistema, precisamos também calcular a posição de cada indivíduo da amostra ao longo de cada novo eixo.
Definição 4.3 (Matriz de escores) Dada a matriz de dados centralizados \(\boldsymbol{X}\), de dimensão \(n \times p\), e a matriz ortogonal de autovetores \(\boldsymbol{E} = [\boldsymbol{e}_1\ \boldsymbol{e}_2\ \cdots\ \boldsymbol{e}_p]\), a matriz de escores \(\boldsymbol{T}\), de dimensão \(n \times p\), é obtida pela projeção das observações no novo sistema de eixos:
\[ \boldsymbol{T} = \boldsymbol{X}\boldsymbol{E} = \begin{bmatrix} \boldsymbol{t}_1 & \boldsymbol{t}_2 & \cdots & \boldsymbol{t}_p \end{bmatrix} \]
em que cada coluna \(\boldsymbol{t}_k = \boldsymbol{X}\boldsymbol{e}_k\) (\(n \times 1\)) contém as coordenadas de todas as observações no \(k\)-ésimo componente principal \(Y_k\).
A matriz de escores \(\boldsymbol{T}\) representa os próprios dados originais reescritos no novo sistema de coordenadas: suas linhas continuam correspondendo às \(n\) observações, enquanto suas colunas correspondem aos componentes principais \(Y_1, \dots, Y_p\). Essa representação é a base para a redução de dimensionalidade e é utilizada diretamente na construção de gráficos de dispersão e em análises multivariadas subsequentes (como agrupamento ou classificação).
Para facilitar ainda mais a interpretação, existem representações visuais úteis para a ACP. A mais comum é o biplot. Ele combina os escores das observações nos componentes principais com vetores associados às variáveis originais. Assim, os pontos representam as observações, enquanto as setas mostram as direções em que as variáveis aumentam. Voltaremos ao biplot no Exemplo 4.6.
Exemplo 4.4 (Resolução manual) Para acompanhar como esses cálculos acontecem passo a passo a partir de uma matriz de dados, vamos resolver um exemplo inteiramente à mão, com uma amostra pequena cujos números foram escolhidos para simplificar as contas.
Suponha que observamos \(n = 5\) pares de valores já centralizados de duas variáveis, \(X_1\) e \(X_2\), organizados na matriz de dados \(\boldsymbol{X}\) (uma observação por linha):
\[ \boldsymbol{X}= \begin{bmatrix} -2 & -2 \\ -1 & 1 \\ 0 & 0 \\ 1 & -1 \\ 2 & 2 \end{bmatrix} \]
Matriz de covariâncias amostral. Como os dados já estão centralizados, a soma de cada coluna de \(\boldsymbol{X}\) é zero. As variâncias e a covariância amostrais são:
\[ s_{11} = \frac{\sum x_{i1}^2}{n-1} = \frac{10}{4} = 2.5, \qquad s_{22} = \frac{\sum x_{i2}^2}{n-1} = \frac{10}{4} = 2.5, \qquad s_{12} = \frac{\sum x_{i1}x_{i2}}{n-1} = \frac{6}{4} = 1.5 \]
A matriz de covariâncias amostral é, portanto,
\[ \boldsymbol{S}= \begin{bmatrix} 2.5 & 1.5 \\ 1.5 & 2.5 \end{bmatrix} \]
Neste exemplo, vamos assumir que \(X_1\) e \(X_2\) têm escalas comparáveis e, por isso, não padronizaremos os dados, ou seja, vamos aplicar a decomposição diretamente em \(\boldsymbol{S}\).
Autovalores e Autovetores. Resolvemos \(\det(\boldsymbol{S}- \lambda \boldsymbol{I}) = 0\):
\[ \det\begin{bmatrix} 2.5 - \lambda & 1.5 \\ 1.5 & 2.5 - \lambda \end{bmatrix} = (2.5-\lambda)^2 - 1.5^2 = \lambda^2 - 5\lambda + 4 = 0 \]
As raízes são os autovalores \(\lambda_1 = 4\) e \(\lambda_2 = 1\). Note que \(\lambda_1 + \lambda_2 = 5 = \operatorname{tr}\left(\boldsymbol{S}\right)\), como esperado.
Para cada autovalor, substituímos \(\lambda_k\) no sistema \((\boldsymbol{S}-\lambda_k\boldsymbol{I})\boldsymbol{e}_k=\boldsymbol{0}\). Os sistemas resultantes e uma solução unitária para cada um são
\[ \begin{aligned} \lambda_1 = 4: \quad &\begin{bmatrix}-1.5 & 1.5 \\ 1.5 & -1.5\end{bmatrix} \begin{bmatrix}e_{11}\\e_{21}\end{bmatrix} =\begin{bmatrix}0\\0\end{bmatrix} \implies -1.5e_{11}+1.5e_{21}=0 \implies e_{21}=e_{11} \\ &\text{Normalizando com } e_{11}^2 + e_{21}^2 = 1: \quad \boldsymbol{e}_1 = \frac{1}{\sqrt{2}}\begin{bmatrix}1\\1\end{bmatrix} \end{aligned} \]
\[ \begin{aligned} \lambda_2 = 1: \quad &\begin{bmatrix}1.5 & 1.5 \\ 1.5 & 1.5\end{bmatrix} \begin{bmatrix}e_{12}\\e_{22}\end{bmatrix} =\begin{bmatrix}0\\0\end{bmatrix} \implies 1.5e_{12}+1.5e_{22}=0 \implies e_{22}=-e_{12} \\ &\text{Normalizando com } e_{12}^2 + e_{22}^2 = 1: \quad \boldsymbol{e}_2 = \frac{1}{\sqrt{2}}\begin{bmatrix}1\\-1\end{bmatrix} \end{aligned} \]
Os autovetores \(\boldsymbol{e}_1\) e \(\boldsymbol{e}_2\) são ortogonais entre si (\(\boldsymbol{e}_1^T\boldsymbol{e}_2 = 0\)) e têm norma 1, formando a base do novo sistema de coordenadas.
Componentes principais. As combinações lineares que definem os novos eixos são
\[ \begin{aligned} Y_1 &= \frac{1}{\sqrt{2}} X_1 + \frac{1}{\sqrt{2}} X_2 \\ Y_2 &= \frac{1}{\sqrt{2}} X_1 - \frac{1}{\sqrt{2}} X_2 \end{aligned} \]
em que \(X_1\) e \(X_2\) representam as variáveis centralizadas.
Banco de dados transformado. Reunindo os autovetores em \(\boldsymbol{E}=[\boldsymbol{e}_1\ \boldsymbol{e}_2]\), obtemos a matriz de dados expressa no sistema de coordenadas dos componentes principais:
\[ \boldsymbol{T} = \boldsymbol{X}\boldsymbol{E} = \boldsymbol{X}\frac{1}{\sqrt{2}} \begin{bmatrix} 1 & 1 \\ 1 & -1 \end{bmatrix} = \frac{1}{\sqrt{2}} \begin{bmatrix} -4 & 0 \\ 0 & -2 \\ 0 & 0 \\ 0 & 2 \\ 4 & 0 \end{bmatrix} \]
As linhas de \(\boldsymbol{T}\) continuam representando as cinco observações, enquanto suas colunas agora correspondem aos escores em \(Y_1\) e \(Y_2\).
4.7 Redução de dimensão
A ACP expressa os dados em um sistema de eixos rotacionado. A Proposição 4.1 mostra que esse processo não perde nenhuma informação. Agora, quando o interesse é na redução de dimensionalidade, precisamos aceitar descartar parte da informação.
Na prática, escolhemos reter \(q < p\) componentes principais, descartando \(Y_{q+1}, \dots, Y_p\). As propriedades dos componentes principais garantem que esse descarte maximiza a informação preservada.
Para que essa redução seja adequada, é preciso escolher \(q\) cuidadosamente. Essa escolha envolve um compromisso: poucos componentes tornam a análise mais simples e fácil de interpretar, enquanto mais componentes preservam mais da variância original. Entre os critérios mais comuns para a escolha de \(q\), temos:
- O critério da variância explicada acumulada calcula a proporção da variância total explicada por cada componente e acumula essa proporção,
\[ \text{Proporção da Variância por } CP_k = \frac{\lambda_k}{\sum_{j=1}^{p} \lambda_j} \]
escolhendo o menor número de componentes \(q\) cuja variância explicada acumulada atinja um limiar satisfatório, geralmente entre 70% e 90%. A escolha do limiar depende do contexto da análise.
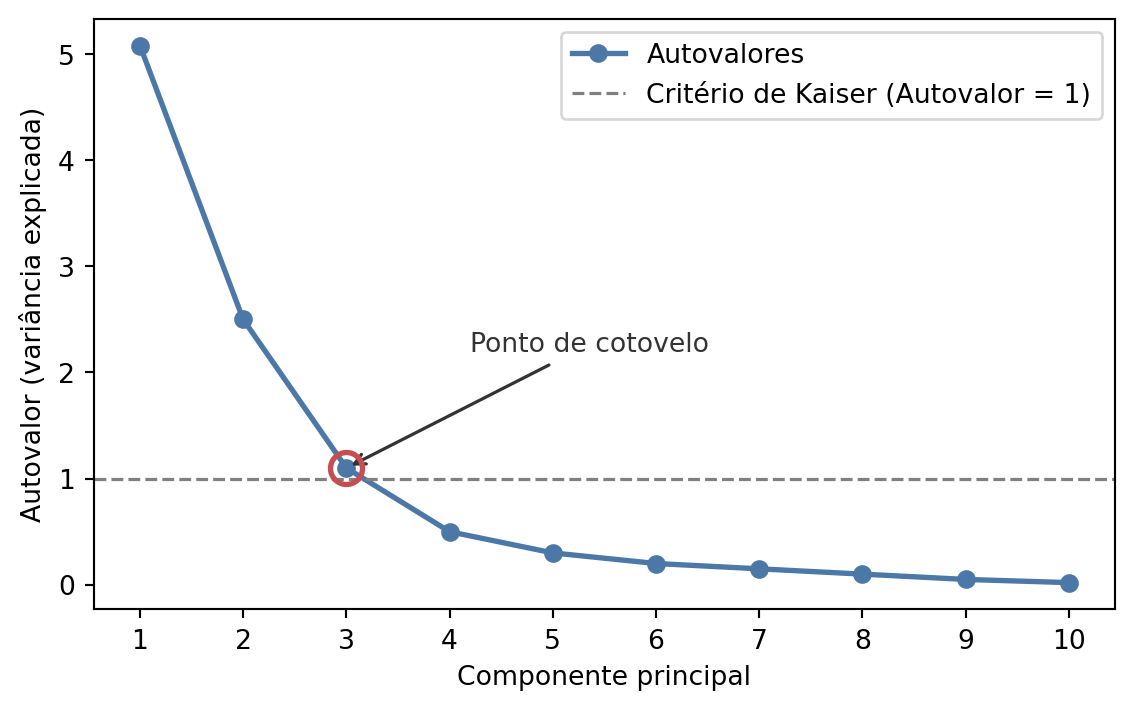
O critério do autovalor (ou critério de Kaiser), aplicável quando a ACP é baseada na matriz de correlações, sugere reter apenas os componentes cujos autovalores (\(\lambda_k\)) são maiores que 1. Nesse caso, as variáveis originais são padronizadas para ter variância 1, e um componente com autovalor menor que 1 está explicando menos variabilidade do que uma única variável original. Reter tal componente não traria uma “economia” de informação, tornando-o um candidato à exclusão.
O gráfico do cotovelo (ou scree plot), uma alternativa mais visual, ilustrado na Figura 4.4, mostra os autovalores em função do número de componentes principais, com um “cotovelo” indicando o ponto de corte. A ideia é reter os componentes que aparecem antes do cotovelo, pois eles concentram a maior parte da variância total.
4.8 Reconstrução e projeção ortogonal
A projeção dada pela ACP é reversível. Isto é, podemos reconstruir os dados originais a partir dos seus escores e autovetores. Como a matriz de autovetores \(\boldsymbol{E}\) é ortogonal, podemos multiplicar a matriz de escores \(\boldsymbol{T} = \boldsymbol{X}\boldsymbol{E}\) à direita por \(\boldsymbol{E}^T\) para recuperar perfeitamente os dados centralizados:
\[ \boldsymbol{X}= \boldsymbol{T}\boldsymbol{E}^T = \sum_{k=1}^p \boldsymbol{t}_k \boldsymbol{e}_k^T \]
Essa equação decompõe a matriz de dados em uma soma de \(p\) matrizes de posto um, onde cada termo \(\boldsymbol{t}_k \boldsymbol{e}_k^T\) representa a contribuição exclusiva do \(k\)-ésimo componente principal. Agora, quando reduzimos a dimensionalidade retendo apenas \(q < p\) componentes, a aproximação de posto \(q\) da matriz de dados centralizados é:
\[ \widehat{\boldsymbol{X}}_q = \boldsymbol{T}_q\boldsymbol{E}_q^T = \sum_{k=1}^q \boldsymbol{t}_k \boldsymbol{e}_k^T \]
onde \(\boldsymbol{T}_q = \boldsymbol{X}\boldsymbol{E}_q\) (\(n \times q\)) reúne os escores mantidos e \(\boldsymbol{E}_q = [\boldsymbol{e}_1\ \cdots\ \boldsymbol{e}_q]\) (\(p \times q\)) contém as respectivas direções principais. Pelo Teorema de Eckart-Young-Mirsky (Teorema 2.2), essa reconstrução \(\widehat{\boldsymbol{X}}_q\) é a melhor aproximação de posto \(q\) da matriz de dados centralizados segundo a norma de Frobenius.
Proposição 4.3 (Erro de reconstrução) Se \(\widehat{\boldsymbol{X}}_q\) é a aproximação de posto \(q\) da matriz de dados centralizados \(\boldsymbol{X}\), obtida pelos \(q\) primeiros componentes principais, então o erro quadrático de reconstrução normalizado equivale à soma dos autovalores dos componentes descartados:
\[ \frac{1}{n-1}\|\boldsymbol{X}- \widehat{\boldsymbol{X}}_q\|_F^2 = \sum_{k=q+1}^p \lambda_k \]
Prova. Como \(\boldsymbol{X}- \widehat{\boldsymbol{X}}_q = \sum_{k=q+1}^p \boldsymbol{t}_k \boldsymbol{e}_k^T\), em que os autovetores \(\boldsymbol{e}_k\) formam um conjunto ortonormal e os vetores de escores \(\boldsymbol{t}_k\) são mutuamente ortogonais, a ortogonalidade dos termos garante que:
\[ \|\boldsymbol{X}- \widehat{\boldsymbol{X}}_q\|_F^2 = \sum_{k=q+1}^p \|\boldsymbol{t}_k \boldsymbol{e}_k^T\|_F^2 = \sum_{k=q+1}^p \|\boldsymbol{t}_k\|^2 \|\boldsymbol{e}_k\|^2 = \sum_{k=q+1}^p \|\boldsymbol{t}_k\|^2 \]
Dividindo por \(n-1\), e lembrando que \(\frac{1}{n-1}\|\boldsymbol{t}_k\|^2 = \frac{1}{n-1}\boldsymbol{t}_k^T\boldsymbol{t}_k = \lambda_k\) é a variância amostral do \(k\)-ésimo componente principal:
\[ \frac{1}{n-1}\|\boldsymbol{X}- \widehat{\boldsymbol{X}}_q\|_F^2 = \sum_{k=q+1}^p \frac{\|\boldsymbol{t}_k\|^2}{n-1} = \sum_{k=q+1}^p \lambda_k \]
Exemplo 4.5 (Reconstrução dos dados manuais) Retomando o Exemplo 4.4, suponha que desejamos comprimir os dados mantendo apenas o primeiro componente principal (\(q = 1\)). O vetor de escores retido é \(\boldsymbol{t}_1 = \frac{1}{\sqrt{2}} (-4, 0, 0, 0, 4)^T\) e o autovetor correspondente é \(\boldsymbol{e}_1 = \frac{1}{\sqrt{2}} (1, 1)^T\). A reconstrução aproximada dos dados originais é:
\[ \widehat{\boldsymbol{X}}_1 = \boldsymbol{t}_1 \boldsymbol{e}_1^T = \frac{1}{2} \begin{bmatrix} -4 \\ 0 \\ 0 \\ 0 \\ 4 \end{bmatrix} \begin{bmatrix} 1 & 1 \end{bmatrix} = \begin{bmatrix} -2 & -2 \\ 0 & 0 \\ 0 & 0 \\ 0 & 0 \\ 2 & 2 \end{bmatrix} \]
A matriz de resíduos (erro de aproximação) é a diferença entre os dados originais e os reconstruídos:
\[ \boldsymbol{X}- \widehat{\boldsymbol{X}}_1 = \begin{bmatrix} -2 & -2 \\ -1 & 1 \\ 0 & 0 \\ 1 & -1 \\ 2 & 2 \end{bmatrix} - \begin{bmatrix} -2 & -2 \\ 0 & 0 \\ 0 & 0 \\ 0 & 0 \\ 2 & 2 \end{bmatrix} = \begin{bmatrix} 0 & 0 \\ -1 & 1 \\ 0 & 0 \\ 1 & -1 \\ 0 & 0 \end{bmatrix} \]
O erro quadrático médio de reconstrução é:
\[ \frac{1}{4}\|\boldsymbol{X}- \widehat{\boldsymbol{X}}_1\|_F^2 = \frac{1}{4} \left( (-1)^2 + 1^2 + 1^2 + (-1)^2 \right) = \frac{4}{4} = 1 \]
Note que esse erro coincide rigorosamente com a variância descartada \(\lambda_2 = 1\). O primeiro componente preservou \(80\%\) da variância total (\(\lambda_1 / \operatorname{tr}\left(\boldsymbol{S}\right) = 4/5\)), e a perda de informação foi exatamente a variância do segundo componente.
4.9 Exemplo prático
Exemplo 4.6 (Medidas corporais dos pinguins) Vamos exemplificar o uso da ACP com o conjunto de dados Palmer Penguins, que contém medidas corporais de pinguins: comprimento e profundidade do bico, comprimento da nadadeira e massa corporal. As três primeiras estão em milímetros; a última, em gramas. Por isso, uma ACP baseada diretamente na matriz de covariâncias daria peso excessivo à massa corporal. Começamos removendo os valores ausentes e padronizando cada variável.
Código
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

nomes = {
    "bill_length_mm": "Comp. do bico",
    "bill_depth_mm": "Prof. do bico",
    "flipper_length_mm": "Comp. da nadadeira",
    "body_mass_g": "Massa corporal",
}

pinguins = pd.read_csv("dados/penguins.csv")
pinguins = pinguins.dropna(subset=list(nomes) + ["species"])

X = pinguins[list(nomes)].rename(columns=nomes)
Z = (X - X.mean()) / X.std()
R = Z.cov()
R.round(2)| Comp. do bico | Prof. do bico | Comp. da nadadeira | Massa corporal | |
|---|---|---|---|---|
| Comp. do bico | 1.00 | -0.24 | 0.66 | 0.60 |
| Prof. do bico | -0.24 | 1.00 | -0.58 | -0.47 |
| Comp. da nadadeira | 0.66 | -0.58 | 1.00 | 0.87 |
| Massa corporal | 0.60 | -0.47 | 0.87 | 1.00 |
O conjunto de dados tem 342 observações completas. Note que a variância total é \(\operatorname{tr}\left(\boldsymbol{R}\right)=1+1+1+1=4\), pois todas as variáveis padronizadas têm variância 1. A matriz também antecipa parte da estrutura que a ACP encontrará. Comprimento da nadadeira e massa corporal, por exemplo, têm correlação 0.87; isso indica que essas variáveis carregam informação parecida.
Agora fazemos a decomposição espectral de \(\boldsymbol{R}\). As colunas da matriz E são os autovetores e definem as combinações lineares; a matriz T contém os escores das observações. A Tabela 4.2 apresenta a variância explicada, enquanto a Figura 4.5 mostra os mesmos autovalores graficamente.
Nota
Existem bibliotecas que facilitam a aplicação da ACP, como sklearn.decomposition.PCA. Como os cálculos são extremamente simples, vamos apenas usar a decomposição espectral fornecida pelo NumPy.
Código
autovalores, E = np.linalg.eigh(R)
# A função eigh() devolve os autovalores em ordem crescente, então precisamos inverter a ordem
ordem = autovalores.argsort()[::-1]
autovalores = autovalores[ordem]
E = E[:, ordem]

# O sinal de um autovetor é arbitrário. Escolhemos a orientação dos dois primeiros para facilitar a interpretação.
if E[2, 0] < 0:
    E[:, 0] *= -1
if E[1, 1] < 0:
    E[:, 1] *= -1

# Os escores T são
T = Z.to_numpy() @ E

# Variância explicada pelos componentes principais
proporcoes = autovalores / autovalores.sum()
acumuladas = np.cumsum(proporcoes)
pd.DataFrame({
    "Componente": ["CP1", "CP2", "CP3", "CP4"],
    "Autovalor": autovalores,
    "Proporção (%)": 100 * proporcoes,
    "Acumulada (%)": 100 * acumuladas,
}).round(2).set_index("Componente").rename_axis(None)
# Gráfico do cotovelo
componentes = np.arange(1, 5)
fig, ax = plt.subplots(figsize=(5, 3.5))
ax.plot(componentes, autovalores, "o-", linewidth=2)
ax.axhline(1, color="gray", linestyle="--", label="Autovalor = 1")
ax.set(
    xlabel="Componente principal",
    ylabel="Autovalor",
    xticks=componentes,
    ylim=(0, 3),
)
ax.legend()
plt.tight_layout()
plt.show()| Autovalor | Proporção (%) | Acumulada (%) | |
|---|---|---|---|
| CP1 | 2.75 | 68.84 | 68.84 |
| CP2 | 0.77 | 19.31 | 88.16 |
| CP3 | 0.37 | 9.13 | 97.29 |
| CP4 | 0.11 | 2.71 | 100.00 |
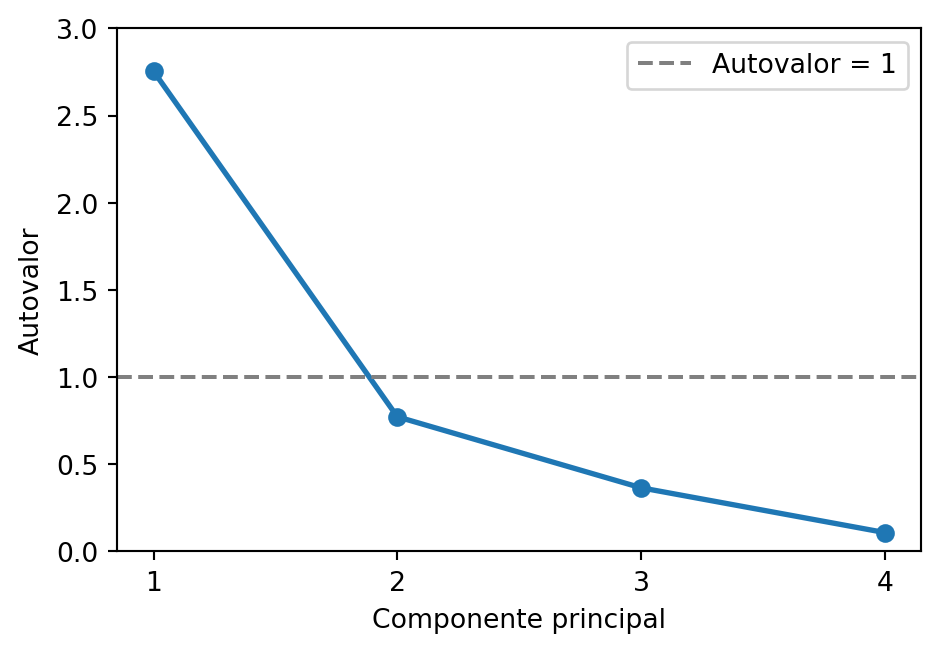
O primeiro componente tem variância 2.75 e concentra 68.8% da variância total. Os dois primeiros, juntos, concentram 88.2%. Se o interesse do problema fosse a redução da dimensionalidade, seria razoável manter dois componentes, pois eles preservam a maior parte da variância e permitem analisar os dados em um espaço bidimensional. Aqui, vamos focar na interpretação de CP1 e CP2.
Código
correlacoes = E[:, :2] * np.sqrt(autovalores[:2])

pd.DataFrame({
    "Variável": Z.columns,
    "CP1": correlacoes[:, 0],
    "CP2": correlacoes[:, 1],
}).round(3).set_index("Variável").rename_axis(None)
fig, ax = plt.subplots(figsize=(5, 3.5))

ajuste_vertical = {
    "Comp. da nadadeira": -0.10,
    "Massa corporal": 0.10,
}

for nome, (x, y) in zip(Z.columns, correlacoes):
    ax.annotate(
        "",
        xy=(x, y),
        xytext=(0, 0),
        arrowprops={"arrowstyle": "->", "color": "firebrick"},
    )
    ax.text(
        1.08 * x,
        1.08 * y + ajuste_vertical.get(nome, 0),
        nome,
        color="firebrick",
        fontsize=9,
        ha="center",
    )

ax.add_patch(plt.Circle((0, 0), 1, fill=False, color="gray", linestyle=":"))
ax.axhline(0, color="gray", linewidth=0.8)
ax.axvline(0, color="gray", linewidth=0.8)
ax.set(
    xlabel="CP1",
    ylabel="CP2",
    xlim=(-1.2, 1.2),
    ylim=(-1.2, 1.2),
)
ax.set_aspect("equal")
plt.tight_layout()
plt.show()| CP1 | CP2 | |
|---|---|---|
| Comp. do bico | 0.755 | 0.525 |
| Prof. do bico | -0.664 | 0.701 |
| Comp. da nadadeira | 0.956 | 0.002 |
| Massa corporal | 0.910 | 0.074 |
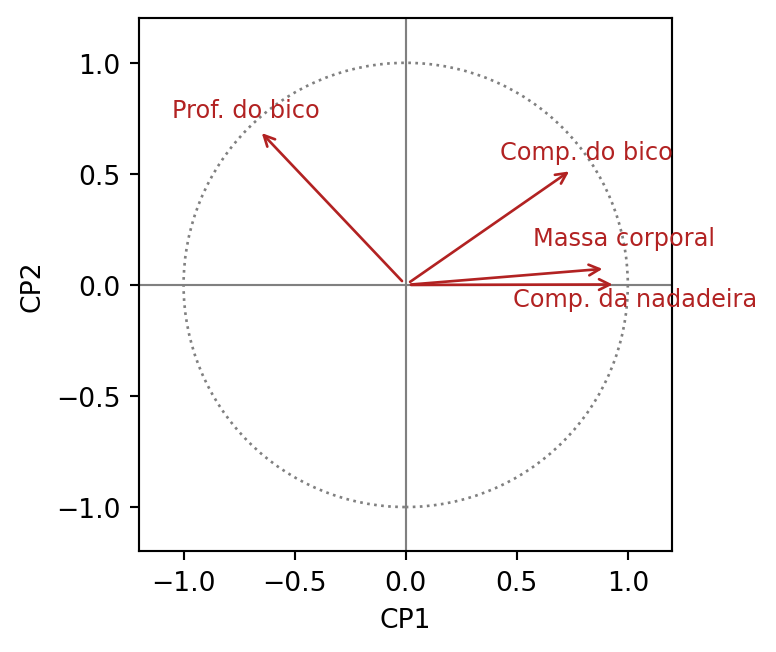
As correlações tornam a interpretação direta. O primeiro componente cresce com o comprimento da nadadeira, a massa corporal e o comprimento do bico, mas diminui com a profundidade do bico. Ele separa, portanto, pinguins maiores e mais pesados, com nadadeiras longas e bicos mais compridos e menos profundos, de pinguins com o perfil oposto.
O segundo componente está ligado principalmente às duas medidas do bico. Comprimento da nadadeira e massa corporal têm correlações próximas de zero com esse eixo. Assim, \(Y_2\) descreve uma variação conjunta no comprimento e na profundidade do bico.
O círculo de correlações, mostrado na Figura 4.6, permite avaliar as relações entre as variáveis e sua representação no plano. O comprimento ao quadrado de cada seta é a soma das correlações ao quadrado com CP1 e CP2: quanto mais próxima da circunferência estiver sua ponta, melhor a variável está representada. Para variáveis bem representadas, ângulos pequenos indicam correlação positiva, ângulos próximos de \(180^\circ\) indicam correlação negativa e ângulos próximos de \(90^\circ\) indicam correlação próxima de zero. Aqui, comprimento da nadadeira e massa corporal têm setas próximas, enquanto profundidade do bico e comprimento da nadadeira formam um ângulo obtuso, coerente com sua correlação negativa. Como usamos apenas dois componentes, essas leituras são aproximadas.
O banco de dados original contém também as espécies dos pinguins. Elas são três: Adelie, Chinstrap e Gentoo. Vamos construir um biplot, colorindo os pontos de acordo com a espécie. No biplot da Figura 4.7, os pontos mostram os escores brutos nos dois primeiros componentes e as setas indicam a direção em que cada medida padronizada aumenta na reconstrução. As setas usam os coeficientes dos autovetores, ampliados por um fator comum de 3 para facilitar a visualização. Essa escala difere da usada no círculo de correlações, de modo que os ângulos entre as setas deste biplot não devem ser interpretados como correlações.
Dica
Note que a variável relativa à espécie do animal não entrou no cálculo da ACP, ela aparece apenas na etapa interpretativa para completar nossas conclusões. Nesse caso, dizemos que a espécie é uma variável exógena.
Código
escores = T[:, :2]
fig, ax = plt.subplots(figsize=(7, 6))

for especie in pinguins["species"].unique():
    grupo = pinguins["species"].eq(especie).to_numpy()
    ax.scatter(
        escores[grupo, 0],
        escores[grupo, 1],
        alpha=0.6,
        label=especie,
    )

# Amplia todas as setas pelo mesmo fator para facilitar a visualização.
vetores = 3 * E[:, :2]
ajuste_rotulos = {
    "Comp. da nadadeira": -0.15,
    "Massa corporal": 0.15,
}

for nome, (x, y) in zip(Z.columns, vetores):
    ax.annotate(
        "",
        xy=(x, y),
        xytext=(0, 0),
        arrowprops={"arrowstyle": "->", "color": "firebrick"},
    )
    ax.text(
        1.08 * x,
        1.08 * y + ajuste_rotulos.get(nome, 0),
        nome,
        color="firebrick",
        ha="center",
    )

ax.axhline(0, color="gray", linewidth=0.8)
ax.axvline(0, color="gray", linewidth=0.8)
ax.set(
    xlabel=f"CP1 ({proporcoes[0]:.1%})",
    ylabel=f"CP2 ({proporcoes[1]:.1%})",
    xlim=(-3.2, 4.3),
    ylim=(-3.0, 3.2),
)
ax.set_aspect("equal")
ax.legend(title="Espécie", loc="lower right")
plt.tight_layout()
plt.show()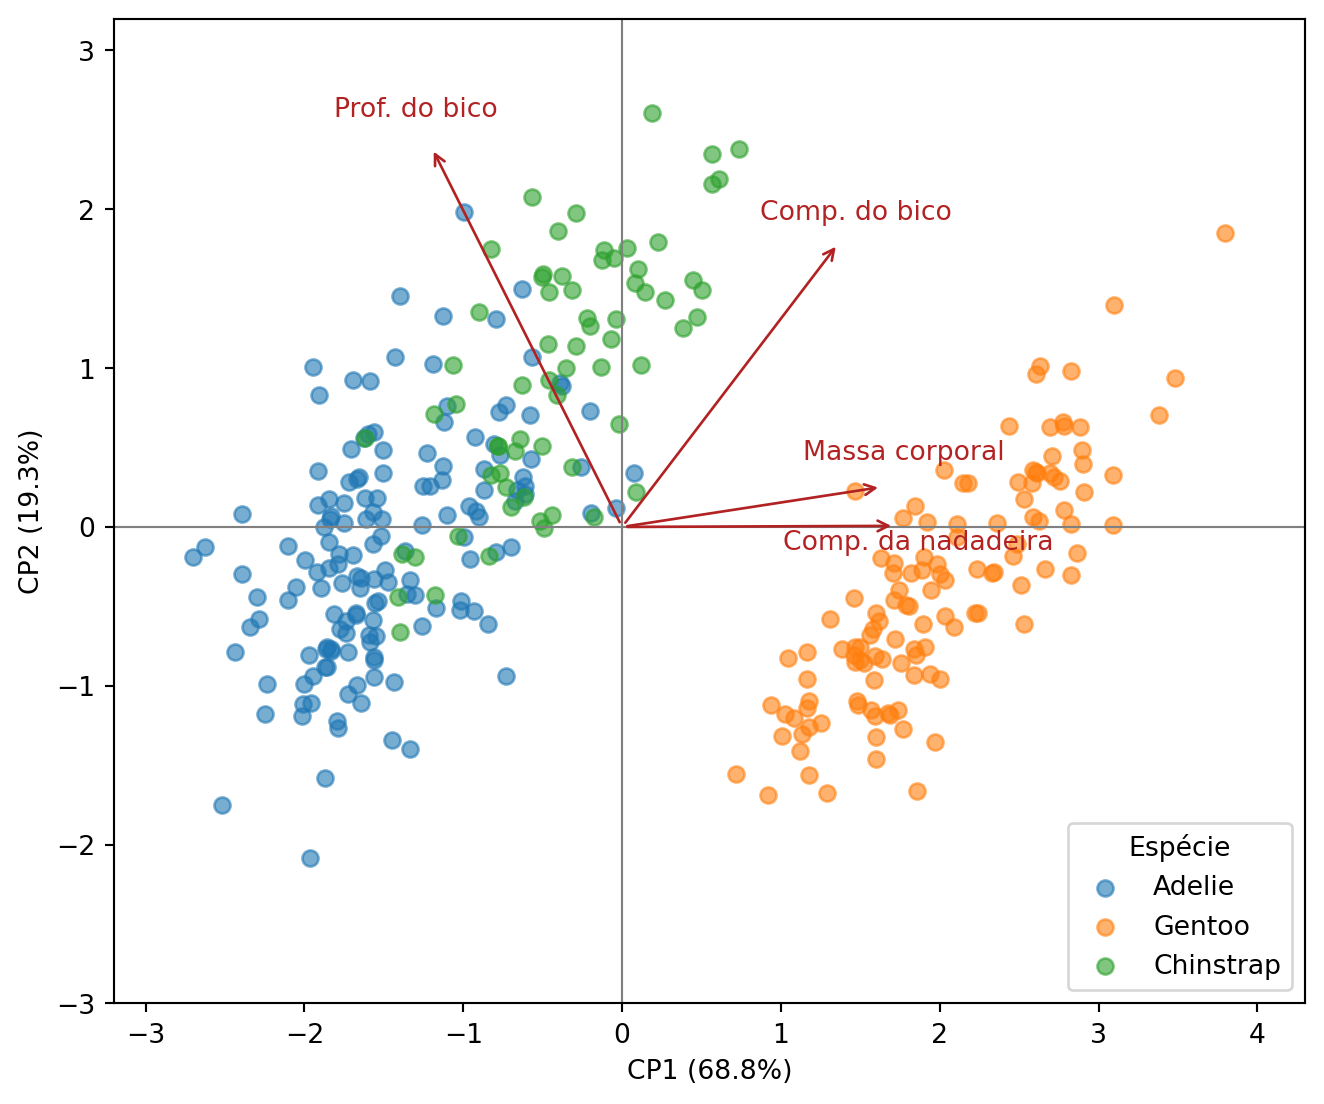
Os Gentoo aparecem principalmente à direita, na direção das setas de massa corporal e comprimento da nadadeira, indicando que esses pinguins são mais pesados e maiores. Os Adelie se concentram à esquerda, ilustrando que esses pinguins são mais leves e menores.
Os Chinstrap ocupam a parte superior, associada a valores altos nas duas medidas do bico. Na amostra, seus bicos são, em média, mais compridos que os dos Adelie, mas têm profundidade muito semelhante. Em comparação com os Gentoo, a diferença mais evidente está na maior profundidade do bico.
Também podemos reconstruir as variáveis na escala física original a partir dos dois primeiros componentes. Desfazendo a padronização, a Tabela 4.4 compara as medidas originais com os valores reconstruídos para as três primeiras observações da amostra.
Código
X_rec = X.mean().to_numpy() + (T[:, :2] @ E[:, :2].T) * X.std().to_numpy()
X_rec_df = pd.DataFrame(X_rec, columns=X.columns, index=X.index)

linhas_comp = []
for i in [0, 1, 2]:
    orig = X.iloc[i].round(1)
    rec = X_rec_df.iloc[i].round(1)
    for col in X.columns:
        linhas_comp.append({
            "Pinguim": f"Pinguim {i+1}",
            "Medida": col,
            "Original": orig[col],
            "Reconstruído (2 CPs)": rec[col],
            "Diferença": round(rec[col] - orig[col], 1),
        })

pd.DataFrame(linhas_comp).set_index(["Pinguim", "Medida"])| Original | Reconstruído (2 CPs) | Diferença | ||
|---|---|---|---|---|
| Pinguim | Medida | |||
| Pinguim 1 | Comp. do bico | 39.1 | 39.5 | 0.4 |
| Prof. do bico | 18.7 | 18.7 | 0.0 | |
| Comp. da nadadeira | 181.0 | 186.0 | 5.0 | |
| Massa corporal | 3750.0 | 3395.5 | -354.5 | |
| Pinguim 2 | Comp. do bico | 39.5 | 39.3 | -0.2 |
| Prof. do bico | 17.4 | 17.5 | 0.1 | |
| Comp. da nadadeira | 186.0 | 190.3 | 4.3 | |
| Massa corporal | 3800.0 | 3599.0 | -201.0 | |
| Pinguim 3 | Comp. do bico | 40.3 | 40.0 | -0.3 |
| Prof. do bico | 18.0 | 18.0 | 0.0 | |
| Comp. da nadadeira | 195.0 | 189.8 | -5.2 | |
| Massa corporal | 3250.0 | 3590.1 | 340.1 |
Como retemos 88.2% da variância acumulada com dois componentes, as medidas reconstruídas se aproximam bastante dos valores originais, descartando apenas o ruído e a variação secundária das duas últimas dimensões.
4.10 Exercícios
Exercício 4.1 Seja \(\boldsymbol{x}\) um vetor aleatório de dimensão \(p\) com matriz de covariâncias \(\boldsymbol{\Sigma}= \operatorname{Cov}\left(\boldsymbol{x}\right)\), real e simétrica. Os componentes principais de \(\boldsymbol{x}\) são definidos pela transformação linear \(\boldsymbol{y} = \boldsymbol{E}^T\boldsymbol{x}\), em que \(\boldsymbol{E}\) é a matriz ortogonal \(p \times p\) cujas colunas são os autovetores normalizados de \(\boldsymbol{\Sigma}\).
Mostre que os componentes principais \(Y_1, \dots, Y_p\) são não correlacionados entre si e têm variâncias \(\lambda_1, \dots, \lambda_p\), respectivamente. Ou seja, mostre que a matriz de covariâncias de \(\boldsymbol{y}\) é a matriz diagonal contendo os autovalores de \(\boldsymbol{\Sigma}\):
\[ \operatorname{Cov}\left(\boldsymbol{y}\right) = \begin{bmatrix} \lambda_1 & 0 & \dots & 0 \\ 0 & \lambda_2 & \dots & 0 \\ \vdots & \vdots & \ddots & \vdots \\ 0 & 0 & \dots & \lambda_p \end{bmatrix} \]
Exercício 4.2 Um vendedor de ferramentas automotivas coletou dados a respeito de um determinado produto de seu portfólio: \(X_1\): Qualidade das peças; \(X_2\): Facilidade de utilização; \(X_3\): Qualidade da embalagem. Após analisar os dados, ele calculou a seguinte matriz de covariância amostral:
\[ \boldsymbol{S}= \begin{bmatrix} 4 & 2 & 0 \\ 2 & 1 & 0 \\ 0 & 0 & 2 \end{bmatrix} \]
a) Apenas olhando para essa matriz, o que podemos esperar de uma ACP nesse caso?
b) Realize a decomposição da matriz para obter os componentes principais. Depois, compare os resultados com as suposições feitas no item (a).
Exercício 4.3 Dois grupos realizaram uma ACP sobre a mesma matriz de dados. Para um dos componentes, o primeiro grupo obteve o autovetor \(\boldsymbol{e}_k\) e o vetor de escores \(\boldsymbol{t}_k = \boldsymbol{X}\boldsymbol{e}_k\). O segundo encontrou \(-\boldsymbol{e}_k\) e o vetor de escores com sinal invertido, \(-\boldsymbol{t}_k\). Os gráficos produzidos pelos grupos aparecem refletidos, e cada grupo acredita que o outro cometeu um erro.
a) Mostre que, se \(\boldsymbol{e}_k\) é um autovetor de \(\boldsymbol{\Sigma}\) associado a \(\lambda_k\), então \(-\boldsymbol{e}_k\) também é.
b) Compare a variância explicada, as correlações \(\operatorname{Corr}\left(X_j, Y_k\right)\) entre as variáveis originais e o componente (Proposição 4.2) e os escores obtidos pelos dois grupos. O que muda e o que permanece igual?
c) Afinal, os grupos encontraram componentes diferentes?
Exercício 4.4 Considere um vetor aleatório bidimensional \(\boldsymbol{x}=(X_1,X_2)^T\), em que \(X_1\) e \(X_2\) são padronizadas e \(\operatorname{Corr}\left(X_1,X_2\right)=a\), com \(0<a\leq 1\).
Mostre que a proporção da variância total explicada pelo primeiro componente principal varia linearmente com \(a\). Determine essa função e interprete seu comportamento quando \(a\to 0^+\) e quando \(a=1\).
Exercício 4.5 Dois pesquisadores aplicaram ACP à matriz de covariâncias
\[ \boldsymbol{\Sigma} = \begin{bmatrix} 4 & 0 & 0\\ 0 & 4 & 0\\ 0 & 0 & 1 \end{bmatrix} \]
O primeiro escolheu \((1,0,0)^T\) e \((0,1,0)^T\) como os autovetores associados ao autovalor 4. O segundo escolheu, para algum ângulo \(\phi\),
\[ \boldsymbol{v}_1= \begin{bmatrix}\cos\phi\\ \sin\phi\\ 0\end{bmatrix} \qquad\text{e}\qquad \boldsymbol{v}_2= \begin{bmatrix}-\sin\phi\\ \cos\phi\\ 0\end{bmatrix} \]
a) Verifique que \(\boldsymbol{v}_1\) e \(\boldsymbol{v}_2\) são autovetores unitários e ortogonais associados ao autovalor 4.
b) Algum dos pesquisadores está errado? Explique como a repetição dos autovalores afeta a ACP.
Exercício 4.6 Considere a matriz de dados centralizados \(\boldsymbol{X}\) (\(n \times p\)) e a aproximação de posto \(q\) dada por \(\widehat{\boldsymbol{X}}_q = \boldsymbol{X}\boldsymbol{P}_q\), em que \(\boldsymbol{P}_q = \boldsymbol{E}_q\boldsymbol{E}_q^T\) é construída a partir dos \(q\) primeiros autovetores ortonormais de \(\boldsymbol{S}\).
a) Mostre que a matriz \(\boldsymbol{P}_q\) é simétrica e idempotente (\(\boldsymbol{P}_q^2 = \boldsymbol{P}_q\)). Qual é a interpretação geométrica dessa transformação sobre as observações?
b) Mostre que a matriz residual de reconstrução, \(\boldsymbol{X}- \widehat{\boldsymbol{X}}_q\), é ortogonal às direções mantidas, isto é, \((\boldsymbol{X}- \widehat{\boldsymbol{X}}_q)\boldsymbol{E}_q = \boldsymbol{0}\). O que isso indica sobre a informação descartada?
Exercício 4.7 (Composição química de vinhos) O conjunto Wine, da UCI Machine Learning Repository, reúne 178 vinhos produzidos na mesma região da Itália a partir de três cultivares. Para cada vinho, foram registradas 13 medidas de sua composição química. O que uma ACP permite concluir a respeito desses vinhos? Justifique todas as decisões tomadas.
4.11 Tópicos avançados
Até agora, esse capítulo apresentou a teoria clássica da ACP. Agora, vamos explorar algumas técnicas avançadas e discussões que não cabem no primeiro contato com a técnica. Esta seção apresenta extensões da ACP com um menor nível de detalhe.
4.11.1 Soluções alternativas da ACP
A solução usual da ACP pode ser obtida pela decomposição em valores singulares (SVD), definida em Definição 2.14, da matriz de dados centralizados. Isso elimina a etapa de cálculo da matriz de covariância e também garante melhor estabilidade numérica. Essa estratégia é usada por boa parte das bibliotecas, como o scikit-learn. A seguir, formalizamos essa solução.
Proposição 4.4 (ACP pela SVD) Seja \(\boldsymbol{X}\) (\(n \times p\)) a matriz de dados centralizados e \(\boldsymbol{X}= \boldsymbol{U}\boldsymbol{\Delta}\boldsymbol{V}^T\) sua SVD completa, com \(\boldsymbol{U}\) (\(n \times n\)) e \(\boldsymbol{V}\) (\(p \times p\)) ortogonais. A matriz \(\boldsymbol{\Delta}\) (\(n \times p\)) contém os valores singulares positivos \(\delta_1 \geq \dots \geq \delta_r > 0\) na diagonal e zeros nas demais posições, em que \(r \leq \min(n-1,p)\) é o posto de \(\boldsymbol{X}\). Sejam \(\boldsymbol{E}\) e \(\boldsymbol{\Lambda}\) as matrizes de autovetores e autovalores de \(\boldsymbol{S}\), respectivamente, e \(\boldsymbol{T} = \boldsymbol{X}\boldsymbol{E}\) a matriz de escores. Segue que,
\[ \boldsymbol{E} = \boldsymbol{V}, \qquad \boldsymbol{\Lambda} = \frac{1}{n-1}\boldsymbol{\Delta}^T\boldsymbol{\Delta}, \qquad \boldsymbol{T} = \boldsymbol{U}\boldsymbol{\Delta} \]
isto é, as direções principais são as colunas de \(\boldsymbol{V}\). Para \(k \leq r\), temos \(\lambda_k = \delta_k^2/(n-1)\) e \(\boldsymbol{t}_k = \delta_k\boldsymbol{u}_k\). Os demais autovalores e escores são nulos.
Prova. Como as colunas de \(\boldsymbol{U}\) são ortonormais e \(\boldsymbol{\Delta}^T\boldsymbol{\Delta} = \operatorname{diag}\left(\delta_1^2, \dots, \delta_r^2, 0, \dots, 0\right)\),
\[ \boldsymbol{S}= \frac{1}{n-1}\boldsymbol{X}^T\boldsymbol{X}= \frac{1}{n-1}\boldsymbol{V}\boldsymbol{\Delta}^T\boldsymbol{U}^T\boldsymbol{U}\boldsymbol{\Delta}\boldsymbol{V}^T = \boldsymbol{V}\left(\frac{\boldsymbol{\Delta}^T\boldsymbol{\Delta}}{n-1}\right)\boldsymbol{V}^T \]
é uma decomposição espectral de \(\boldsymbol{S}\), com \(\boldsymbol{V}\) ortogonal e autovalores positivos \(\delta_k^2/(n-1)\) em ordem decrescente, seguidos dos autovalores nulos. Podemos, portanto, escolher \(\boldsymbol{E} = \boldsymbol{V}\) e \(\boldsymbol{\Lambda} = \boldsymbol{\Delta}^T\boldsymbol{\Delta}/(n-1)\). Os escores seguem de \(\boldsymbol{T} = \boldsymbol{X}\boldsymbol{E} = \boldsymbol{U}\boldsymbol{\Delta}\boldsymbol{V}^T\boldsymbol{V} = \boldsymbol{U}\boldsymbol{\Delta}\).
A proposição mostra a equivalência entre a solução por decomposição espectral vista no capítulo e a solução por SVD. Ela explica também por que o Teorema de Eckart-Young, que é um resultado teórico sobre a SVD, pôde ser invocado na Proposição 4.3: a soma de matrizes de posto um \(\sum_k \boldsymbol{t}_k\boldsymbol{e}_k^T\) é exatamente a SVD truncada de \(\boldsymbol{X}\).
Corolário 4.1 (ACP pela matriz de produtos internos) Nas condições da Proposição 4.4, seja \(\boldsymbol{X}\boldsymbol{X}^T\) a matriz \(n \times n\) de produtos internos entre observações, cujas entradas são \(\boldsymbol{x}_i^T\boldsymbol{x}_j\). Então
\[ \boldsymbol{X}\boldsymbol{X}^T = \boldsymbol{U}\left(\boldsymbol{\Delta}\boldsymbol{\Delta}^T\right)\boldsymbol{U}^T \]
é uma decomposição espectral de \(\boldsymbol{X}\boldsymbol{X}^T\).
Prova. Como \(\boldsymbol{V}\) é ortogonal, \(\boldsymbol{X}\boldsymbol{X}^T = \boldsymbol{U}\boldsymbol{\Delta}\boldsymbol{V}^T\boldsymbol{V}\boldsymbol{\Delta}^T\boldsymbol{U}^T = \boldsymbol{U}(\boldsymbol{\Delta}\boldsymbol{\Delta}^T)\boldsymbol{U}^T\), com \(\boldsymbol{U}\) ortogonal e \(\boldsymbol{\Delta}\boldsymbol{\Delta}^T\) diagonal, contendo \(\delta_1^2 \geq \dots \geq \delta_r^2 > 0\) e zeros nas posições restantes. Os autovalores positivos de \(\boldsymbol{X}\boldsymbol{X}^T\) são, portanto, os \(\delta_k^2\), e pela Proposição 4.4 valem \(\delta_k^2 = (n-1)\lambda_k\). Os escores seguem de \(\boldsymbol{T} = \boldsymbol{U}\boldsymbol{\Delta}\), cuja \(k\)-ésima coluna é \(\delta_k\boldsymbol{u}_k\) para \(k \leq r\), sendo nulas as demais.
Note que a matriz de escores da proposição Proposição 4.4 depende exclusivamente de \(\boldsymbol{\Delta}\) e \(\boldsymbol{U}\), e o corolário mostra que essas matrizes podem ser obtidas através da decomposição de \(\boldsymbol{X}\boldsymbol{X}^T\). Ou seja, a ACP pela matriz de produtos internos é um atalho para obter os escores, sem passar pelas projeções.
4.11.2 ACP com kernel
A ACP busca um subespaço linear que preserve a variância dos dados. Quando a estrutura dos dados é curva, uma redução linear pode não descrevê-la bem. Uma alternativa é usar a ACP com kernel. Tomamos vantagem do Corolário 4.1: os escores dependem da amostra apenas através dos produtos internos \(\boldsymbol{x}_i^T\boldsymbol{x}_j\).
Isso abre espaço para o truque do kernel: trocar o produto interno usual por uma função de kernel \(\kappa(\boldsymbol{x}_i, \boldsymbol{x}_j)\), que mede produtos internos em um espaço transformado de dimensão muito maior, sem precisar construí-lo. Nesse espaço, relações não lineares passam a ser tratadas como lineares. A escolha usual para capturar estruturas curvas é o kernel gaussiano
\[ \kappa(\boldsymbol{x}_i, \boldsymbol{x}_j) = \exp\left(-\gamma\|\boldsymbol{x}_i - \boldsymbol{x}_j\|^2\right) \]
onde \(\gamma\) é um parâmetro fixado. Basta então montar e decompor a matriz de kernel \(\boldsymbol{K}\), com \(k_{ij} = \kappa(\boldsymbol{x}_i, \boldsymbol{x}_j)\), devidamente centralizada. Os escores no espaço do kernel são dados por \(\boldsymbol{T} = \boldsymbol{U}\boldsymbol{\Delta}\), onde \(\boldsymbol{U}\) contém os autovetores da matriz de kernel centralizada e \(\boldsymbol{\Delta} = \operatorname{diag}\left(\delta_1, \dots, \delta_r\right)\) reúne as raízes quadradas de seus autovalores.
Nota
A ACP com o kernel linear \(\kappa(\boldsymbol{x}_i, \boldsymbol{x}_j) = \boldsymbol{x}_i^T\boldsymbol{x}_j\), recupera exatamente a ACP linear usual deste capítulo.
A Figura 4.8 mostra um caso em que a diferença é gritante. Os dados são dois anéis concêntricos de raios 1 e 3, e a informação que interessa é justamente a qual anel cada ponto pertence.
Código
rng_aneis = np.random.default_rng(11)
m_aneis = 150
angulo = rng_aneis.uniform(0, 2 * np.pi, size=2 * m_aneis)
raio = np.concatenate([
    1 + rng_aneis.normal(scale=0.1, size=m_aneis),
    3 + rng_aneis.normal(scale=0.1, size=m_aneis),
])
X_aneis = np.column_stack([raio * np.cos(angulo), raio * np.sin(angulo)])
interno = np.arange(2 * m_aneis) < m_aneis

# ACP usual
Xc_aneis = X_aneis - X_aneis.mean(axis=0)
_, E_aneis = np.linalg.eigh(np.cov(Xc_aneis, rowvar=False))
T_aneis = Xc_aneis @ E_aneis[:, ::-1]

# ACP com kernel gaussiano
D2 = ((X_aneis[:, None, :] - X_aneis[None, :, :]) ** 2).sum(axis=-1)
K = np.exp(-0.5 * D2)
n_k = len(K)
U_k = np.ones((n_k, n_k)) / n_k
K_centralizada = K - U_k @ K - K @ U_k + U_k @ K @ U_k          # centralização no espaço transformado
val_k, vec_k = np.linalg.eigh(K_centralizada)
val_k, vec_k = val_k[::-1], vec_k[:, ::-1]
T_kernel = vec_k[:, :2] * np.sqrt(val_k[:2])

fig, axes = plt.subplots(1, 3, figsize=(8.4, 2.9))
painels = [
    (X_aneis, "Dados originais", "$X_1$", "$X_2$"),
    (T_aneis, "ACP usual", "Primeiro CP", "Segundo CP"),
    (T_kernel, "ACP com kernel", "Primeiro CP", "Segundo CP"),
]
for ax, (pontos, titulo, rx, ry) in zip(axes, painels):
    ax.scatter(pontos[interno, 0], pontos[interno, 1], s=12, alpha=0.6, color=cor_pontos)
    ax.scatter(pontos[~interno, 0], pontos[~interno, 1], s=12, alpha=0.6, color=cor_componente)
    ax.set(title=titulo, xlabel=rx, ylabel=ry)
plt.tight_layout()
plt.show()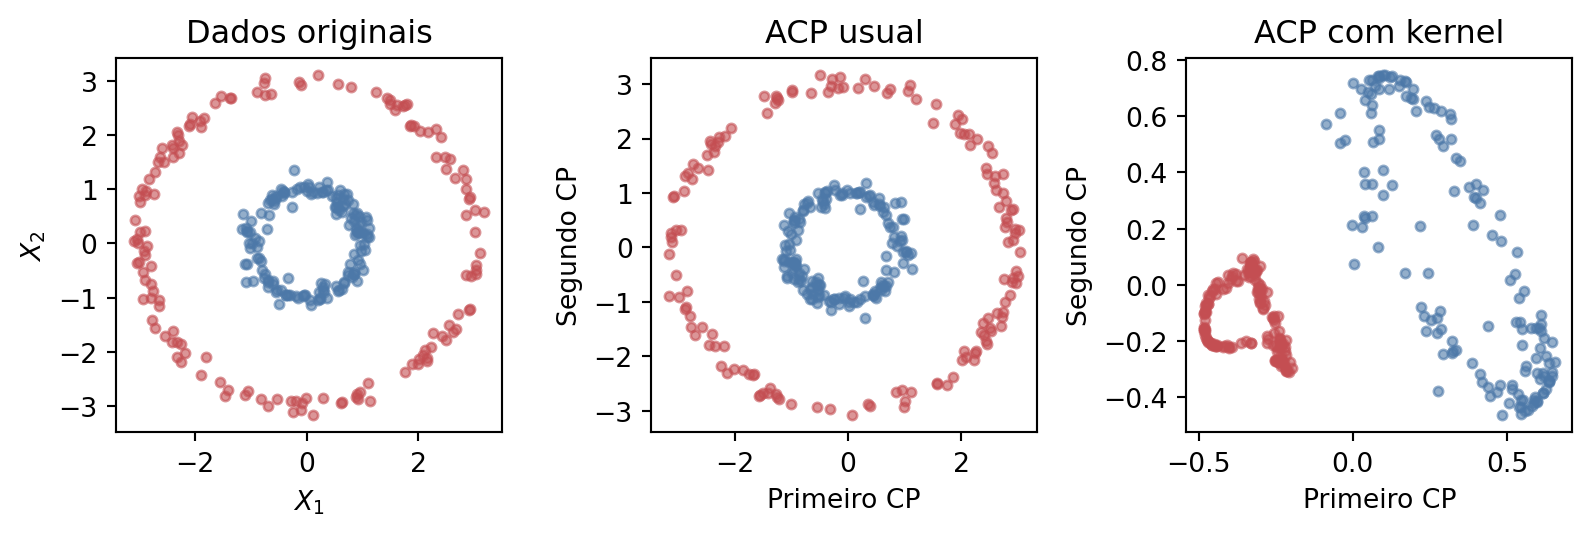
Os dois anéis têm o mesmo centro e, em cada anel, a variância populacional é a mesma em todas as direções. Uma projeção linear sobre um único eixo produz sobreposição entre os grupos. Os escores do painel central são apenas os dados originais girados. Já no espaço induzido pelo kernel gaussiano os anéis ficam separados sobre o primeiro componente, e uma única coordenada passa a distinguir perfeitamente os dois grupos.
Na ACP com kernel, os componentes são lineares no espaço transformado, mas em geral são funções não lineares das variáveis originais, calculadas por meio do kernel. Assim, não temos cargas lineares dessas variáveis com a interpretação usual da ACP.
4.11.3 Estabilidade da solução
Os componentes de uma amostra são estimativas, e como toda estimativa variam de amostra para amostra. Sob normalidade, há um resultado assintótico que descreve essa variação para as direções estimadas.
Proposição 4.5 (Distribuição assintótica dos autovetores) Seja \(\boldsymbol{x}_1, \dots, \boldsymbol{x}_n\) uma amostra aleatória de uma \(N_p(\boldsymbol{\mu}, \boldsymbol{\Sigma})\), em que \(\boldsymbol{\Sigma}\) tem autovalores distintos \(\lambda_1 > \dots > \lambda_p > 0\) e autovetores ortonormais associados \(\boldsymbol{e}_1, \dots, \boldsymbol{e}_p\). Sejam \(\hat{\boldsymbol{e}}_1, \dots, \hat{\boldsymbol{e}}_p\) os autovetores de \(\boldsymbol{S}\), com o sinal fixado de modo que \(\hat{\boldsymbol{e}}_k^T\boldsymbol{e}_k > 0\). Então, para cada \(k\), a distribuição de \(\sqrt{n}\,(\hat{\boldsymbol{e}}_k - \boldsymbol{e}_k)\) converge, quando \(n \to \infty\), para uma \(N_p(\boldsymbol{0}, \boldsymbol{\Omega}_k)\), em que
\[ \boldsymbol{\Omega}_k = \lambda_k\sum_{j \neq k} \frac{\lambda_j}{(\lambda_j - \lambda_k)^2}\,\boldsymbol{e}_j\boldsymbol{e}_j^T \]
Não vamos demonstrar a proposição, que depende de ferramentas assintóticas fora do escopo do livro. O que interessa aqui é como ler \(\boldsymbol{\Omega}_k\). Para \(n\) grande, \(\operatorname{Cov}\left(\hat{\boldsymbol{e}}_k\right) \approx \boldsymbol{\Omega}_k/n\), e cada parcela dessa soma traz a distância entre dois autovalores elevada ao quadrado no denominador. Quando \(\lambda_j\) está próximo de \(\lambda_k\), a variância de \(\hat{\boldsymbol{e}}_k\) na direção de \(\boldsymbol{e}_j\) explode: a direção estimada gira livremente dentro do plano gerado por \(\boldsymbol{e}_j\) e \(\boldsymbol{e}_k\), refletindo mais o ruído amostral do que a estrutura da população. A hipótese de autovalores distintos, aliás, não é um detalhe técnico. É ela que garante a unicidade das direções, a menos do sinal, e o Exercício 4.5 mostra o que acontece sem ela: com \(\lambda_j = \lambda_k\), qualquer base do plano serve. A proposição diz que a transição entre os dois cenários é contínua, e que autovalores apenas próximos já produzem soluções instáveis.
Para visualizar essa incerteza sem recorrer a aproximações assintóticas, o caminho mais simples é reamostrar os dados, recalcular as cargas e desenhar os intervalos resultantes sobre o círculo de correlações, tomando o cuidado de alinhar o sinal de cada réplica à solução original, pelo motivo discutido no Exercício 4.3.
Autovalores próximos são uma causa de instabilidade difícil de perceber a olho nu. Uma segunda causa, bem mais visível, são os outliers. A Definição 4.1 constrói os componentes maximizando a variância, e a variância é um dos funcionais menos resistentes da estatística. A Figura 4.9 retoma a amostra de atrasos do Exemplo 4.3 e acrescenta oito observações contaminadas, cerca de 5% do total.
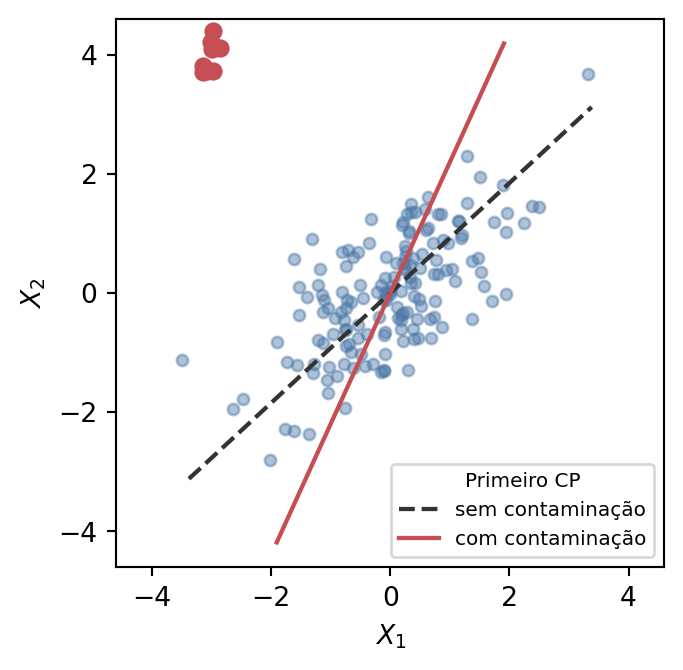
A direção do primeiro componente gira de 43° para 66°, e o segundo autovalor salta de 0.36 para 1.42. Se o problema está no funcional maximizado, é ele que deve ser trocado. Os métodos de ACP robusta substituem a variância por uma medida de escala resistente \(\sigma_{\text{rob}}\), como o desvio absoluto mediano:
\[ \max_{\boldsymbol{u}} \ \sigma_{\text{rob}}(\boldsymbol{u}^T\boldsymbol{x}) \quad \text{sujeito a} \quad \boldsymbol{u}^T\boldsymbol{u} = 1 \]
4.11.4 Análise paralela
Mesmo sob independência completa entre as variáveis, os autovalores amostrais não são todos iguais a 1: as correlações amostrais não são exatamente nulas, e a ACP se aproveita delas. A Figura 4.10 mostra o efeito em \(p = 20\) variáveis independentes observadas em \(n = 100\) indivíduos, isto é, em ruído puro.
Código
rng_paralela = np.random.default_rng(2026)
n_pa, p_pa = 100, 20
Z_pa = rng_paralela.normal(size=(n_pa, p_pa))
R_pa = np.corrcoef(Z_pa, rowvar=False)
autovalores_pa = np.linalg.eigvalsh(R_pa)[::-1]

# Distribuição nula: permutar cada coluna destrói as correlações e preserva as marginais.
nulos_pa = np.empty((500, p_pa))
for b in range(500):
    Z_perm = np.column_stack([rng_paralela.permutation(Z_pa[:, j]) for j in range(p_pa)])
    nulos_pa[b] = np.linalg.eigvalsh(np.corrcoef(Z_perm, rowvar=False))[::-1]
percentil95_pa = np.quantile(nulos_pa, 0.95, axis=0)

componentes_pa = np.arange(1, p_pa + 1)
fig, axes = plt.subplots(1, 2, figsize=(7.6, 3.3))

mapa = axes[0].imshow(R_pa, cmap="RdBu_r", vmin=-1, vmax=1)
axes[0].set(xticks=[], yticks=[], title="Correlações amostrais")
fig.colorbar(mapa, ax=axes[0], shrink=0.85)

axes[1].plot(componentes_pa, autovalores_pa, "o-", color=cor_pontos, linewidth=2,
             markersize=5, label="Autovalores observados")
axes[1].plot(componentes_pa, percentil95_pa, color=cor_componente, linewidth=1.6,
             label="Percentil 95 sob independência")
axes[1].axhline(1, color="gray", linestyle="--", linewidth=1.2, label="Critério de Kaiser")
axes[1].set(xlabel="Componente principal", ylabel="Autovalor", xticks=componentes_pa[1::2],
            title="Autovalores")
axes[1].legend(fontsize=8)

plt.tight_layout()
plt.show()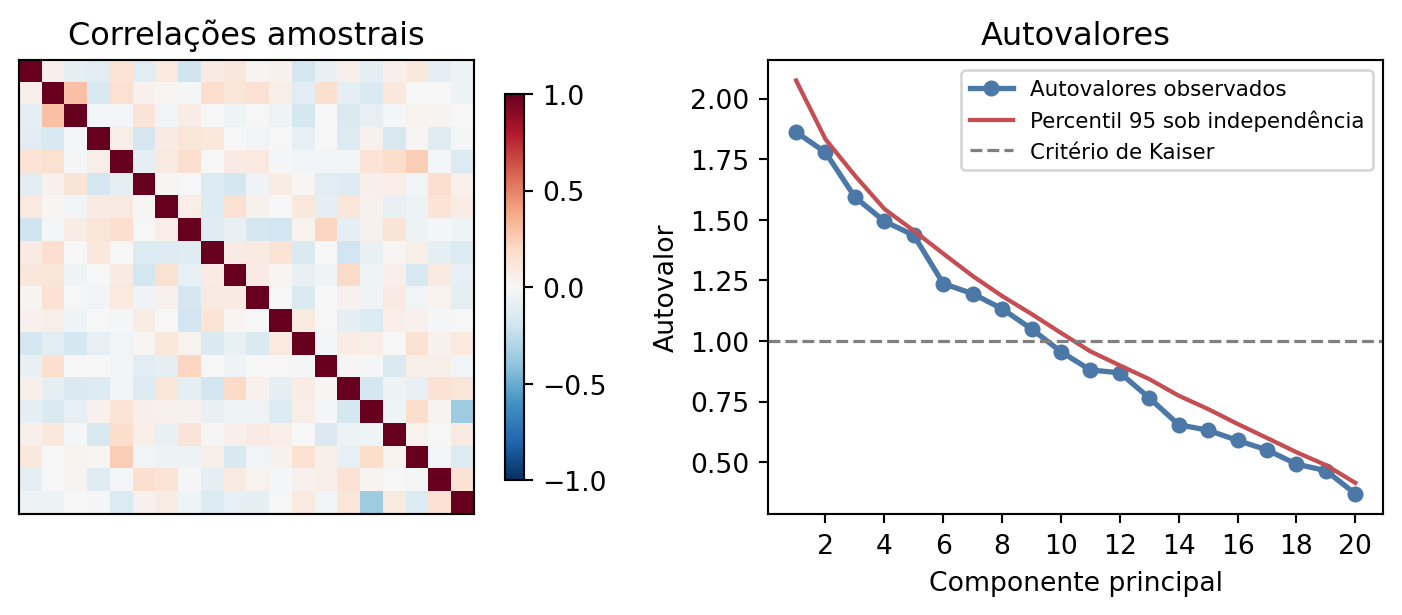
Fora da diagonal, as correlações são pequenas mas não nulas, e isso basta para que 9 autovalores fiquem acima de 1. Em dados sem estrutura alguma, o critério de Kaiser reteria quase metade dos componentes e o gráfico do cotovelo daria margem a qualquer leitura. Esses critérios descrevem a distribuição da variância, mas não a comparam com uma referência obtida sob independência.
A análise paralela faz essa comparação usando os próprios dados. Permuta-se cada coluna de forma independente, o que destrói as correlações e preserva as distribuições marginais, e recalculam-se os autovalores muitas vezes. O resultado é a distribuição dos autovalores que se observaria sob independência, e retêm-se apenas os componentes que superam um percentil alto dessa distribuição, como o percentil 95 desenhado na figura. Nesta simulação de ruído puro, o critério não retém nenhum componente. Esse resultado não é garantido em toda amostra, pois as comparações também estão sujeitas à variação amostral.
Podemos agora refazer a escolha de \(q\) do Exemplo 4.6 com esse critério.
Código
rng_pinguins = np.random.default_rng(4)
Z_pinguins = Z.to_numpy()

nulos_pinguins = np.empty((500, Z_pinguins.shape[1]))
for b in range(500):
    Z_perm = np.column_stack(
        [rng_pinguins.permutation(Z_pinguins[:, j]) for j in range(Z_pinguins.shape[1])]
    )
    nulos_pinguins[b] = np.linalg.eigvalsh(np.corrcoef(Z_perm, rowvar=False))[::-1]
percentil95_pinguins = np.quantile(nulos_pinguins, 0.95, axis=0)

componentes = np.arange(1, len(autovalores) + 1)
fig, ax = plt.subplots(figsize=(5, 3.2))
ax.plot(componentes, autovalores, "o-", color=cor_pontos, linewidth=2, markersize=6,
        label="Autovalores observados")
ax.plot(componentes, percentil95_pinguins, "o--", color=cor_componente, linewidth=1.6,
        markersize=5, label="Percentil 95 sob independência")
ax.set(xlabel="Componente principal", ylabel="Autovalor", xticks=componentes)
ax.legend(fontsize=8)
plt.tight_layout()
plt.show()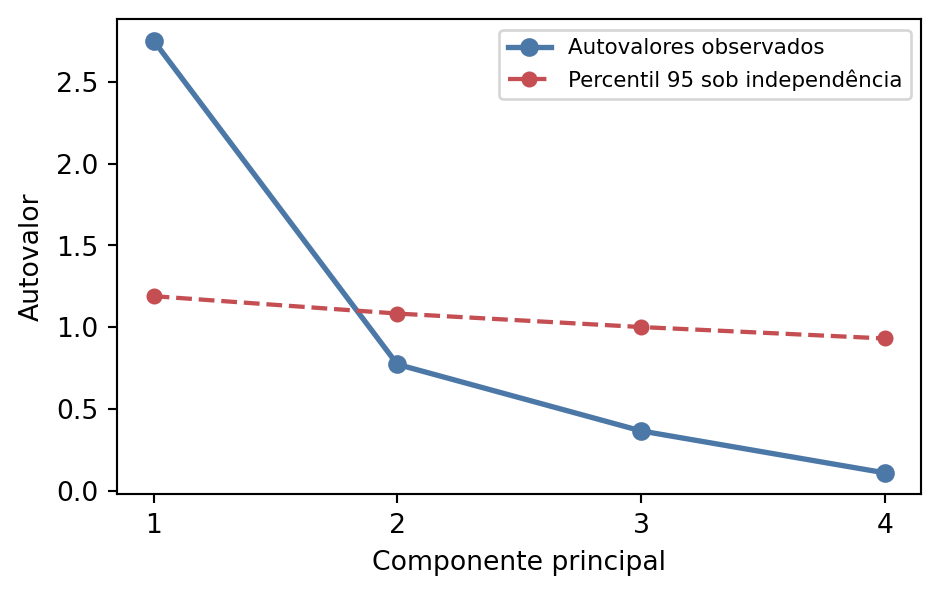
Apenas o primeiro componente supera o percentil 95 dos autovalores correspondentes nas permutações, de modo que a análise paralela sugere reter um componente. O segundo, que responde por 19.3% da variância total, não supera esse limiar, mas isso não demonstra que ele seja apenas ruído. CP2 continua útil para descrever diferenças nas medidas do bico e construir a representação bidimensional.
4.11.5 Outras reduções de dimensão
A ACP probabilística transforma em modelo a separação entre variância retida e variância descartada da Proposição 4.3. Ao reter \(q\) componentes, a ACP usual apenas abandona os \(p - q\) últimos autovalores; aqui supõe-se que todos eles valem o mesmo, um patamar de ruído \(\sigma^2\) idêntico em todas as direções não retidas. Em termos da matriz de covariâncias,
\[ \boldsymbol{\Sigma}= \boldsymbol{E}_q\left(\boldsymbol{\Lambda}_q - \sigma^2\boldsymbol{I}_q\right)\boldsymbol{E}_q^T + \sigma^2\boldsymbol{I}_p \]
com \(\boldsymbol{\Lambda}_q = \operatorname{diag}\left(\lambda_1, \dots, \lambda_q\right)\). Somando a hipótese de normalidade, \(\boldsymbol{x}\sim N_p(\boldsymbol{\mu}, \boldsymbol{\Sigma})\), o modelo ganha uma verossimilhança, e a estimação por máxima verossimilhança devolve as direções principais de sempre e \(\hat\sigma^2 = \sum_{k > q}\lambda_k/(p-q)\), o erro de reconstrução repartido igualmente entre as direções abandonadas.
A escolha por um modelo probabilístico traz algumas vantagens: existem critérios como o AIC e o BIC para escolher \(q\), a estimação pode ser feita por algoritmo EM, que acomoda valores ausentes, e possibilita simular observações ou usar o modelo como componente de uma mistura. Permitir que cada variável tenha o seu próprio nível de ruído, trocando \(\sigma^2\boldsymbol{I}_p\) por uma matriz diagonal qualquer, leva à análise fatorial, que exploraremos no futuro deste livro.
A ACP esparsa (sparse PCA) é uma alternativa mais interpretável. Como os autovetores raramente têm coordenadas nulas, cada componente é uma combinação de todas as \(p\) variáveis, o que dificulta a leitura quando \(p\) é grande. Zerar as cargas pequenas a olho quebra a ortogonalidade e a otimalidade da solução; a ACP esparsa faz isso de maneira controlada, acrescentando uma restrição \(\ell_1\) ao problema de maximização original:
\[ \max_{\boldsymbol{u}} \ \boldsymbol{u}^T\boldsymbol{S}\boldsymbol{u} \quad \text{sujeito a} \quad \|\boldsymbol{u}\|_2 = 1, \quad \|\boldsymbol{u}\|_1 \le c \]
Quanto menor \(c\), mais coordenadas são levadas exatamente a zero. O preço é que os componentes resultantes deixam de ser ortogonais e não correlacionados, e a própria noção de variância explicada precisa ser redefinida.
O t-SNE e o UMAP abandonam a ideia de projeção. Em vez de procurar um subespaço, procuram diretamente uma configuração de pontos em duas dimensões que preserve as vizinhanças locais dos dados. São excelentes para visualizar agrupamentos, mas exigem leitura cuidadosa: não produzem cargas nem matriz de projeção, dependem fortemente de hiperparâmetros e são estocásticos, de modo que execuções distintas geram figuras distintas. Sobretudo, as distâncias entre grupos bem separados na figura e os tamanhos relativos dos agrupamentos não são interpretáveis.