3 A distribuição normal multivariada
O vetor de médias e a matriz de covariâncias descrevem o centro e a variabilidade de um vetor aleatório, mas não determinam sozinhos toda a sua distribuição. A distribuição Normal Multivariada (NMV) é um modelo de referência particularmente útil quando a nuvem de dados tem forma aproximadamente elíptica e quando queremos usar resultados inferenciais clássicos. Ela não deve ser tomada como descrição automática de qualquer conjunto de dados.
Um vetor aleatório \(\boldsymbol{x}\) de dimensão \(p\) segue uma distribuição Normal Multivariada com vetor de médias \(\boldsymbol{\mu}\) e matriz de covariâncias positiva-definida \(\boldsymbol{\Sigma}\), denotada por \(\boldsymbol{x}\sim N_p(\boldsymbol{\mu},\boldsymbol{\Sigma})\), se tem função de densidade
\[ f(\boldsymbol{x})= \frac{1}{(2\pi)^{p/2}\det(\boldsymbol{\Sigma})^{1/2}} \exp\left\{-\frac{1}{2}(\boldsymbol{x}-\boldsymbol{\mu})^T \boldsymbol{\Sigma}^{-1}(\boldsymbol{x}-\boldsymbol{\mu})\right\} \]
A densidade combina dois elementos geométricos:
- A constante normalizadora contém a raiz quadrada da variância generalizada, \(\det(\boldsymbol{\Sigma})^{1/2}\), que quantifica o hipervolume ocupado pela distribuição no espaço \(p\)-dimensional.
- O termo no expoente é a distância de Mahalanobis ao quadrado entre \(\boldsymbol{x}\) e o vetor de médias \(\boldsymbol{\mu}\):
\[ d_M^2(\boldsymbol{x},\boldsymbol{\mu})= (\boldsymbol{x}-\boldsymbol{\mu})^T\boldsymbol{\Sigma}^{-1} (\boldsymbol{x}-\boldsymbol{\mu}) \]
Diferentemente da distância euclidiana usual, \(\|\boldsymbol{x}- \boldsymbol{\mu}\|^2 = (\boldsymbol{x}- \boldsymbol{\mu})^T(\boldsymbol{x}- \boldsymbol{\mu})\), que atribui o mesmo peso a todas as direções e assume variáveis não correlacionadas com mesma escala, a distância de Mahalanobis pondera cada direção pela sua variabilidade e desconta as correlações mútuas. Usando a inversa da raiz quadrada \(\boldsymbol{\Sigma}^{-1/2}\), temos \(d_M^2(\boldsymbol{x}, \boldsymbol{\mu}) = \|\boldsymbol{\Sigma}^{-1/2}(\boldsymbol{x}- \boldsymbol{\mu})\|^2\), de modo que pontos com a mesma distância de Mahalanobis ao centro formam contornos de densidade constante e recebem a mesma probabilidade.
3.1 Propriedades da distribuição normal multivariada
As propriedades a seguir explicam por que esse modelo aparece com frequência na teoria multivariada.
Transformações lineares. Se \(\boldsymbol{x}\sim N_p(\boldsymbol{\mu},\boldsymbol{\Sigma})\), então, para uma matriz constante \(\boldsymbol{A}\) de dimensão \(q \times p\) e um vetor constante \(\boldsymbol{b}\) de dimensão \(q \times 1\), \[ \boldsymbol{A}\boldsymbol{x}+\boldsymbol{b}\sim N_q(\boldsymbol{A}\boldsymbol{\mu}+\boldsymbol{b}, \boldsymbol{A}\boldsymbol{\Sigma}\boldsymbol{A}^T) \] Em particular, toda combinação linear escalar \(\boldsymbol{a}^T\boldsymbol{x}\) tem distribuição normal univariada \(N(\boldsymbol{a}^T\boldsymbol{\mu}, \boldsymbol{a}^T\boldsymbol{\Sigma}\boldsymbol{a})\).
Distribuições marginais. Qualquer subconjunto das componentes de um vetor NMV também tem distribuição normal multivariada. Por exemplo, se \(\boldsymbol{x}=(X_1,X_2,X_3)^T\) é NMV, então \((X_1,X_3)^T\) também é NMV.
Covariância zero e independência. Em geral, não correlação não implica independência. Para vetores conjuntamente normais, porém, dois subconjuntos são independentes quando toda a matriz de covariâncias cruzadas entre eles é nula.
Proposição 3.1 (Distribuição de formas quadráticas) Se \(\boldsymbol{x}\sim N_p(\boldsymbol{\mu}, \boldsymbol{\Sigma})\), com \(\boldsymbol{\Sigma}\) positiva-definida, então:
- A distância de Mahalanobis ao quadrado segue uma distribuição qui-quadrado com \(p\) graus de liberdade: \[ d_M^2(\boldsymbol{x}, \boldsymbol{\mu}) = (\boldsymbol{x}- \boldsymbol{\mu})^T\boldsymbol{\Sigma}^{-1}(\boldsymbol{x}- \boldsymbol{\mu}) \sim \chi^2_p \]
- Se \(\boldsymbol{P}\) é uma matriz de projeção simétrica e idempotente de dimensão \(p \times p\) com posto \(r = \operatorname{tr}\left(\boldsymbol{P}\right) \le p\), então: \[ (\boldsymbol{x}- \boldsymbol{\mu})^T \boldsymbol{\Sigma}^{-1/2} \boldsymbol{P} \boldsymbol{\Sigma}^{-1/2} (\boldsymbol{x}- \boldsymbol{\mu}) \sim \chi^2_r \]
Nota
A propriedade \(d_M^2(\boldsymbol{x}, \boldsymbol{\mu}) \sim \chi^2_p\) é a base para o diagnóstico de normalidade multivariada na prática. Dada uma amostra \(\boldsymbol{x}_1, \dots, \boldsymbol{x}_n\), calculamos as distâncias amostrais \(d_i^2 = (\boldsymbol{x}_i - \bar{\boldsymbol{x}})^T\boldsymbol{S}^{-1}(\boldsymbol{x}_i - \bar{\boldsymbol{x}})\). Se os dados forem aproximadamente normais, o gráfico de quantis amostrais de \(d_i^2\) contra os quantis teóricos da distribuição \(\chi^2_p\) (gráfico quantil-quantil qui-quadrado) deve se alinhar próximo a uma reta.
3.2 Visualizando a normal bivariada
No caso bivariado, os conjuntos de pontos com a mesma densidade satisfazem
\[ (\boldsymbol{x}-\boldsymbol{\mu})^T\boldsymbol{\Sigma}^{-1} (\boldsymbol{x}-\boldsymbol{\mu})=c^2 \]
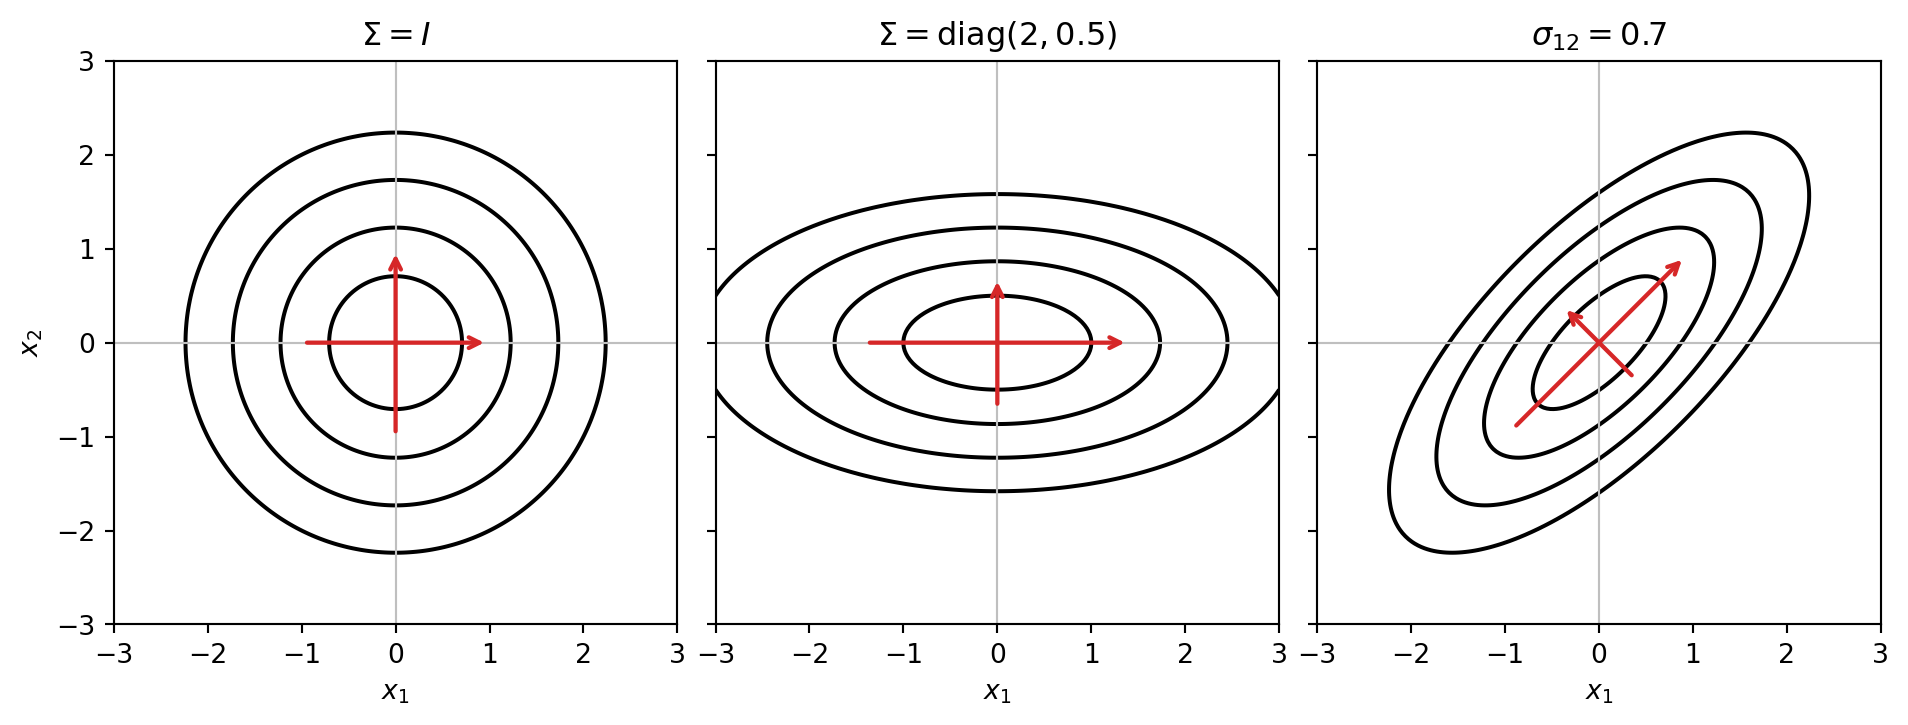
São elipses centradas em \(\boldsymbol{\mu}\). Os autovetores de \(\boldsymbol{\Sigma}\) apontam para seus eixos; os comprimentos dos semieixos são proporcionais às raízes quadradas dos autovalores. A Figura 3.1 mostra três possibilidades.
Quando a covariância é zero e as variâncias são iguais, os contornos são círculos. Com variâncias diferentes e covariância zero, eles permanecem alinhados aos eixos originais. Quando há covariância, os eixos principais se rotacionam.
A normalidade multivariada é um modelo de referência importante para métodos de classificação e inferência baseados em verossimilhança. Já métodos puramente descritivos e geométricos podem ser aplicados sem assumir normalidade, alterando-se principalmente a interpretação inferencial dos resultados.
3.3 Exercícios
Exercício 3.1 Seja \(\boldsymbol{x}= (X_1, X_2)^T \sim N_2(\boldsymbol{\mu}, \boldsymbol{\Sigma})\), com
\[ \boldsymbol{\mu}= \begin{pmatrix} 2 \\ 1 \end{pmatrix} \qquad\text{e}\qquad \boldsymbol{\Sigma}= \begin{pmatrix} 4 & 1 \\ 1 & 1 \end{pmatrix} \]
a) Determine a distribuição marginal de \(X_1\) e a distribuição marginal de \(X_2\).
b) Encontre a distribuição da combinação linear \(Y = X_1 - 2X_2\).
c) Determine o valor da constante \(c\) para que a combinação linear \(Z = X_1 + cX_2\) seja independente de \(Y\).
Exercício 3.2 Considere um vetor aleatório \(\boldsymbol{x}\sim N_2(\boldsymbol{0}, \boldsymbol{\Sigma})\), com \(\boldsymbol{\Sigma}= \begin{pmatrix} 2 & 1 \\ 1 & 2 \end{pmatrix}\).
a) Calcule a matriz inversa \(\boldsymbol{\Sigma}^{-1}\) e a distância de Mahalanobis ao quadrado \(d_M^2(\boldsymbol{x}, \boldsymbol{0})\) para o ponto \(\boldsymbol{x}= (1, 1)^T\).
b) Determine a equação da elipse que delimita a região de 95% de probabilidade para \(\boldsymbol{x}\), sabendo que o quantil de 95% da distribuição \(\chi^2_2\) é aproximadamente \(5{,}99\).
Exercício 3.3 Seja \(\boldsymbol{x}\sim N_p(\boldsymbol{\mu}, \boldsymbol{\Sigma})\) com \(\boldsymbol{\Sigma}\) positiva-definida. Mostre que o vetor padronizado \(\boldsymbol{z} = \boldsymbol{\Sigma}^{-1/2}(\boldsymbol{x}- \boldsymbol{\mu})\) tem distribuição \(N_p(\boldsymbol{0}, \boldsymbol{I})\). Em seguida, use esse resultado para provar que a distância de Mahalanobis ao quadrado \(d_M^2(\boldsymbol{x}, \boldsymbol{\mu}) = \boldsymbol{z}^T\boldsymbol{z}\) segue uma distribuição \(\chi^2_p\).