flowchart TD
    F(("Renda")):::latente
    E1(("ε₁")):::erro
    E2(("ε₂")):::erro
    E3(("ε₃")):::erro
    X1["Educação"]:::obs
    X2["Cultura"]:::obs
    X3["Alimentação"]:::obs

    %% Ligações invisíveis apenas para separar o fator dos termos específicos.
    F ~~~ E1
    F ~~~ E2
    F ~~~ E3

    E1 --> X1
    E2 --> X2
    E3 --> X3

    F -->|ℓ₁| X1
    F -->|ℓ₂| X2
    F -->|ℓ₃| X3

    classDef latente fill:#fff,stroke:#C44E52,stroke-width:2px,color:#C44E52
    classDef obs fill:#fff,stroke:#4C78A8,stroke-width:2px,color:#4C78A8
    classDef erro fill:#fff,stroke:#888,stroke-width:1.5px,color:#555
6 Análise fatorial
Suponha que registramos, para várias famílias, o gasto mensal em educação, em cultura e em alimentação. As três variáveis caminham juntas, e não é difícil dizer por quê. Famílias com mais renda gastam mais em tudo. A renda não aparece na nossa tabela, mas é ela que amarra os três gastos.
A análise fatorial (AF) parte dessa ideia. Ela supõe que por trás das variáveis medidas existem algumas poucas variáveis não observáveis, os fatores comuns, e que é a ação delas que produz as correlações que vemos. No exemplo dos gastos, um único fator, a renda familiar, influencia os três ao mesmo tempo. Cada gasto guarda ainda uma parcela própria, que não é compartilhada com os demais e recolhe tanto as idiossincrasias daquela variável quanto o erro de medida.
Repare para onde apontam as setas da Figura 6.1. Todas chegam às variáveis observadas, porque são o fator e os termos específicos que as geram. As cargas \(\ell_j\) medem a força de cada influência, e estimá-las sem nunca observar o que está no alto do diagrama é o problema deste capítulo.
6.1 O modelo fatorial ortogonal
Definição 6.1 (Modelo fatorial ortogonal) Seja \(\boldsymbol{x}\) um vetor aleatório de \(p\) variáveis observadas, com vetor de médias \(\boldsymbol{\mu}\) e matriz de covariâncias \(\boldsymbol{\Sigma}\). O modelo fatorial ortogonal com \(m\) fatores comuns, \(m < p\), escreve
\[ \boldsymbol{x}- \boldsymbol{\mu}= \boldsymbol{L}\boldsymbol{F} + \boldsymbol{\epsilon} \tag{6.1}\]
em que \(\boldsymbol{L}\) é a matriz \(p \times m\) de cargas fatoriais, \(\boldsymbol{F} = (F_1, \dots, F_m)^T\) reúne os fatores comuns e \(\boldsymbol{\epsilon} = (\epsilon_1, \dots, \epsilon_p)^T\) reúne os fatores específicos. O elemento \(\ell_{jk}\) de \(\boldsymbol{L}\) mede quanto o fator \(F_k\) pesa sobre a variável \(X_j\).
O modelo supõe ainda que
\[ \operatorname{E}\left[\boldsymbol{F}\right] = \boldsymbol{0}, \qquad \operatorname{Cov}\left(\boldsymbol{F}\right) = \boldsymbol{I}_m \]
\[ \operatorname{E}\left[\boldsymbol{\epsilon}\right] = \boldsymbol{0}, \qquad \operatorname{Cov}\left(\boldsymbol{\epsilon}\right) = \boldsymbol{\Psi} = \operatorname{diag}\left(\psi_1, \dots, \psi_p\right) \]
\[ \operatorname{Cov}\left(\boldsymbol{F}, \boldsymbol{\epsilon}\right) = \boldsymbol{0} \]
A exigência \(\operatorname{Cov}\left(\boldsymbol{F}\right) = \boldsymbol{I}_m\) fixa a escala dos fatores e dá nome ao modelo. A restrição que pesa é a de \(\boldsymbol{\Psi}\) diagonal, que obriga toda a correlação entre as variáveis a passar pelos fatores comuns. Os dados podem contrariá-la.
Teorema 6.1 (Estrutura da matriz de covariâncias) Sob as suposições da Definição 6.1, a matriz de covariâncias de \(\boldsymbol{x}\) é
\[ \boldsymbol{\Sigma}= \boldsymbol{L}\boldsymbol{L}^T + \boldsymbol{\Psi} \tag{6.2}\]
Prova. Como \(\boldsymbol{x}- \boldsymbol{\mu}= \boldsymbol{L}\boldsymbol{F} + \boldsymbol{\epsilon}\) e ambos os termos têm média zero,
\[ \begin{aligned} \boldsymbol{\Sigma} &= \operatorname{E}\left[(\boldsymbol{L}\boldsymbol{F} + \boldsymbol{\epsilon})(\boldsymbol{L}\boldsymbol{F} + \boldsymbol{\epsilon})^T\right] \\ &= \boldsymbol{L}\operatorname{E}\left[\boldsymbol{F}\boldsymbol{F}^T\right]\boldsymbol{L}^T + \boldsymbol{L}\operatorname{E}\left[\boldsymbol{F}\boldsymbol{\epsilon}^T\right] + \operatorname{E}\left[\boldsymbol{\epsilon}\boldsymbol{F}^T\right]\boldsymbol{L}^T + \operatorname{E}\left[\boldsymbol{\epsilon}\boldsymbol{\epsilon}^T\right] \end{aligned} \]
As três suposições do modelo dão \(\operatorname{E}\left[\boldsymbol{F}\boldsymbol{F}^T\right] = \boldsymbol{I}_m\), \(\operatorname{E}\left[\boldsymbol{\epsilon}\boldsymbol{\epsilon}^T\right] = \boldsymbol{\Psi}\) e \(\operatorname{E}\left[\boldsymbol{F}\boldsymbol{\epsilon}^T\right] = \boldsymbol{0}\), de modo que os dois termos cruzados desaparecem e sobra
\[ \boldsymbol{\Sigma}= \boldsymbol{L}\boldsymbol{I}_m\boldsymbol{L}^T + \boldsymbol{\Psi} = \boldsymbol{L}\boldsymbol{L}^T + \boldsymbol{\Psi} \]
A Equação 6.2 divide a matriz de covariâncias em duas partes com papéis distintos. A parcela \(\boldsymbol{L}\boldsymbol{L}^T\) é compartilhada e tem posto \(m\), bem menor que \(p\); a parcela \(\boldsymbol{\Psi}\) é diagonal e privativa de cada variável. Como \(\boldsymbol{\Psi}\) não contribui para nada fora da diagonal, toda a covariância entre variáveis diferentes fica por conta de \(\boldsymbol{L}\boldsymbol{L}^T\). Para \(j \neq j'\),
\[ \operatorname{Cov}\left(X_j, X_{j'}\right) = \sum_{k=1}^m \ell_{jk}\ell_{j'k} \]
Na diagonal, a mesma equação reparte a variância de cada variável. Escrevendo \(\sigma_{jj} = \operatorname{Var}\left(X_j\right)\) e tomando o elemento \((j,j)\) de \(\boldsymbol{L}\boldsymbol{L}^T\),
\[ \sigma_{jj} = \underbrace{\sum_{k=1}^m \ell_{jk}^2}_{h_j^2} + \psi_j \]
A quantidade \(h_j^2\) é a comunalidade de \(X_j\), a parte da variância que a variável divide com as demais por intermédio dos fatores comuns. O que resta, \(\psi_j\), é a variância específica, e inclui tanto aquilo que é próprio da variável quanto o erro de medida. Quando a AF é feita sobre a matriz de correlações, todas as variâncias valem 1 e a leitura fica ainda mais direta, com \(h_j^2 + \psi_j = 1\).
Há também uma consequência prática da estrutura do modelo que ajuda na hora de interpretar as cargas. Como \(\operatorname{Cov}\left(\boldsymbol{x}, \boldsymbol{F}\right) = \operatorname{E}\left[(\boldsymbol{L}\boldsymbol{F} + \boldsymbol{\epsilon})\boldsymbol{F}^T\right] = \boldsymbol{L}\), a carga \(\ell_{jk}\) é exatamente a covariância entre a variável \(X_j\) e o fator \(F_k\). Se trabalhamos com variáveis padronizadas, ela é a própria correlação entre as duas, e portanto vive entre \(-1\) e \(1\).
Exemplo 6.1 (Gastos familiares) Retomemos os três gastos da abertura do capítulo, agora padronizados, com a matriz de correlações
\[ \boldsymbol{R}= \begin{pmatrix} 1.00 & 0.56 & 0.48 \\ 0.56 & 1.00 & 0.42 \\ 0.48 & 0.42 & 1.00 \end{pmatrix} \]
Vamos procurar um único fator comum, \(m = 1\). Nesse caso \(\boldsymbol{L}\) é um vetor de três cargas e o modelo diz que \(\rho_{jj'} = \ell_j\ell_{j'}\) para \(j \neq j'\). Temos três equações e três incógnitas:
\[ \ell_1\ell_2 = 0.56, \qquad \ell_1\ell_3 = 0.48, \qquad \ell_2\ell_3 = 0.42 \]
Multiplicando as duas primeiras e dividindo pela terceira, os fatores \(\ell_2\) e \(\ell_3\) se cancelam e sobra \(\ell_1^2\):
\[ \ell_1^2 = \frac{(\ell_1\ell_2)(\ell_1\ell_3)}{\ell_2\ell_3} = \frac{0.56 \times 0.48}{0.42} = 0.64 \]
Logo \(\ell_1 = 0.8\), e as outras duas saem por substituição, \(\ell_2 = 0.7\) e \(\ell_3 = 0.6\). As comunalidades são \(h_1^2 = 0.64\), \(h_2^2 = 0.49\) e \(h_3^2 = 0.36\), e as variâncias específicas, \(\psi_j = 1 - h_j^2\), valem \(0.36\), \(0.51\) e \(0.64\).
\[ \boldsymbol{L} = \begin{pmatrix} 0.8 \\ 0.7 \\ 0.6 \end{pmatrix}, \qquad \boldsymbol{\Psi} = \begin{pmatrix} 0.36 & 0 & 0 \\ 0 & 0.51 & 0 \\ 0 & 0 & 0.64 \end{pmatrix} \]
Multiplicando de volta, \(\boldsymbol{L}\boldsymbol{L}^T + \boldsymbol{\Psi}\) devolve \(\boldsymbol{R}\) exatamente. O gasto em educação é o mais ligado à renda, com 64% da sua variância explicada pelo fator; o gasto em alimentação é o menos ligado, com 36%, o que faz sentido, já que alimentação tem um piso que independe de quanto a família ganha.
6.2 Indeterminação e identificabilidade
Três variáveis e um fator produziram, no Exemplo 6.1, um sistema com solução única e exata. O caso geral não é assim. Três complicações aparecem na prática.
A primeira é que, mesmo quando existe, a solução não é uma só. Seja \(\boldsymbol{T}\) uma matriz ortogonal \(m \times m\) qualquer, isto é, \(\boldsymbol{T}\boldsymbol{T}^T = \boldsymbol{T}^T\boldsymbol{T} = \boldsymbol{I}_m\). Definindo \(\boldsymbol{L}^* = \boldsymbol{L}\boldsymbol{T}\) e \(\boldsymbol{F}^* = \boldsymbol{T}^T\boldsymbol{F}\), o modelo permanece intacto, porque \(\boldsymbol{L}^*\boldsymbol{F}^* = \boldsymbol{L}\boldsymbol{T}\boldsymbol{T}^T\boldsymbol{F} = \boldsymbol{L}\boldsymbol{F}\), e a estrutura de covariâncias também:
\[ \boldsymbol{L}^*(\boldsymbol{L}^*)^T = \boldsymbol{L}\boldsymbol{T}\boldsymbol{T}^T\boldsymbol{L}^T = \boldsymbol{L}\boldsymbol{L}^T \]
Os novos fatores continuam com média zero e covariância \(\operatorname{Cov}\left(\boldsymbol{T}^T\boldsymbol{F}\right) = \boldsymbol{T}^T\boldsymbol{I}_m\boldsymbol{T} = \boldsymbol{I}_m\), e \(\boldsymbol{\Psi}\) nem foi tocada. Ou seja, qualquer rotação rígida dos eixos fatoriais produz um modelo que se ajusta aos dados exatamente igual ao original. As comunalidades, que só dependem de \(\boldsymbol{L}\boldsymbol{L}^T\), tampouco mudam.
Essa indeterminação acaba sendo útil. Como nenhuma escolha de orientação é melhor do que outra do ponto de vista do ajuste, ficamos livres para escolher a que for mais fácil de ler. É essa liberdade que a rotação fatorial explora, e voltaremos a ela adiante.
A segunda complicação é mais banal, e é de contagem. A Equação 6.2 pede que \(p(p+1)/2\) números distintos de \(\boldsymbol{\Sigma}\) sejam reproduzidos por \(\boldsymbol{L}\) e \(\boldsymbol{\Psi}\), que trazem \(pm + p = p(m+1)\) parâmetros. Mas acabamos de ver que \(\boldsymbol{L}\) tem um excesso de \(m(m-1)/2\) graus de liberdade, que é a dimensão do conjunto das matrizes ortogonais \(m \times m\) e corresponde à rotação que não altera nada. Descontando esse excesso, o modelo tem
\[ p(m+1) - \frac{m(m-1)}{2} \]
parâmetros realmente livres, e sobram
\[ \text{gl} = \frac{p(p+1)}{2} - p(m+1) + \frac{m(m-1)}{2} = \frac{1}{2}\left[(p-m)^2 - (p+m)\right] \tag{6.3}\]
graus de liberdade. Quando \(\text{gl} > 0\), o modelo impõe restrições sobre \(\boldsymbol{\Sigma}\) que os dados podem contrariar, e faz sentido testá-lo. Quando \(\text{gl} = 0\), há tantos parâmetros quanto equações e o modelo em geral reproduz \(\boldsymbol{\Sigma}\) exatamente, sem que isso conte como evidência a seu favor. Quando \(\text{gl} < 0\), pedimos fatores demais e o modelo sequer está identificado.
Foi exatamente o que aconteceu no Exemplo 6.1. Com \(p = 3\) e \(m = 1\), a Equação 6.3 dá \(\frac{1}{2}[(3-1)^2 - 4] = 0\). O ajuste perfeito estava garantido de antemão pela contagem, e não diz nada sobre a qualidade do modelo. Já com \(p = 25\) e \(m = 5\), como no Exemplo 6.5, sobram 185 graus de liberdade, e aí o ajuste passa a ser informativo.
A contagem garante que existam parâmetros suficientes, mas não garante que a solução encontrada seja admissível. Como \(\psi_j\) é uma variância, precisa ser não negativa, e como \(h_j^2\) é uma parcela da variância total, não pode ultrapassá-la. Nada no sistema de equações impõe isso, e soluções que violam essas restrições aparecem com alguma frequência. São os chamados casos de Heywood, a terceira complicação.
Exemplo 6.2 (Caso de Heywood) Suponha que, para três variáveis padronizadas, a matriz de correlações observada seja
\[ \boldsymbol{R}= \begin{pmatrix} 1.0 & 0.4 & 0.9 \\ 0.4 & 1.0 & 0.7 \\ 0.9 & 0.7 & 1.0 \end{pmatrix} \]
Repetindo a conta do Exemplo 6.1 para a terceira variável,
\[ \ell_3^2 = \frac{(\ell_1\ell_3)(\ell_2\ell_3)}{\ell_1\ell_2} = \frac{0.9 \times 0.7}{0.4} = 1.575 \]
A comunalidade \(h_3^2 = 1.575\) excede a variância total da variável, que é 1, e a variância específica correspondente seria \(\psi_3 = 1 - 1.575 = -0.575\). Não existe modelo de um fator compatível com essas correlações.
As causas são poucas. Às vezes pedimos fatores demais e a estimação tenta espremer variância que não existe; às vezes pedimos de menos, e uma variável que precisaria de um fator só para ela acaba forçada a se explicar pelo que há. Amostras pequenas também produzem casos de Heywood por puro ruído. Encontrar um é motivo para reconsiderar o número de fatores ou a inclusão de alguma variável. Truncar a estimativa em zero e seguir em frente esconde o problema.
6.3 Adequação dos dados
O modelo fatorial vive das correlações entre as variáveis. Se elas forem fracas, não há estrutura compartilhada para extrair, e a AF devolve fatores que são pouco mais que ruído reorganizado. Dois diagnósticos simples dizem se vale a pena seguir adiante.
O teste de esfericidade de Bartlett confronta a hipótese \(H_0: \boldsymbol{\rho}= \boldsymbol{I}_p\), isto é, a de que as variáveis são todas não correlacionadas na população. A estatística usa o determinante da matriz de correlações amostral, que vale 1 sob \(H_0\) e se aproxima de zero conforme as variáveis ficam mais associadas:
\[ \chi^2 = -\left[(n-1) - \frac{2p+5}{6}\right]\ln|\boldsymbol{R}| \]
Sob \(H_0\), ela segue aproximadamente uma distribuição \(\chi^2\) com \(p(p-1)/2\) graus de liberdade, e um valor grande leva à rejeição. Só que a hipótese nula é pessimista demais, porque afirma ausência completa de correlação, e com amostras grandes ela é rejeitada mesmo quando as correlações são pequenas demais para sustentar uma análise fatorial.
A medida de Kaiser-Meyer-Olkin faz uma pergunta mais fina. Se duas variáveis estão correlacionadas porque compartilham fatores com todas as outras, então controlar pelas demais deve reduzir bastante essa correlação. Se, ao contrário, a associação entre elas é específica do par, a correlação parcial sobrevive ao controle. O KMO compara as duas coisas:
\[ \operatorname{KMO}= \frac{\sum_{j \neq j'} r_{jj'}^2}{\sum_{j \neq j'} r_{jj'}^2 + \sum_{j \neq j'} a_{jj'}^2} \]
em que \(r_{jj'}\) é a correlação simples e \(a_{jj'}\) a correlação parcial entre \(X_j\) e \(X_{j'}\), controlando pelas demais variáveis. O índice fica entre 0 e 1, e cresce conforme as correlações parciais encolhem diante das simples, que é o cenário favorável à AF.
Na prática, valores acima de 0.8 são confortáveis e valores acima de 0.6 costumam ser aceitáveis; abaixo de 0.5 a análise fatorial é desaconselhada. A mesma fórmula pode ser calculada variável a variável, usando apenas as linhas correspondentes dos somatórios, e essa versão individual costuma ser mais útil, porque aponta qual variável está atrapalhando.
6.4 Métodos de estimação
Na prática não conhecemos \(\boldsymbol{\Sigma}\), e sim a matriz de covariâncias amostral \(\boldsymbol{S}\), ou a matriz de correlações \(\boldsymbol{R}\) quando as variáveis foram padronizadas. O problema passa a ser encontrar \(\hat{\boldsymbol{L}}\) e \(\hat{\boldsymbol{\Psi}}\) tais que \(\hat{\boldsymbol{L}}\hat{\boldsymbol{L}}^T + \hat{\boldsymbol{\Psi}}\) se aproxime o máximo possível de \(\boldsymbol{S}\). Como em toda a segunda parte do livro, as quantidades estimadas são análogas amostrais das populacionais, e a interpretação não muda.
Os três métodos a seguir formam uma progressão. O de componentes principais é direto e explícito, e serve de ponto de partida. A fatoração do eixo principal corrige o defeito do primeiro. E a máxima verossimilhança acrescenta um modelo probabilístico, e com ele a possibilidade de testar hipóteses.
A decomposição espectral (Teorema 2.1) escreve a matriz de covariâncias amostral como uma soma de \(p\) parcelas de posto um,
\[ \boldsymbol{S}= \sum_{k=1}^p \hat{\lambda}_k \hat{\boldsymbol{e}}_k\hat{\boldsymbol{e}}_k^T \]
com os autovalores em ordem decrescente. Se as primeiras parcelas concentram a maior parte da variabilidade, é razoável reter apenas \(m\) delas e chamar o resto de variância específica. Como \(\hat{\lambda}_k\hat{\boldsymbol{e}}_k\hat{\boldsymbol{e}}_k^T = (\sqrt{\hat{\lambda}_k}\hat{\boldsymbol{e}}_k)(\sqrt{\hat{\lambda}_k}\hat{\boldsymbol{e}}_k)^T\), cada parcela já tem a forma de uma coluna de \(\boldsymbol{L}\) multiplicada por si mesma.
Definição 6.2 (Solução por componentes principais) Sejam \((\hat{\lambda}_k, \hat{\boldsymbol{e}}_k)\), \(k = 1, \dots, p\), os pares de autovalor e autovetor de \(\boldsymbol{S}\), com \(\hat{\lambda}_1 \ge \dots \ge \hat{\lambda}_p\). A solução por componentes principais com \(m\) fatores é
\[ \hat{\boldsymbol{L}} = \left[\sqrt{\hat{\lambda}_1}\hat{\boldsymbol{e}}_1 \ \middle|\ \sqrt{\hat{\lambda}_2}\hat{\boldsymbol{e}}_2 \ \middle|\ \cdots \ \middle|\ \sqrt{\hat{\lambda}_m}\hat{\boldsymbol{e}}_m \right] \]
\[ \hat{\boldsymbol{\Psi}} = \operatorname{diag}\left(\boldsymbol{S}- \hat{\boldsymbol{L}}\hat{\boldsymbol{L}}^T\right), \qquad \hat{\psi}_j = s_{jj} - \sum_{k=1}^m \hat{\ell}_{jk}^2 \]
Quando a análise parte da matriz de correlações, basta trocar \(\boldsymbol{S}\) por \(\boldsymbol{R}\), e as variâncias específicas passam a ser \(\hat{\psi}_j = 1 - \sum_{k=1}^m \hat{\ell}_{jk}^2\).
Por construção, \(\hat{\boldsymbol{\Psi}}\) é definida para absorver o que faltar na diagonal, de modo que \(\hat{\boldsymbol{\Sigma}} = \hat{\boldsymbol{L}}\hat{\boldsymbol{L}}^T + \hat{\boldsymbol{\Psi}}\) reproduz exatamente as variâncias amostrais. O preço é que nada garante bom ajuste fora da diagonal, que é onde estão as correlações. Pode-se mostrar que a soma dos quadrados dos resíduos, que só aparecem fora da diagonal, satisfaz
\[ \sum_{j \neq j'} \left(s_{jj'} - \sum_{k=1}^m \hat{\ell}_{jk}\hat{\ell}_{j'k}\right)^2 \le \hat{\lambda}_{m+1}^2 + \dots + \hat{\lambda}_p^2 \]
o que dá um critério prático. Se os autovalores descartados forem pequenos, o ajuste será bom.
Exemplo 6.3 Vamos aplicar a Definição 6.2 à matriz de correlações dos gastos familiares do Exemplo 6.1, para a qual já conhecemos a resposta exata. Os autovalores de \(\boldsymbol{R}\) são \(1.9756\), \(0.5930\) e \(0.4314\). Retendo o primeiro, as cargas estimadas são \(\sqrt{1.9756}\,\hat{\boldsymbol{e}}_1\), o que dá
\[ \hat{\boldsymbol{L}}_{\text{CP}} = \begin{pmatrix} 0.847 \\ 0.817 \\ 0.768 \end{pmatrix} \]
contra o valor exato \((0.8,\ 0.7,\ 0.6)^T\). Todas as cargas vieram infladas, e as comunalidades também, que ficaram em \(0.718\), \(0.668\) e \(0.591\) no lugar de \(0.64\), \(0.49\) e \(0.36\). A matriz de resíduos fora da diagonal é
\[ \boldsymbol{R}- \hat{\boldsymbol{\Sigma}} = \begin{pmatrix} 0 & -0.132 & -0.171 \\ -0.132 & 0 & -0.208 \\ -0.171 & -0.208 & 0 \end{pmatrix} \]
A diagonal saiu exata, como prometido, e todas as correlações erraram por margens consideráveis, embora exista uma solução exata para esses dados.
Aqui aparece a diferença entre as duas técnicas. A ACP procura direções que retenham a variância total das variáveis, e por isso coloca na diagonal de \(\hat{\boldsymbol{\Sigma}}\) toda a variância de cada variável, inclusive a parte específica que nenhum fator comum poderia explicar. Essa variância específica, empurrada para dentro das cargas, é o que as infla. A AF propriamente dita mira outra coisa, a covariância compartilhada, e aceita de saída que parte da variância de cada variável fique de fora.
Isso não torna o método de componentes principais inútil. Ele é barato, sempre devolve uma resposta e funciona razoavelmente bem quando as comunalidades são altas, porque aí a parte específica é pequena e o viés também. E serve de ponto de partida para os métodos iterativos.
Se o problema do método anterior é colocar variância específica onde deveria haver apenas comunalidade, a correção é direta. Em vez de decompor \(\boldsymbol{R}\), decomponha a matriz de correlações com as comunalidades no lugar dos uns da diagonal. Essa matriz é chamada de matriz de correlações reduzida,
\[ \boldsymbol{R}_r = \boldsymbol{R}- \hat{\boldsymbol{\Psi}} \]
cuja diagonal traz \(h_j^2\) em vez de 1. O problema é que as comunalidades são justamente o que queremos estimar. A saída é iterar. Partimos de um palpite inicial para \(h_j^2\), decompomos \(\boldsymbol{R}_r\), lemos novas cargas e com elas novas comunalidades, repondo-as na diagonal e repetindo até que parem de mudar. O palpite inicial usual é o quadrado do coeficiente de correlação múltipla de cada variável contra todas as outras, que se obtém de \(\boldsymbol{R}\) por \(h_j^2 = 1 - 1/[\boldsymbol{R}^{-1}]_{jj}\) e é um limite inferior razoável para a comunalidade.
Exemplo 6.4 Nos dados de gastos, as comunalidades iniciais são \(0.386\), \(0.343\) e \(0.264\). A primeira iteração devolve cargas \((0.714,\ 0.670,\ 0.595)^T\), já bem mais próximas da resposta exata do que as do método de componentes principais. Na décima iteração estamos em \((0.796,\ 0.703,\ 0.601)^T\), e o procedimento converge para \((0.8,\ 0.7,\ 0.6)^T\), recuperando exatamente a solução do Exemplo 6.1, com \(\hat{\psi} = (0.36,\ 0.51,\ 0.64)^T\).
O método é simples e costuma funcionar bem. Em compensação, não há garantia de convergência, e é justamente durante a iteração que os casos de Heywood aparecem, com alguma comunalidade crescendo acima de 1 ao longo do caminho. Também não há um modelo probabilístico por trás, o que impede testar formalmente o número de fatores.
Para chegar a um teste, precisamos de uma distribuição. Supondo que os fatores e os erros sejam normais, \(\boldsymbol{F} \sim N_m(\boldsymbol{0}, \boldsymbol{I}_m)\) e \(\boldsymbol{\epsilon} \sim N_p(\boldsymbol{0}, \boldsymbol{\Psi})\), independentes entre si, o vetor observado herda a normalidade (ver Capítulo 3) e temos \(\boldsymbol{x}\sim N_p(\boldsymbol{\mu}, \boldsymbol{L}\boldsymbol{L}^T + \boldsymbol{\Psi})\). A log-verossimilhança de uma amostra aleatória, descartando constantes e já maximizada em \(\boldsymbol{\mu}\), é
\[ \ell(\boldsymbol{L}, \boldsymbol{\Psi}) = -\frac{n}{2}\left[\ln|\boldsymbol{\Sigma}| + \operatorname{tr}\left(\boldsymbol{\Sigma}^{-1}\boldsymbol{S}\right)\right] \]
com \(\boldsymbol{\Sigma}= \boldsymbol{L}\boldsymbol{L}^T + \boldsymbol{\Psi}\). Maximizar essa função equivale a minimizar a discrepância entre \(\boldsymbol{S}\) e a matriz implicada pelo modelo, e a solução não tem forma fechada, sendo obtida por algoritmos iterativos. Como a rotação não altera a verossimilhança, é preciso impor alguma condição que fixe a orientação, e a escolha convencional é exigir que \(\boldsymbol{L}^T\boldsymbol{\Psi}^{-1}\boldsymbol{L}\) seja diagonal.
Ter uma verossimilhança permite comparar o modelo ajustado com a alternativa irrestrita, em que \(\boldsymbol{\Sigma}\) é qualquer matriz de covariâncias. O teste da razão de verossimilhanças para \(H_0\): “\(m\) fatores bastam” usa
\[ \chi^2 = \left[n - 1 - \frac{2p + 4m + 5}{6}\right]\ln\frac{|\hat{\boldsymbol{L}}\hat{\boldsymbol{L}}^T + \hat{\boldsymbol{\Psi}}|}{|\boldsymbol{S}|} \tag{6.4}\]
comparada a uma \(\chi^2\) com os graus de liberdade da Equação 6.3. O fator entre colchetes é uma correção de Bartlett que melhora a aproximação em amostras moderadas. Valores grandes indicam que a matriz implicada pelo modelo se afasta demais da observada, e levam à rejeição.
Esse teste tem o mesmo problema do teste de esfericidade. Com \(n\) grande, diferenças irrelevantes entre \(\hat{\boldsymbol{\Sigma}}\) e \(\boldsymbol{S}\) produzem estatísticas enormes, e a hipótese acaba rejeitada para todo \(m\) que se tente. Usá-lo como critério único de escolha tende a inflar o número de fatores sem ganho interpretativo.
6.5 Escolha do número de fatores
Decidir \(m\) é a escolha que mais pesa na análise, e nenhum procedimento a resolve sozinho. Fatores de menos deixam correlações importantes por explicar; fatores demais fragmentam a estrutura em pedaços difíceis de nomear e convidam a casos de Heywood. Os critérios disponíveis são quase todos herdados da ACP (Capítulo 4) e devem ser lidos em conjunto.
O critério da variância explicada retém fatores até que a proporção acumulada atinja um patamar considerado suficiente. Em AF esse patamar costuma ser bem mais baixo do que em ACP, porque aqui só a parte comum entra na conta e a variância específica fica de fora por construção. O critério de Kaiser, aplicado à matriz de correlações, retém os fatores com autovalor maior que 1, sob o argumento de que um fator deve ao menos explicar tanto quanto uma variável isolada. Ele é simples e por isso popular, mas tem a tendência conhecida de superestimar \(m\). O gráfico do cotovelo procura visualmente o ponto em que os autovalores passam a decair devagar, e sofre da ambiguidade de que cotovelos diferentes são vistos por leitores diferentes.
A análise paralela é o critério mais confiável do conjunto e deve ser o preferido quando estiver disponível. Em vez de comparar os autovalores com um limiar fixo, ela os compara com a distribuição dos autovalores que se obteria em dados sem nenhuma estrutura, mas com o mesmo \(n\) e o mesmo \(p\). Permuta-se cada coluna da matriz de dados de forma independente, o que destrói as correlações e preserva as distribuições marginais, recalculam-se os autovalores muitas vezes, e retêm-se apenas os fatores cujos autovalores observados superam um percentil alto dessa distribuição nula. O procedimento é descrito com mais detalhe na Seção 4.11.4.
Quando a estimação é por máxima verossimilhança, o teste da Equação 6.4 ainda permite comparar modelos aninhados, com a ressalva sobre amostras grandes já registrada.
Na prática, vale olhar vários critérios ao mesmo tempo e verificar se a solução resultante pode ser interpretada.
6.6 Rotação fatorial
Vimos que \(\boldsymbol{L}\) e \(\boldsymbol{L}\boldsymbol{T}\) ajustam os dados igualmente bem, para qualquer \(\boldsymbol{T}\) ortogonal. Os métodos de estimação entregam uma orientação arbitrária, ditada por conveniências de cálculo, e quase sempre inconveniente para a leitura. O primeiro fator de uma solução não rotacionada, por exemplo, costuma sair como um fator geral com cargas altas em quase tudo, e os seguintes como contrastes bipolares, o que descreve a variabilidade sem ajudar a nomear os fatores.
O alvo da rotação é o que Thurstone chamou de estrutura simples: cada variável carregando forte em um fator e perto de zero nos demais, e cada fator sustentado por um subconjunto claro de variáveis. Com a estrutura simples, nomear os fatores vira uma questão de ler a matriz de cargas.
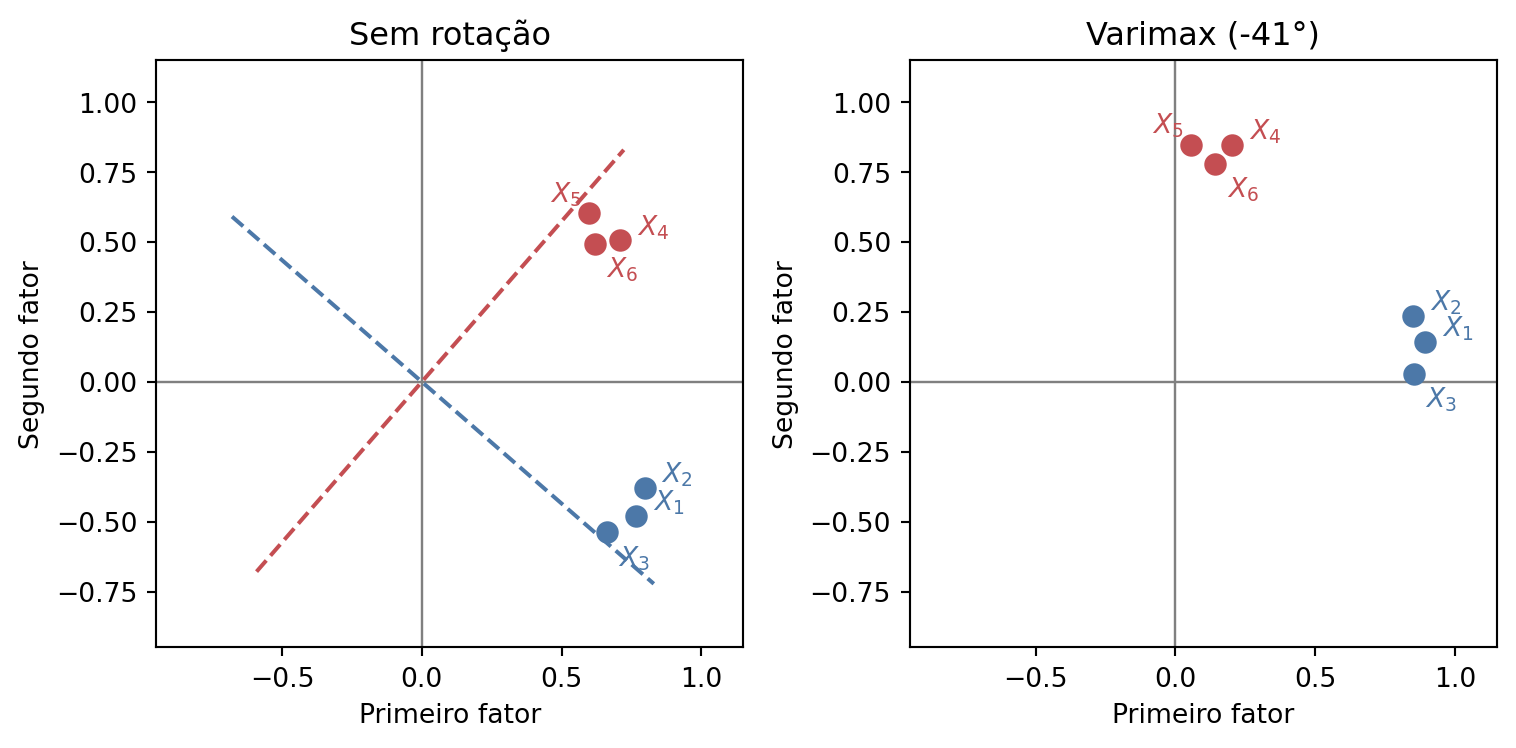
Na Figura 6.2, cada ponto é uma variável, posicionada por suas duas cargas. Na solução não rotacionada, à esquerda, as seis variáveis têm carga alta no primeiro fator e se distinguem apenas pelo sinal do segundo, o que torna os dois fatores difíceis de batizar. Os pontos, porém, já formam dois grupos nítidos, e são os eixos que estão mal posicionados em relação a eles. As linhas tracejadas mostram para onde a rotação varimax leva os eixos, e o painel da direita apresenta o resultado, com cada bloco alinhado a um fator. As distâncias entre os pontos, as comunalidades e o ajuste do modelo são exatamente os mesmos nos dois painéis.
Numa rotação ortogonal, \(\boldsymbol{T}\) é ortogonal e os eixos fatoriais permanecem perpendiculares, de modo que os fatores continuam não correlacionados. O método mais usado é o varimax, que busca simplificar as colunas de \(\boldsymbol{L}\), ou seja, tornar cada fator o mais nítido possível. Ele maximiza a variância das cargas ao quadrado dentro de cada coluna, o que empurra cada carga para perto de zero ou para perto do seu valor máximo, evitando o meio-termo ambíguo. O critério é
\[ V = \sum_{k=1}^m \left[\frac{1}{p}\sum_{j=1}^p \left(\frac{\hat{\ell}^{\,*}_{jk}}{h_j}\right)^4 - \left(\frac{1}{p}\sum_{j=1}^p \left(\frac{\hat{\ell}^{\,*}_{jk}}{h_j}\right)^2\right)^2\right] \]
em que \(\hat{\ell}^{\,*}_{jk}\) são as cargas já rotacionadas. A divisão por \(h_j\) é a normalização de Kaiser, e serve para que variáveis com comunalidade baixa não sejam atropeladas por aquelas com comunalidade alta durante a otimização.
Há alternativas com a mesma mecânica e alvo diferente. O quartimax simplifica as linhas em vez das colunas, procurando fazer com que cada variável carregue em um único fator; por olhar uma linha de cada vez, tende a produzir um fator geral que atrai quase todas as variáveis, o que costuma atrapalhar. O equimax distribui o esforço entre linhas e colunas. Na prática, o varimax dá conta da maioria dos casos.
Nada obriga os fatores a serem não correlacionados. Em boa parte das aplicações, sobretudo nas ciências humanas, não há razão para esperar que sejam. Habilidade verbal e habilidade matemática são construtos distintos e correlacionados, e representá-los por eixos perpendiculares força uma estrutura que os dados não têm.
As rotações oblíquas relaxam essa restrição. A matriz de transformação deixa de ser ortogonal, os eixos passam a formar ângulos diferentes de 90°, e os fatores adquirem uma matriz de correlações \(\boldsymbol{\Phi} = \operatorname{Cov}\left(\boldsymbol{F}\right)\), que deixa de ser a identidade. A estrutura de covariâncias passa a ser
\[ \boldsymbol{\Sigma}= \boldsymbol{L}\boldsymbol{\Phi}\boldsymbol{L}^T + \boldsymbol{\Psi} \tag{6.5}\]
O promax é o método mais comum e funciona em duas etapas. Parte de uma solução varimax, eleva suas cargas a uma potência \(k\) preservando o sinal, o que esmaga as cargas pequenas e quase não mexe nas grandes, e usa o resultado como alvo de um ajuste por mínimos quadrados. É uma estrutura mais simples do que a varimax conseguiria, e o promax procura a transformação oblíqua que mais se aproxima dela. O oblimin direto ataca o problema diretamente, minimizando a covariância entre as cargas ao quadrado de pares de fatores, com um parâmetro que regula quanta correlação se permite.
A leitura de uma solução oblíqua exige um cuidado que não aparece no caso ortogonal. Quando os fatores são correlacionados, duas matrizes diferentes descrevem a relação entre variáveis e fatores. A matriz de padrões é o \(\boldsymbol{L}\) da Equação 6.5, e seus elementos são coeficientes de regressão, isto é, \(\ell_{jk}\) mede o efeito de \(F_k\) sobre \(X_j\) mantidos os demais fatores constantes. A matriz de estrutura é \(\boldsymbol{L}\boldsymbol{\Phi}\), e seus elementos são as correlações simples entre cada variável e cada fator, sem controle algum.
As duas coincidem quando \(\boldsymbol{\Phi} = \boldsymbol{I}_m\), e é por isso que a distinção não aparece na rotação ortogonal. Com fatores correlacionados elas se separam, às vezes bastante, porque uma variável pode se correlacionar com um fator apenas por tabela, através da correlação dele com o fator que de fato a determina. Para nomear fatores e identificar estrutura simples, a matriz de padrões é a indicada, já que ela isola a contribuição de cada fator. A matriz de estrutura responde a uma pergunta diferente, a de quanto cada variável e cada fator andam juntos no total.
6.7 Escores fatoriais
Com as cargas estimadas, falta situar cada indivíduo nos fatores, tal como fizemos com os escores da ACP. Esses valores servem para representar as observações graficamente e para alimentar análises posteriores, usando os fatores no lugar das variáveis originais.
Só que a situação aqui é outra. Os escores da ACP eram \(\boldsymbol{X}\boldsymbol{E}\), uma transformação determinística dos dados, enquanto \(\boldsymbol{F}\) é uma variável aleatória que ninguém viu e que não se escreve como função das variáveis observadas. O melhor que podemos fazer é predizê-la, e métodos diferentes de predição dão respostas diferentes.
O método da regressão, também chamado de método de Thomson, trata o problema como a predição de \(\boldsymbol{F}\) a partir de \(\boldsymbol{x}\) que minimiza o erro quadrático médio. Sob o modelo fatorial, \(\operatorname{Cov}\left(\boldsymbol{F}, \boldsymbol{x}\right) = \boldsymbol{L}^T\) e \(\operatorname{Cov}\left(\boldsymbol{x}\right) = \boldsymbol{\Sigma}\), de modo que a regressão linear de \(\boldsymbol{F}\) em \(\boldsymbol{x}\) tem coeficientes \(\boldsymbol{L}^T\boldsymbol{\Sigma}^{-1}\) e
\[ \hat{\boldsymbol{f}}_i = \hat{\boldsymbol{L}}^T\left(\hat{\boldsymbol{L}}\hat{\boldsymbol{L}}^T + \hat{\boldsymbol{\Psi}}\right)^{-1}(\boldsymbol{x}_i - \bar{\boldsymbol{x}}) \tag{6.6}\]
Esses escores têm o menor erro quadrático médio possível, mas pagam por isso com um viés de encolhimento. Por serem uma média ponderada entre o dado e o zero, que é a média a priori do fator, eles têm variância menor que 1 e ficam sistematicamente mais próximos da origem do que os fatores verdadeiros.
O método de Bartlett escolhe outro compromisso. Ele trata \(\boldsymbol{F}\) como um parâmetro fixo a ser estimado e aplica mínimos quadrados ponderados, usando \(\boldsymbol{\Psi}^{-1}\) como peso, o que faz sentido porque variáveis com variância específica grande são medidas mais ruidosas do fator e devem pesar menos:
\[ \hat{\boldsymbol{f}}_i = \left(\hat{\boldsymbol{L}}^T\hat{\boldsymbol{\Psi}}^{-1}\hat{\boldsymbol{L}}\right)^{-1}\hat{\boldsymbol{L}}^T\hat{\boldsymbol{\Psi}}^{-1}(\boldsymbol{x}_i - \bar{\boldsymbol{x}}) \tag{6.7}\]
Esses escores são não viesados, no sentido de que \(\operatorname{E}\left[\hat{\boldsymbol{f}} \mid \boldsymbol{F}\right] = \boldsymbol{F}\), ao custo de uma variância maior que a do método da regressão. A escolha entre os dois é a escolha usual entre viés e variância. Quando os escores vão ser correlacionados com outras variáveis, o encolhimento do método da regressão pode distorcer as conclusões, e os escores de Bartlett costumam ser preferíveis. Para representação gráfica, a diferença raramente importa.
Quando a solução é oblíqua, ambas as fórmulas se ajustam para acomodar \(\boldsymbol{\Phi}\); no caso da regressão, por exemplo, os coeficientes passam a ser \(\boldsymbol{\Phi}\boldsymbol{L}^T\boldsymbol{\Sigma}^{-1}\).
NotaIndeterminação dos escores
A dificuldade vai além de haver métodos concorrentes. Mesmo que \(\boldsymbol{L}\) e \(\boldsymbol{\Psi}\) fossem conhecidos exatamente, e com \(n\) infinito, os escores fatoriais continuariam indeterminados: existe toda uma família de vetores aleatórios \(\boldsymbol{F}\) compatíveis com o modelo e com os dados observados, e nada nas observações permite escolher entre eles. Esse resultado é conhecido como indeterminação dos escores fatoriais.
A gravidade do problema depende das comunalidades. Quando elas são altas, os candidatos ficam próximos uns dos outros e a indeterminação é inofensiva; quando são baixas, dois conjuntos de escores igualmente válidos podem até correlacionar mal entre si. É mais uma razão para desconfiar de soluções com comunalidades pequenas.
6.8 Exemplo prático
Exemplo 6.5 (Traços de personalidade) O conjunto bfi, do pacote R psych, reúne respostas de 2800 pessoas a 25 itens de personalidade, medidos em escala de 1 a 5. Os itens foram construídos para medir cinco traços, o chamado Big Five, com cinco itens cada: amabilidade (A), conscienciosidade (C), extroversão (E), neuroticismo (N) e abertura à experiência (O). A pergunta que nos interessa é se a análise fatorial, olhando apenas para as correlações entre os itens e sem saber nada sobre essa divisão, consegue recuperá-la.
Código
import pandas as pd
from factor_analyzer import FactorAnalyzer
from factor_analyzer.factor_analyzer import (
    calculate_bartlett_sphericity,
    calculate_kmo,
)

bfi = pd.read_csv("dados/bfi.csv")
itens = [c for c in bfi.columns if c[0] in "ACENO" and c[1:].isdigit()]

# Itens de redação invertida: discordar deles indica mais do traço, não menos.
invertidos = ["A1", "C4", "C5", "E1", "E2", "O2", "O5"]

dados = bfi[itens].dropna().copy()
dados[invertidos] = 6 - dados[invertidos]

n_obs, p_itens = dados.shape
Uma palavra sobre a recodificação. Alguns itens são redigidos ao contrário dos demais para desencorajar respostas automáticas. O item A1, por exemplo, afirma indiferença aos sentimentos alheios, de modo que discordar dele indica mais amabilidade. Sem recodificar, esses itens aparecem com cargas negativas no fator do seu próprio bloco, o que não está errado, mas atrapalha a leitura, e mais adiante inverteria também o sinal das correlações entre os fatores. Subtrair de 6 alinha todos os itens no mesmo sentido.
Restaram 2436 respostas completas para 25 itens, e podemos passar aos diagnósticos.
Código
qui2_bartlett, p_bartlett = calculate_bartlett_sphericity(dados)
kmo_variavel, kmo_total = calculate_kmo(dados)

print(f"Bartlett: qui-quadrado = {qui2_bartlett:.0f}, p-valor = {p_bartlett:.1e}")
print(f"KMO global: {kmo_total:.3f}")
print(f"Menor KMO por variável: {kmo_variavel.min():.3f} ({itens[kmo_variavel.argmin()]})")
Bartlett: qui-quadrado = 18146, p-valor = 0.0e+00
KMO global: 0.849
Menor KMO por variável: 0.754 (A1)O teste de Bartlett rejeita a esfericidade com folga, o que era esperado com uma amostra deste tamanho e apenas descarta o cenário mais pessimista. O KMO global de 0.849 é confortável, e mesmo a variável pior colocada fica bem acima do piso de 0.5. Os dados comportam uma análise fatorial.
Quantos fatores extrair? O critério de Kaiser e a análise paralela não concordam.
Código
R_bfi = np.corrcoef(dados.to_numpy(), rowvar=False)
autovalores_bfi = np.linalg.eigvalsh(R_bfi)[::-1]

# Distribuição nula: permutar cada coluna destrói as correlações
# e preserva as distribuições marginais.
rng = np.random.default_rng(2026)
Z_bfi = dados.to_numpy()
nulos = np.empty((200, p_itens))
for b in range(200):
    Z_perm = np.column_stack(
        [rng.permutation(Z_bfi[:, j]) for j in range(p_itens)]
    )
    nulos[b] = np.linalg.eigvalsh(np.corrcoef(Z_perm, rowvar=False))[::-1]
percentil95 = np.quantile(nulos, 0.95, axis=0)

n_kaiser = int((autovalores_bfi > 1).sum())
n_paralela = int((autovalores_bfi > percentil95).sum())

eixo_fatores = np.arange(1, p_itens + 1)
fig, ax = plt.subplots(figsize=(6, 3.6))
ax.plot(eixo_fatores, autovalores_bfi, "o-", color=cor_obs, linewidth=2,
        markersize=5, label="Autovalores observados")
ax.plot(eixo_fatores, percentil95, "o--", color=cor_fator, linewidth=1.6,
        markersize=4, label="Percentil 95 sob independência")
ax.axhline(1, color="gray", linestyle=":", linewidth=1.3,
           label="Critério de Kaiser")
ax.set(xlabel="Fator", ylabel="Autovalor", xticks=eixo_fatores[::2])
ax.legend(fontsize=8)
plt.tight_layout()
plt.show()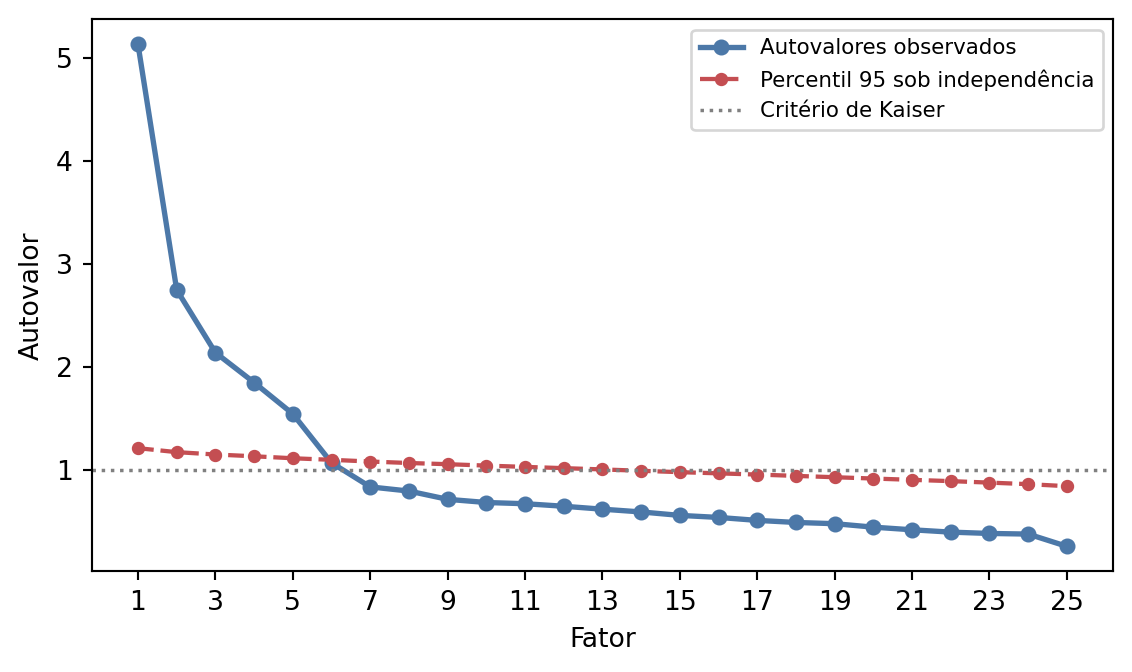
O critério de Kaiser retém 6 fatores e a análise paralela retém 5. A discrepância é a esperada, com o critério de Kaiser pecando pelo excesso. O sexto autovalor vale 1.07, mal ultrapassando 1, enquanto o percentil 95 sob independência naquela posição é 1.10. Ficamos com cinco fatores, decisão que a análise paralela sustenta e que coincide com a estrutura teórica dos itens.
Ajustamos então o modelo por máxima verossimilhança, com rotação varimax.
Código
nomes_fatores = ["N", "E", "C", "A", "O"]

af = FactorAnalyzer(n_factors=5, rotation="varimax", method="ml")
af.fit(dados)

cargas = pd.DataFrame(af.loadings_, index=itens, columns=nomes_fatores)
comunalidades = pd.Series(af.get_communalities(), index=itens)

tabela = cargas.round(2).where(cargas.abs() >= 0.3, "")
tabela["Comunalidade"] = comunalidades.round(2)
tabela| N | E | C | A | O | Comunalidade | |
|---|---|---|---|---|---|---|
| A1 | 0.39 | 0.17 | ||||
| A2 | 0.6 | 0.42 | ||||
| A3 | 0.66 | 0.53 | ||||
| A4 | 0.45 | 0.31 | ||||
| A5 | 0.35 | 0.58 | 0.49 | |||
| C1 | 0.53 | 0.34 | ||||
| C2 | 0.62 | 0.43 | ||||
| C3 | 0.55 | 0.32 | ||||
| C4 | 0.65 | 0.49 | ||||
| C5 | 0.57 | 0.44 | ||||
| E1 | 0.59 | 0.37 | ||||
| E2 | 0.67 | 0.55 | ||||
| E3 | 0.49 | 0.31 | 0.31 | 0.44 | ||
| E4 | 0.61 | 0.36 | 0.53 | |||
| E5 | 0.49 | 0.31 | 0.41 | |||
| N1 | 0.82 | 0.73 | ||||
| N2 | 0.79 | 0.66 | ||||
| N3 | 0.71 | 0.52 | ||||
| N4 | 0.56 | -0.37 | 0.49 | |||
| N5 | 0.52 | 0.34 | ||||
| O1 | 0.52 | 0.33 | ||||
| O2 | 0.45 | 0.26 | ||||
| O3 | 0.61 | 0.48 | ||||
| O4 | 0.37 | 0.25 | ||||
| O5 | 0.51 | 0.27 |
A ordem em que os fatores saem da estimação é arbitrária, e os nomes na tabela foram atribuídos depois de olhar para as cargas. O resultado é bom. Cada bloco de cinco itens se concentra num fator diferente, e a análise recuperou a divisão teórica sem ter acesso a ela.
A estrutura não é perfeita. O item A1 tem a menor comunalidade do conjunto, 0.17, o que significa que quase 83% da sua variância não é compartilhada com ninguém; é um item que mede mal aquilo que deveria medir. O item E3 carrega em extroversão mas reparte o resto entre amabilidade e abertura, e E5 divide-se entre extroversão e conscienciosidade. O caso mais claro é N4, com carga substancial em neuroticismo e carga negativa em extroversão, coerente com o conteúdo do item, que trata de desânimo e abatimento. As comunalidades, em geral entre 0.3 e 0.5, são modestas, o que é normal em itens isolados de questionário e nos lembra que boa parte da variância de cada resposta é específica dela.
Os cinco traços serão mesmo não correlacionados, como a rotação varimax impôs? O promax responde a isso, partindo da própria solução varimax. Vamos implementá-lo à mão, tanto porque o procedimento é curto quanto porque assim fica explícito de onde vêm a matriz de padrões e a matriz de correlações entre fatores.
Código
Lambda = af.loadings_
psi = af.get_uniquenesses()

# Alvo: cargas elevadas a k preservando o sinal, o que esmaga as pequenas.
k_promax = 4
alvo = np.sign(Lambda) * np.abs(Lambda) ** k_promax

# Transformação de mínimos quadrados que leva a solução varimax ao alvo.
Q = np.linalg.solve(Lambda.T @ Lambda, Lambda.T @ alvo)
# Reescala as colunas de Q para que Phi tenha diagonal unitária.
Q = Q * np.sqrt(np.diag(np.linalg.inv(Q.T @ Q)))

padroes = Lambda @ Q
Phi = np.linalg.inv(Q.T @ Q)
estrutura = padroes @ Phi

pd.DataFrame(Phi, index=nomes_fatores, columns=nomes_fatores).round(2)| N | E | C | A | O | |
|---|---|---|---|---|---|
| N | 1.00 | -0.37 | -0.25 | 0.06 | 0.02 |
| E | -0.37 | 1.00 | 0.37 | 0.25 | 0.14 |
| C | -0.25 | 0.37 | 1.00 | 0.22 | 0.24 |
| A | 0.06 | 0.25 | 0.22 | 1.00 | 0.21 |
| O | 0.02 | 0.14 | 0.24 | 0.21 | 1.00 |
A transformação preserva o ajuste, como deve. A raiz do erro quadrático médio dos resíduos fora da diagonal é 0.0286 para a solução oblíqua e exatamente a mesma para a varimax, porque a matriz de padrões \(\boldsymbol{L}_{\text{pro}}\) e as cargas varimax \(\boldsymbol{L}_{\text{var}}\) satisfazem \(\boldsymbol{L}_{\text{pro}}\boldsymbol{\Phi}\boldsymbol{L}_{\text{pro}}^T = \boldsymbol{L}_{\text{var}}\boldsymbol{L}_{\text{var}}^T\).
As correlações entre fatores não são desprezíveis e vão na direção que a literatura de personalidade descreve. Neuroticismo correlaciona-se negativamente com extroversão (-0.37) e com conscienciosidade (-0.25), enquanto extroversão, conscienciosidade, amabilidade e abertura formam um bloco de correlações positivas moderadas. A suposição de ortogonalidade, portanto, era uma simplificação, ainda que não das mais graves.
Nos números, a distinção entre as duas matrizes da solução oblíqua fica visível.
Código
selecao = ["A3", "C4", "E2", "N4"]
comparacao = pd.concat(
    {
        "Padrão": pd.DataFrame(padroes, index=itens, columns=nomes_fatores).loc[selecao],
        "Estrutura": pd.DataFrame(estrutura, index=itens, columns=nomes_fatores).loc[selecao],
    },
    axis=1,
)
comparacao.round(2)| Padrão | Estrutura | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|
| N | E | C | A | O | N | E | C | A | O | |
| A3 | -0.03 | 0.18 | 0.00 | 0.66 | 0.02 | -0.06 | 0.36 | 0.22 | 0.71 | 0.18 |
| C4 | -0.10 | -0.02 | 0.68 | -0.06 | 0.01 | -0.27 | 0.25 | 0.69 | 0.08 | 0.16 |
| E2 | -0.03 | 0.71 | -0.02 | 0.06 | 0.05 | -0.28 | 0.73 | 0.27 | 0.24 | 0.15 |
| N4 | 0.40 | -0.39 | -0.13 | 0.09 | 0.09 | 0.59 | -0.55 | -0.33 | 0.01 | 0.04 |
Veja o item C4, sobre fazer as coisas pela metade. Seu coeficiente de padrão em neuroticismo é pequeno, mas sua correlação com o fator, na matriz de estrutura, é bem maior em módulo. O item mede conscienciosidade, e esse fator anda junto com neuroticismo. É por esse caminho indireto que o item aparece associado a neuroticismo. Ler a matriz de estrutura como se fossem cargas levaria a atribuir ao item um conteúdo que ele não tem, e é por isso que a nomeação dos fatores se faz pela matriz de padrões.
6.9 Exercícios
Exercício 6.1 Considere o modelo fatorial ortogonal \(\boldsymbol{x}- \boldsymbol{\mu}= \boldsymbol{L}\boldsymbol{F} + \boldsymbol{\epsilon}\), sob as suposições da Definição 6.1.
a) Mostre que \(\operatorname{Cov}\left(\boldsymbol{x}\right) = \boldsymbol{L}\boldsymbol{L}^T + \boldsymbol{\Psi}\).
b) Mostre que \(\operatorname{Cov}\left(X_j, F_k\right) = \ell_{jk}\), isto é, que a carga é a covariância entre a variável e o fator.
c) Suponha agora que \(\boldsymbol{\Psi}\) não seja diagonal, mas uma matriz de covariâncias qualquer. O que acontece com a interpretação do modelo? Por que a hipótese de diagonalidade é a que dá conteúdo empírico à análise fatorial?
Exercício 6.2 Um modelo com \(m = 2\) fatores foi ajustado a quatro variáveis padronizadas, produzindo as cargas
\[ \hat{\boldsymbol{L}} = \begin{pmatrix} 0.8 & 0.2 \\ 0.7 & -0.3 \\ 0.3 & 0.8 \\ 0.4 & 0.6 \end{pmatrix} \]
a) Calcule as comunalidades e as variâncias específicas das quatro variáveis.
b) Calcule a correlação entre \(X_1\) e \(X_3\) implicada pelo modelo, e a correlação entre \(X_3\) e \(X_4\).
c) Que proporção da variância total das quatro variáveis é explicada por cada fator?
Exercício 6.3 Seja \(\boldsymbol{T}\) a matriz de rotação no plano,
\[ \boldsymbol{T} = \begin{pmatrix} \cos\theta & -\sin\theta \\ \sin\theta & \phantom{-}\cos\theta \end{pmatrix} \]
a) Verifique que \(\boldsymbol{T}\) é ortogonal e que, para qualquer \(\theta\), as cargas rotacionadas \(\hat{\boldsymbol{L}}^* = \hat{\boldsymbol{L}}\boldsymbol{T}\) produzem a mesma matriz \(\hat{\boldsymbol{L}}^*(\hat{\boldsymbol{L}}^*)^T\).
b) Mostre que as comunalidades são invariantes à rotação.
c) Aplique a rotação com \(\theta = 30°\) às cargas do Exercício 6.2 e verifique numericamente os dois itens anteriores.
d) Se a rotação não altera nem o ajuste nem as comunalidades, em que sentido uma solução rotacionada é melhor que outra?
Exercício 6.4 Três variáveis padronizadas têm matriz de correlações
\[ \boldsymbol{R}= \begin{pmatrix} 1.0 & 0.8 & 0.3 \\ 0.8 & 1.0 & 0.4 \\ 0.3 & 0.4 & 1.0 \end{pmatrix} \]
a) Resolva o sistema de um fator e obtenha as três cargas.
b) Calcule as comunalidades e as variâncias específicas. A solução é admissível?
c) Use a Equação 6.3 para determinar os graus de liberdade do modelo. O que esse número diz sobre a possibilidade de testar o ajuste?
Exercício 6.5 Considere um modelo de um fator com \(p = 3\) variáveis padronizadas, cargas \(\boldsymbol{L} = (0.9,\ 0.6,\ 0.3)^T\) e as variâncias específicas correspondentes.
a) Escreva os coeficientes do escore de Bartlett dado pela Equação 6.7. Qual variável recebe o maior peso, e por quê?
b) Compare com os coeficientes do escore de regressão da Equação 6.6. Em que direção os dois diferem?
c) Explique por que os escores de regressão têm variância menor que 1, enquanto os fatores verdadeiros têm variância 1.
Exercício 6.6 Uma equipe de inteligência de mercado aplicou um questionário a 300 consumidores sobre a percepção de uma marca de relógios inteligentes. Os seis itens, medidos de 1 a 7, foram os seguintes:
- \(X_1\): as medições de batimentos cardíacos são precisas
- \(X_2\): o GPS integrado registra minhas rotas sem falhas
- \(X_3\): o design é moderno e elegante
- \(X_4\): as opções de pulseira são esteticamente atraentes
- \(X_5\): o relógio resiste a quedas e ao uso intenso em treinos
- \(X_6\): a bateria dura o tempo prometido pelo fabricante
A matriz de correlações amostral foi
\[ \boldsymbol{R}= \begin{pmatrix} 1.00 & 0.72 & 0.15 & 0.10 & 0.65 & 0.60 \\ 0.72 & 1.00 & 0.12 & 0.08 & 0.70 & 0.62 \\ 0.15 & 0.12 & 1.00 & 0.78 & 0.10 & 0.14 \\ 0.10 & 0.08 & 0.78 & 1.00 & 0.05 & 0.11 \\ 0.65 & 0.70 & 0.10 & 0.05 & 1.00 & 0.58 \\ 0.60 & 0.62 & 0.14 & 0.11 & 0.58 & 1.00 \end{pmatrix} \]
a) Identifique a estrutura de blocos na matriz. Quantos fatores você espera encontrar, e como os interpretaria?
b) A extração por componentes principais com \(m = 2\) produziu \(\hat{\lambda}_1 = 3.01\) e \(\hat{\lambda}_2 = 1.71\). Que proporção da variância total os dois fatores explicam?
c) Quantos graus de liberdade tem esse modelo? Seria possível testar seu ajuste?
d) O que a rotação varimax faria com essa solução? Você esperaria uma mudança grande nas cargas?
Exercício 6.7 (Composição química de vidros romanos) O conjunto dados/RBGlass1.csv reúne medidas de composição química de fragmentos de vidro romano. Conduza uma análise fatorial completa, justificando cada decisão: a padronização das variáveis, os diagnósticos de adequação, o número de fatores, o método de estimação e o tipo de rotação. Compare a solução obtida com uma ACP dos mesmos dados e discuta em que as duas diferem, tanto nos resultados quanto naquilo que cada uma se propõe a responder.
6.10 Tópicos avançados
6.10.1 Análise fatorial confirmatória
Tudo o que fizemos até aqui é análise fatorial exploratória: deixamos os dados dizerem quantos fatores existem e quais variáveis pesam em cada um, e só depois, olhando as cargas, atribuímos nomes. A rotação é parte dessa postura, já que serve para encontrar a orientação mais legível entre infinitas equivalentes.
A análise fatorial confirmatória inverte a ordem. A estrutura é especificada antes de ver os dados, a partir da teoria, tipicamente fixando em zero as cargas dos itens nos fatores a que eles não pertencem. No exemplo do Big Five, isso significaria declarar que os cinco itens de neuroticismo carregam apenas no fator de neuroticismo, e assim por diante. Com cargas fixadas, a indeterminação rotacional desaparece, não há o que rotacionar, e o modelo passa a ser falsificável de maneira muito mais direta: ou reproduz a matriz de correlações observada, ou não.
O ajuste é avaliado pelo teste da Equação 6.4 e por índices construídos para contornar a sensibilidade daquele teste ao tamanho da amostra. A análise fatorial confirmatória é o caso mais simples dos modelos de equações estruturais, que permitem ainda especificar relações entre os próprios fatores latentes.
6.10.2 Dados ordinais e correlações policóricas
O exemplo deste capítulo tratou respostas em escala de 1 a 5 como se fossem contínuas, e calculou correlações de Pearson entre elas. É o que se faz na prática, mas convém saber o que se está supondo. Uma escala Likert não é contínua nem tem espaçamento garantido entre categorias, e a correlação de Pearson entre variáveis ordinais é sistematicamente atenuada em relação à correlação entre as variáveis contínuas que as originaram, especialmente quando as respostas se concentram nos extremos.
A alternativa é a correlação policórica, que supõe que por trás de cada resposta ordinal existe uma variável contínua normal, cortada em faixas por limiares desconhecidos, e estima a correlação entre essas variáveis latentes por máxima verossimilhança. A análise fatorial é então conduzida sobre a matriz de correlações policóricas. O efeito prático costuma ser um aumento das comunalidades e, com alguma frequência, uma estrutura mais limpa. O custo é computacional, e a estimação exige amostras maiores para ser estável.
Com poucas categorias, digamos duas ou três, a diferença é grande e vale a pena. Com cinco ou mais categorias e respostas razoavelmente distribuídas, como no exemplo do Big Five, a atenuação é modesta e a análise sobre correlações de Pearson tende a levar às mesmas conclusões.
6.10.3 A análise fatorial como modelo probabilístico
A ACP probabilística, mencionada na Seção 4.11.5, supõe que a variância descartada se distribui igualmente por todas as direções não retidas, com \(\boldsymbol{\Sigma}= \boldsymbol{E}_q(\boldsymbol{\Lambda}_q - \sigma^2\boldsymbol{I}_q)\boldsymbol{E}_q^T + \sigma^2\boldsymbol{I}_p\), isto é, um único nível de ruído \(\sigma^2\) comum a todas as variáveis. A análise fatorial é exatamente o que se obtém ao permitir que cada variável tenha o seu próprio nível de ruído, trocando \(\sigma^2\boldsymbol{I}_p\) pela matriz diagonal \(\boldsymbol{\Psi}\).
Essa liberdade extra explica boa parte das diferenças entre as duas técnicas. Como \(\sigma^2\boldsymbol{I}_p\) impõe o mesmo nível de ruído a todas as variáveis, a ACP probabilística, tal como a ACP usual, depende da escala em que cada variável foi medida, e é por isso que precisamos padronizar antes de aplicá-la. Já \(\boldsymbol{\Psi}\) pode absorver diferenças de escala variável a variável, de modo que a solução de máxima verossimilhança da análise fatorial é invariante a mudanças de escala. Analisar \(\boldsymbol{S}\) ou \(\boldsymbol{R}\) leva à mesma solução, a menos do reescalonamento das cargas. A vantagem é da AF por máxima verossimilhança e não se estende à estimação por componentes principais, que herda a dependência de escala da técnica que lhe dá nome.