5 Análise de correspondência
A Análise de Correspondência (AC) é uma família de técnicas exploratórias para a análise de dados categóricos. Ela facilita a visualização das associações existentes entre os níveis de diferentes variáveis categóricas. A Análise de Correspondência Simples (ACS) trabalha com duas variáveis categóricas a partir de uma tabela de contingência. A extensão para três ou mais variáveis é a Análise de Correspondência Múltipla (ACM).
A análise de correspondência costuma ser apresentada como uma “ACP para dados categóricos”, porque também busca uma representação de baixa dimensão que possa ser desenhada e interpretada. A principal saída de uma análise de correspondência é o mapa de correspondência, um gráfico em que níveis com perfis de frequência semelhantes aparecem próximos uns dos outros e níveis com perfis distintos aparecem afastados. É lendo esse mapa que identificamos padrões de associação, como quais níveis de uma variável tendem a aparecer junto com quais níveis de outra.
Definição 5.1 (Tabela de contingência) Sejam \(X\) e \(Y\) duas variáveis categóricas com \(I\) e \(J\) níveis, respectivamente. Uma tabela de contingência \(\boldsymbol{N}\) de dimensão \(I \times J\) é uma matriz em que cada elemento \(n_{ij}\) representa a contagem de observações que pertencem simultaneamente ao \(i\)-ésimo nível de \(X\) e ao \(j\)-ésimo nível de \(Y\).
As somas nas margens da tabela fornecem os totais de cada nível, com \(n_{i.} = \sum_{j=1}^{J} n_{ij}\) para a \(i\)-ésima linha e \(n_{.j} = \sum_{i=1}^{I} n_{ij}\) para a \(j\)-ésima coluna. A soma de todas as contagens resulta no número total de observações da amostra, \(n = \sum_{i=1}^{I} \sum_{j=1}^{J} n_{ij}\).
Definição 5.2 (Matriz de correspondência) A matriz de correspondência, denotada por \(\boldsymbol{P}\), reúne as proporções amostrais conjuntas obtidas pela divisão de cada elemento de \(\boldsymbol{N}\) pelo total geral de observações \(n\):
\[ \boldsymbol{P} = \frac{1}{n} \boldsymbol{N} \]
Cada elemento \(p_{ij} = n_{ij}/n\) representa a frequência relativa conjunta dos níveis \(i\) e \(j\). As proporções marginais das linhas, \(r_i = \sum_{j=1}^J p_{ij}\), e das colunas, \(c_j = \sum_{i=1}^I p_{ij}\), são reunidas nos vetores
\[ \boldsymbol{r} = (r_1, \dots, r_I)^T \qquad\text{e}\qquad \boldsymbol{c} = (c_1, \dots, c_J)^T \]
Exemplo 5.1 (Preferências por serviços de streaming) Considere uma pesquisa sobre a preferência por serviços de streaming. Foram entrevistadas 300 pessoas, classificadas pela faixa etária e pelo serviço escolhido. Os resultados estão na Tabela 5.1.
| Faixa etária | Netflix | Prime Video | Max | Disney+ | Total |
|---|---|---|---|---|---|
| Jovem | 45 | 15 | 10 | 30 | 100 |
| Adulto | 30 | 45 | 15 | 10 | 100 |
| Idoso | 15 | 20 | 55 | 10 | 100 |
| Total | 90 | 80 | 80 | 50 | 300 |
Dividindo cada contagem da Tabela 5.1 pelo total de \(n = 300\) observações, obtemos a matriz de correspondência \(\boldsymbol{P}\):
\[ \boldsymbol{P} = \frac{1}{300}\boldsymbol{N} = \begin{pmatrix} 45/300 & 15/300 & 10/300 & 30/300 \\ 30/300 & 45/300 & 15/300 & 10/300 \\ 15/300 & 20/300 & 55/300 & 10/300 \end{pmatrix} = \begin{pmatrix} 0{,}150 & 0{,}050 & 0{,}033 & 0{,}100 \\ 0{,}100 & 0{,}150 & 0{,}050 & 0{,}033 \\ 0{,}050 & 0{,}067 & 0{,}183 & 0{,}033 \end{pmatrix} \tag{5.1}\]
cujas somas marginais fornecem os vetores \(\boldsymbol{r}\) e \(\boldsymbol{c}\):
\[ \boldsymbol{r} = \begin{pmatrix} 1/3 \\ 1/3 \\ 1/3 \end{pmatrix} \qquad\text{e}\qquad \boldsymbol{c} = \begin{pmatrix} 90/300 \\ 80/300 \\ 80/300 \\ 50/300 \end{pmatrix} \approx \begin{pmatrix} 0{,}300 \\ 0{,}267 \\ 0{,}267 \\ 0{,}167 \end{pmatrix} \]
As três faixas etárias têm a mesma proporção de pessoas na amostra (\(r_i = 1/3\) para cada). Na amostra completa, 30% preferem Netflix (\(c_1 = 0{,}300\)), 26,7% preferem Prime Video (\(c_2 \approx 0{,}267\)), 26,7% preferem Max (\(c_3 \approx 0{,}267\)) e 16,7% preferem Disney+ (\(c_4 \approx 0{,}167\)). Essas proporções descrevem a popularidade geral de cada serviço, mas as preferências mudam bastante de uma faixa etária para outra. Entre os jovens, 45% escolhem Netflix e 30% Disney+. Entre os adultos, 45% ficam com o Prime Video, e entre os idosos 55% escolhem a Max.
Nosso objetivo será transformar essas comparações isoladas em uma descrição conjunta das associações presentes na tabela.
5.1 O modelo de independência
Definição 5.3 (Independência em tabelas de contingência) Duas variáveis categóricas são independentes se as probabilidades conjuntas forem iguais ao produto das probabilidades marginais, \(p_{ij} = r_i c_j\) para todos os pares \((i, j)\). Em notação matricial,
\[ \boldsymbol{P} = \boldsymbol{r}\boldsymbol{c}^T \]
Quando há dependência, o afastamento em relação a essa situação fica registrado na matriz de desvios
\[ \boldsymbol{\Delta} = \boldsymbol{P} - \boldsymbol{r}\boldsymbol{c}^T \]
Cada elemento \(\delta_{ij} = p_{ij} - r_i c_j\) compara a proporção observada com sua proporção esperada sob independência. Valores positivos indicam que a combinação aparece mais do que o esperado, e valores negativos, que aparece menos. Sob independência, \(\boldsymbol{\Delta} = \boldsymbol{0}\).
Uma maneira ingênua de resumir o desvio total seria a soma dos quadrados de seus elementos, \(\sum_{i=1}^{I}\sum_{j=1}^{J}(p_{ij}-r_i c_j)^2\). Essa soma, contudo, ignora a frequência esperada de cada célula, e um mesmo desvio pesa mais numa célula rara do que numa célula frequente. Tome por exemplo a célula Jovem-Disney+ da matriz na Equação 5.1. Sob independência, esperaríamos a proporção \(r_1 c_4 = \tfrac{1}{3} \times 0{,}167 \approx 0{,}056\), e por isso um desvio de \(0{,}05\) nessa célula já é forte, representando cerca de \(90\%\) de respostas a mais do que o esperado.
Por outro lado, a célula Jovem-Netflix tem proporção esperada \(r_1 c_1 = \tfrac{1}{3} \times 0{,}300 = 0{,}100\). Nesse caso, o mesmo desvio de \(0{,}05\) representaria \(50\%\) de respostas a mais do que o esperado nessa combinação. A solução é ponderar o quadrado de cada desvio pelo inverso de sua proporção esperada sob independência. Em notação matricial, isso pede as matrizes diagonais das marginais
\[ \boldsymbol{D}_r = \operatorname{diag}\left(\boldsymbol{r}\right) \qquad\text{e}\qquad \boldsymbol{D}_c = \operatorname{diag}\left(\boldsymbol{c}\right) \]
Assumimos que \(r_i > 0\) e \(c_j > 0\) para todos os níveis. Um nível sem observações na amostra deve ser removido da tabela antes do ajuste.
Definição 5.4 (Matriz de desvios padronizados) A matriz de desvios padronizados é definida por:
\[ \boldsymbol{S} = \boldsymbol{D}_r^{-1/2} \left(\boldsymbol{P} - \boldsymbol{r}\boldsymbol{c}^T\right) \boldsymbol{D}_c^{-1/2} = \boldsymbol{D}_r^{-1/2}\boldsymbol{\Delta}\boldsymbol{D}_c^{-1/2} \]
Elemento a elemento:
\[ s_{ij} = \frac{p_{ij} - r_i c_j}{\sqrt{r_i c_j}} \]
A multiplicação à esquerda por \(\boldsymbol{D}_r^{-1/2}\) divide cada linha por \(\sqrt{r_i}\), enquanto a multiplicação à direita por \(\boldsymbol{D}_c^{-1/2}\) divide cada coluna por \(\sqrt{c_j}\). O sinal do desvio é mantido, mas sua magnitude passa a ser avaliada em relação à variabilidade esperada da célula.
Definição 5.5 (Inércia total) A inércia total da tabela de contingência é a soma dos quadrados dos desvios padronizados, coincidindo com o quadrado da norma de Frobenius (Definição 2.6) da matriz \(\boldsymbol{S}\):
\[ \phi^2 = \sum_{i=1}^{I}\sum_{j=1}^{J}s_{ij}^2 = \operatorname{tr}\left(\boldsymbol{S}^T\boldsymbol{S}\right) = \|\boldsymbol{S}\|_F^2 \]
Como soma de quadrados, \(\phi^2 \geq 0\), e \(\phi^2 = 0\) se, e somente se, \(p_{ij} = r_i c_j\) para todas as células. A inércia total serve como uma medida padronizada de quão distante a distribuição conjunta está da hipótese de independência.
DicaRelação com o teste qui-quadrado de independência
A hipótese de independência em tabelas de contingência é classicamente avaliada pela estatística qui-quadrado de Pearson (\(\chi^2\)). A inércia total nada mais é do que essa estatística dividida pelo tamanho amostral:
\[ \phi^2 = \frac{\chi^2}{n} \qquad\text{ou}\qquad \chi^2 = n\phi^2 \]
A inércia total funciona, então, como uma medida de associação que não depende do tamanho amostral. O teste responde com um sim ou um não global sobre a existência de dependência. A análise de correspondência vai além e decompõe essa mesma associação para mostrar, no mapa, quais níveis se atraem e quais se repelem.
5.2 Perfis e distâncias
Definição 5.6 (Perfis de linha e de coluna) Dada a matriz de correspondência \(\boldsymbol{P}\) com vetores marginais \(\boldsymbol{r}\) e \(\boldsymbol{c}\), os perfis-linha são as linhas da matriz \(\boldsymbol{D}_r^{-1}\boldsymbol{P}\) e os perfis-coluna são as colunas da matriz \(\boldsymbol{P}\boldsymbol{D}_c^{-1}\).
O perfil do nível-linha \(i\) tem entradas \(p_{ij}/r_i\), para \(j = 1, \dots, J\), e contém a distribuição condicional das colunas para esse nível. De forma análoga, o perfil do nível-coluna \(j\) tem entradas \(p_{ij}/c_j\), para \(i = 1, \dots, I\), com a distribuição condicional das linhas.
O perfil médio das linhas é a média dos perfis-linha ponderada pelas marginais \(r_i\). Como \(\sum_{i} r_i \, (p_{ij}/r_i) = \sum_i p_{ij} = c_j\), ele coincide com a marginal das colunas \(\boldsymbol{c}^T\). Da mesma forma, o perfil médio das colunas é a marginal das linhas \(\boldsymbol{r}\).
Exemplo 5.2 No Exemplo 5.1, a matriz de perfis-linha \(\boldsymbol{D}_r^{-1}\boldsymbol{P}\) é obtida dividindo cada linha pelo seu total marginal (100). Como as três faixas etárias têm a mesma marginal, o perfil médio é a média simples das três linhas. Na Netflix, por exemplo, \((0{,}45 + 0{,}30 + 0{,}15)/3 = 0{,}30 = c_1\):
\[ \boldsymbol{D}_r^{-1}\boldsymbol{P} = \begin{pmatrix} 0{,}45 & 0{,}15 & 0{,}10 & 0{,}30 \\ 0{,}30 & 0{,}45 & 0{,}15 & 0{,}10 \\ 0{,}15 & 0{,}20 & 0{,}55 & 0{,}10 \end{pmatrix} \qquad\text{e}\qquad \boldsymbol{c}^T \approx \begin{pmatrix} 0{,}300 & 0{,}267 & 0{,}267 & 0{,}167 \end{pmatrix} \]
A primeira linha de \(\boldsymbol{D}_r^{-1}\boldsymbol{P}\) descreve o perfil dos jovens, dos quais 45% preferem Netflix, 15% Prime Video, 10% Max e 30% Disney+. De forma análoga, dividindo cada coluna da tabela pelo seu total marginal, obtemos a matriz de perfis-coluna \(\boldsymbol{P}\boldsymbol{D}_c^{-1}\), cujo perfil médio é \(\boldsymbol{r}\):
\[ \boldsymbol{P}\boldsymbol{D}_c^{-1} \approx \begin{pmatrix} 0{,}500 & 0{,}188 & 0{,}125 & 0{,}600 \\ 0{,}333 & 0{,}562 & 0{,}188 & 0{,}200 \\ 0{,}167 & 0{,}250 & 0{,}688 & 0{,}200 \end{pmatrix} \qquad\text{e}\qquad \boldsymbol{r} \approx \begin{pmatrix} 0{,}33 \\ 0{,}33 \\ 0{,}33 \end{pmatrix} \]
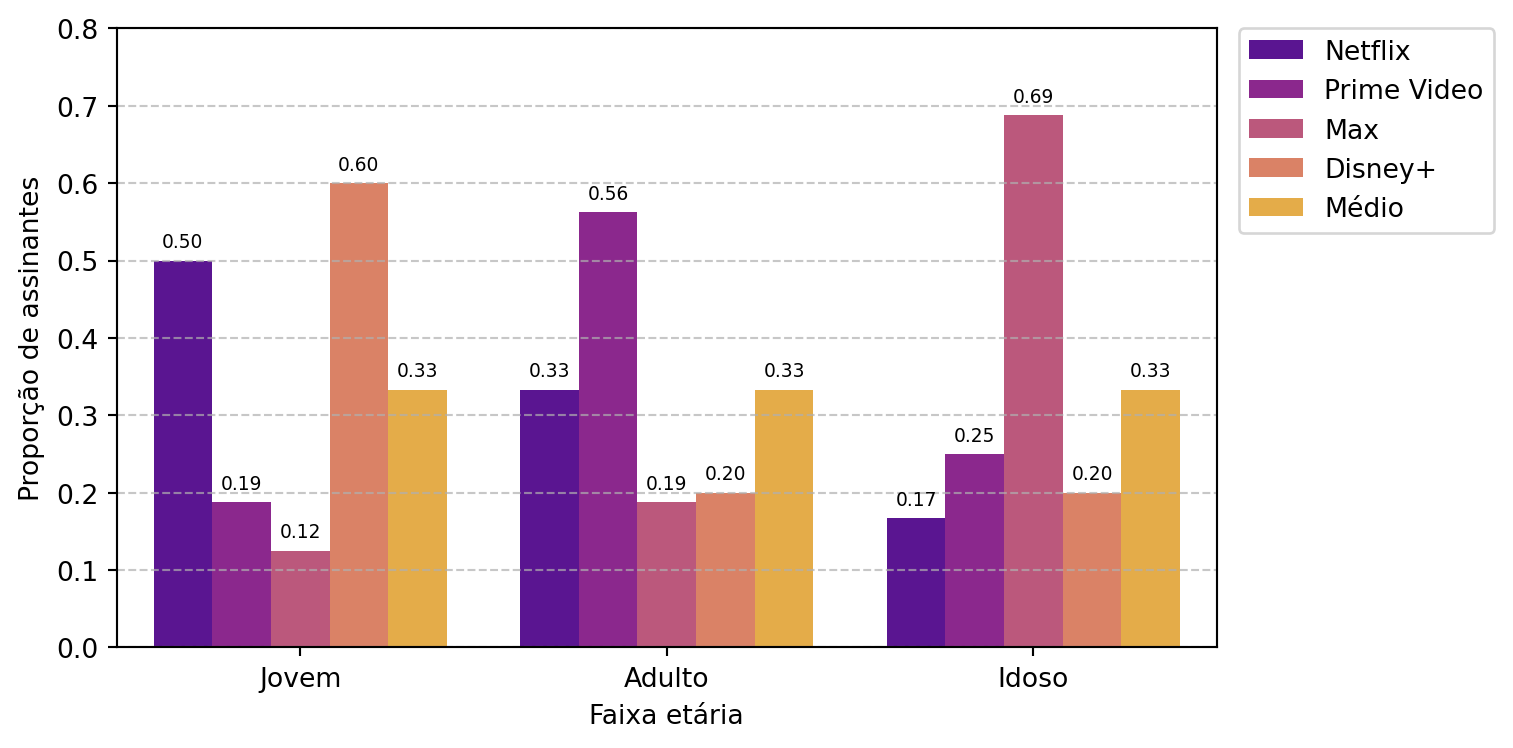
Entre os assinantes da Netflix, por exemplo, 50% são jovens, 33,3% adultos e 16,7% idosos, como mostra a primeira coluna de \(\boldsymbol{P}\boldsymbol{D}_c^{-1}\).
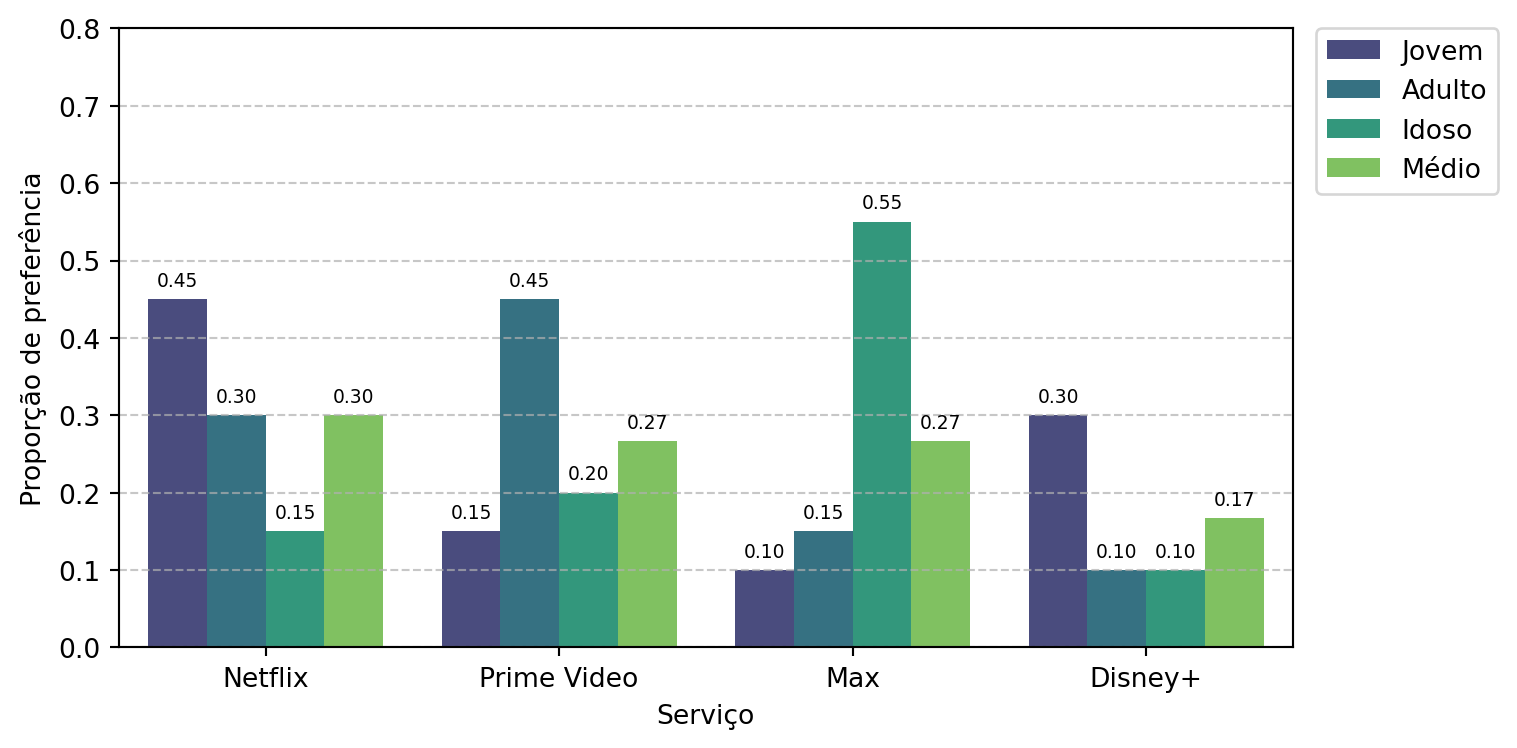
Fica mais fácil comparar os perfis colocando cada um ao lado do perfil médio. Na Figura 5.1, se a faixa etária não influenciasse a escolha, as barras de um mesmo serviço teriam todas a altura da barra do perfil médio. Não é o que acontece. Na Max, a barra dos idosos chega a \(0{,}55\), mais que o dobro da média de \(0{,}27\), e na Netflix os jovens ficam em \(0{,}45\) contra \(0{,}30\). A Figura 5.2 conta a mesma história do outro lado da tabela. Entre os assinantes da Max, \(69\%\) são idosos, enquanto na amostra toda cada faixa etária responde por um terço.
Proposição 5.1 (Perfis sob a hipótese de independência) Duas variáveis categóricas são independentes se, e somente se, todos os perfis-linha forem idênticos ao perfil médio das linhas ou, equivalentemente, todos os perfis-coluna forem idênticos ao perfil médio das colunas:
\[ \boldsymbol{P} = \boldsymbol{r}\boldsymbol{c}^T \iff \boldsymbol{D}_r^{-1}\boldsymbol{P} = \boldsymbol{1}\boldsymbol{c}^T \iff \boldsymbol{P}\boldsymbol{D}_c^{-1} = \boldsymbol{r}\boldsymbol{1}^T \]
Prova. Sob independência, \(\boldsymbol{P} = \boldsymbol{r}\boldsymbol{c}^T\). Como \(\boldsymbol{D}_r^{-1}\boldsymbol{r} = \boldsymbol{1}\), temos
\[ \boldsymbol{D}_r^{-1}\boldsymbol{P} = \left(\boldsymbol{D}_r^{-1}\boldsymbol{r}\right)\boldsymbol{c}^T = \boldsymbol{1}\boldsymbol{c}^T \]
Reciprocamente, se \(\boldsymbol{D}_r^{-1}\boldsymbol{P} = \boldsymbol{1}\boldsymbol{c}^T\), multiplicando à esquerda por \(\boldsymbol{D}_r\) obtemos \(\boldsymbol{P} = \boldsymbol{D}_r\boldsymbol{1}\boldsymbol{c}^T = \boldsymbol{r}\boldsymbol{c}^T\). O resultado para perfis-coluna é análogo.
Para comparar dois perfis, a distância euclidiana simples não é adequada, pois trata níveis frequentes e raros da mesma forma. A métrica natural é a distância qui-quadrado, que, pelo mesmo motivo que nos levou a padronizar os desvios, pondera a diferença em cada coordenada pelo inverso da marginal.
Definição 5.7 (Distância qui-quadrado) A distância qui-quadrado (\(\chi^2\)) entre dois níveis-linha \(i\) e \(i'\) e entre dois níveis-coluna \(j\) e \(j'\) é definida por
\[ d_{\chi^2}^2(i, i') = \sum_{j=1}^{J}\frac{1}{c_j}\left(\frac{p_{ij}}{r_i} - \frac{p_{i'j}}{r_{i'}}\right)^2 \qquad\text{e}\qquad d_{\chi^2}^2(j, j') = \sum_{i=1}^{I}\frac{1}{r_i}\left(\frac{p_{ij}}{c_j} - \frac{p_{ij'}}{c_{j'}}\right)^2 \]
Trocando o segundo perfil pelo perfil médio, obtemos a distância qui-quadrado de cada perfil ao respectivo perfil médio:
\[ d_{\chi^2}^2(i, \boldsymbol{c}) = \sum_{j=1}^{J}\frac{1}{c_j}\left(\frac{p_{ij}}{r_i} - c_j\right)^2 \qquad\text{e}\qquad d_{\chi^2}^2(j, \boldsymbol{r}) = \sum_{i=1}^{I}\frac{1}{r_i}\left(\frac{p_{ij}}{c_j} - r_i\right)^2 \]
Proposição 5.2 (Inércia total como dispersão dos perfis) A inércia total \(\phi^2\) é exatamente a média ponderada das distâncias qui-quadrado de todos os perfis em relação ao perfil médio:
\[ \phi^2 = \sum_{i=1}^{I} r_i \, d_{\chi^2}^2(i, \boldsymbol{c}) = \sum_{j=1}^{J} c_j \, d_{\chi^2}^2(j, \boldsymbol{r}) \]
Prova. Colocando \(r_i\) em evidência no numerador da Definição 5.4, cada desvio padronizado passa a ser escrito em termos do perfil da linha \(i\):
\[ s_{ij} = \frac{r_i\left(\frac{p_{ij}}{r_i} - c_j\right)}{\sqrt{r_i c_j}} = \sqrt{\frac{r_i}{c_j}}\left(\frac{p_{ij}}{r_i} - c_j\right) \]
Somando os quadrados primeiro em \(j\) e depois em \(i\):
\[ \phi^2 = \sum_{i=1}^{I}\sum_{j=1}^{J} s_{ij}^2 = \sum_{i=1}^{I} r_i \sum_{j=1}^{J}\frac{1}{c_j}\left(\frac{p_{ij}}{r_i} - c_j\right)^2 = \sum_{i=1}^{I} r_i \, d_{\chi^2}^2(i, \boldsymbol{c}) \]
Para os perfis-coluna, colocamos \(c_j\) em evidência, o que dá \(s_{ij} = \sqrt{c_j/r_i}\,(p_{ij}/c_j - r_i)\), e somamos primeiro em \(i\).
A inércia total tem, portanto, duas leituras equivalentes. Ela mede o afastamento da tabela em relação à independência e, ao mesmo tempo, a dispersão dos perfis em torno do perfil médio. Os perfis de uma tabela \(I \times J\) vivem em um espaço de dimensão alta demais para desenhar, e o próximo passo é encontrar as poucas direções que concentram a maior parte dessa dispersão.
5.3 Análise de correspondência simples
A Análise de Correspondência Simples procura o subespaço de baixa dimensão que fica mais perto da nuvem de perfis, no mesmo espírito da ACP. Como a dispersão dos perfis é a inércia total, e a inércia total é \(\|\boldsymbol{S}\|_F^2\), isso equivale a buscar uma aproximação de baixo posto para a matriz de desvios padronizados \(\boldsymbol{S}\). Pelo Teorema de Eckart-Young-Mirsky (Teorema 2.2), a melhor aproximação de posto \(q\) segundo a norma de Frobenius é obtida truncando a decomposição em valores singulares (SVD), e minimizar o erro quadrático \(\|\boldsymbol{S} - \widehat{\boldsymbol{S}}_q\|_F^2\) equivale a maximizar a inércia explicada pelas \(q\) primeiras dimensões. Sob independência, todos os perfis coincidem com o perfil médio e \(\boldsymbol{S} = \boldsymbol{0}\), então não há nada a representar.
Como as linhas e colunas de \(\boldsymbol{P} - \boldsymbol{r}\boldsymbol{c}^T\) somam zero, o posto \(K = \operatorname{posto}\left(\boldsymbol{S}\right)\) não passa de \(\min(I-1, J-1)\). A decomposição reduzida de \(\boldsymbol{S}\) em valores singulares é
\[ \boldsymbol{S} = \boldsymbol{U}\boldsymbol{\Lambda}\boldsymbol{V}^T = \sum_{k=1}^{K}\lambda_k\boldsymbol{u}_k\boldsymbol{v}_k^T \]
em que \(\boldsymbol{U} = (\boldsymbol{u}_1 \cdots \boldsymbol{u}_K)\) e \(\boldsymbol{V} = (\boldsymbol{v}_1 \cdots \boldsymbol{v}_K)\) contêm os vetores singulares ortonormais à esquerda e à direita, e \(\boldsymbol{\Lambda} = \operatorname{diag}\left(\lambda_1, \dots, \lambda_K\right)\) reúne os valores singulares em ordem decrescente, \(\lambda_1 \geq \lambda_2 \geq \dots \geq \lambda_K > 0\).
Escrevendo a decomposição elemento a elemento, \(s_{ij} = \sum_{k=1}^{K} \lambda_k u_{ik} v_{jk}\), vemos que cada desvio é reconstruído somando, ao longo das \(K\) dimensões, o produto das entradas correspondentes dos vetores singulares. O valor singular \(\lambda_k\) pesa o quanto cada dimensão contribui nessa soma.
Uma boa maneira de ler essa soma é tratar as linhas de \(\boldsymbol{U}\) e de \(\boldsymbol{V}\) como representações vetoriais dos níveis. A linha \(i\) de \(\boldsymbol{U}\), \((u_{i1}, \dots, u_{iK})\), reúne as coordenadas do \(i\)-ésimo nível-linha nas \(K\) dimensões, e a linha \(j\) de \(\boldsymbol{V}\), \((v_{j1}, \dots, v_{jK})\), faz o mesmo para o \(j\)-ésimo nível-coluna. Os sinais dessas coordenadas dizem para que lado cada dimensão empurra a célula \((i, j)\). Sinais iguais dão contribuição positiva e inflam a frequência em relação à hipótese de independência, enquanto sinais opostos dão contribuição negativa e a deflacionam. A seção seguinte mostra como transformar essas coordenadas em um mapa bidimensional.
Proposição 5.3 (Decomposição da inércia total) Se \(\lambda_1, \dots, \lambda_K\) são os valores singulares não nulos de \(\boldsymbol{S}\), então a inércia total decompõe-se como:
\[ \phi^2 = \sum_{k=1}^{K}\lambda_k^2 \]
Cada termo \(\lambda_k^2\) é chamado de inércia principal associada à \(k\)-ésima dimensão.
Prova. Usando a propriedade cíclica do traço e \(\boldsymbol{U}^T\boldsymbol{U} = \boldsymbol{V}^T\boldsymbol{V} = \boldsymbol{I}\),
\[ \begin{aligned} \phi^2 &= \operatorname{tr}\left(\boldsymbol{S}^T\boldsymbol{S}\right) \\ &= \operatorname{tr}\left(\boldsymbol{V}\boldsymbol{\Lambda}\boldsymbol{U}^T\boldsymbol{U}\boldsymbol{\Lambda}\boldsymbol{V}^T\right) \\ &= \operatorname{tr}\left(\boldsymbol{V}\boldsymbol{\Lambda}^2\boldsymbol{V}^T\right) \\ &= \operatorname{tr}\left(\boldsymbol{\Lambda}^2\boldsymbol{V}^T\boldsymbol{V}\right) \\ &= \operatorname{tr}\left(\boldsymbol{\Lambda}^2\right) = \sum_{k=1}^{K}\lambda_k^2 \end{aligned} \]
A proporção de inércia explicada pela \(k\)-ésima dimensão é \(\lambda_k^2/\phi^2\), e a proporção acumulada pelas \(q\) primeiras dimensões é \(\sum_{k=1}^q \lambda_k^2 / \phi^2\).
Exemplo 5.3 Retomando a matriz de correspondência \(\boldsymbol{P}\) e os vetores marginais \(\boldsymbol{r}\) e \(\boldsymbol{c}\) calculados no Exemplo 5.1, a matriz de desvios padronizados \(\boldsymbol{S} = \boldsymbol{D}_r^{-1/2} (\boldsymbol{P}-\boldsymbol{r}\boldsymbol{c}^T) \boldsymbol{D}_c^{-1/2}\) e sua decomposição em valores singulares são calculadas no código a seguir:
Código
import numpy as np
import pandas as pd

N = np.array([
    [45, 15, 10, 30],
    [30, 45, 15, 10],
    [15, 20, 55, 10],
], dtype=float)

P = N / N.sum()
r = P.sum(axis=1)
c = P.sum(axis=0)
D_r_inv_sqrt = np.diag(1 / np.sqrt(r))
D_c_inv_sqrt = np.diag(1 / np.sqrt(c))
S = D_r_inv_sqrt @ (P - np.outer(r, c)) @ D_c_inv_sqrt

U, valores_singulares, Vt = np.linalg.svd(S, full_matrices=False)

tol = np.finfo(float).eps * max(S.shape) * valores_singulares[0]
valores_singulares_nao_nulos = valores_singulares[valores_singulares > tol]

inercia_principal = valores_singulares_nao_nulos**2
inercia_total = np.sum(inercia_principal)
inercia_explicada = inercia_principal / inercia_total

pd.DataFrame({
    "Dimensão": np.arange(1, len(valores_singulares_nao_nulos) + 1),
    "Valor singular": valores_singulares_nao_nulos.round(4),
    "Inércia principal": inercia_principal.round(4),
    "Inércia explicada (%)": (100 * inercia_explicada).round(2),
}).set_index("Dimensão").rename_axis(None)| Valor singular | Inércia principal | Inércia explicada (%) | |
|---|---|---|---|
| 1 | 0.4720 | 0.2228 | 69.63 |
| 2 | 0.3117 | 0.0972 | 30.37 |
Como mostra a Tabela 5.2, a matriz possui posto \(K = \min(3-1, 4-1) = 2\), com \(\lambda_1 \approx 0{,}4720\) e \(\lambda_2 \approx 0{,}3117\). A inércia total é:
\[ \phi^2 = \lambda_1^2 + \lambda_2^2 \approx 0{,}2228 + 0{,}0972 = 0{,}3200 \]
A primeira dimensão explica 69,63% da inércia total e a segunda dimensão explica os 30,37% restantes.
5.4 Coordenadas principais
Para visualizar as relações descobertas pela SVD, usamos as coordenadas principais. Essas coordenadas têm a propriedade de preservar as distâncias qui-quadrado entre os perfis, como mostramos a seguir.
Definição 5.8 (Coordenadas principais) As coordenadas principais das linhas e das colunas, nas \(K\) dimensões da análise, são dadas por:
\[ \boldsymbol{F} = \boldsymbol{D}_r^{-1/2}\boldsymbol{U}\boldsymbol{\Lambda} \qquad\text{e}\qquad \boldsymbol{G} = \boldsymbol{D}_c^{-1/2}\boldsymbol{V}\boldsymbol{\Lambda} \]
A linha \(i\) de \(\boldsymbol{F}\), denotada por \(\boldsymbol{f}_i^T = (f_{i1}, \dots, f_{iK})\), reúne as coordenadas do \(i\)-ésimo nível-linha. A linha \(j\) de \(\boldsymbol{G}\), denotada por \(\boldsymbol{g}_j^T = (g_{j1}, \dots, g_{jK})\), reúne as coordenadas do \(j\)-ésimo nível-coluna.
Proposição 5.4 (Preservação das distâncias qui-quadrado) A distância euclidiana ao quadrado entre dois níveis no espaço das coordenadas principais reproduz exatamente a distância qui-quadrado entre seus perfis:
\[ \|\boldsymbol{f}_i - \boldsymbol{f}_{i'}\|^2 = \sum_{k=1}^{K} (f_{ik} - f_{i'k})^2 = d_{\chi^2}^2(i, i') \qquad\text{e}\qquad \|\boldsymbol{g}_j - \boldsymbol{g}_{j'}\|^2 = \sum_{k=1}^{K} (g_{jk} - g_{j'k})^2 = d_{\chi^2}^2(j, j') \]
Em particular, a distância euclidiana de um nível até a origem mede o desvio do seu perfil em relação ao perfil médio: \(\|\boldsymbol{f}_i\|^2 = d_{\chi^2}^2(i, \boldsymbol{c})\) e \(\|\boldsymbol{g}_j\|^2 = d_{\chi^2}^2(j, \boldsymbol{r})\).
Prova. Pela SVD temos \(\boldsymbol{S}\boldsymbol{V} = \boldsymbol{U}\boldsymbol{\Lambda}\), e portanto \(\boldsymbol{F} = \boldsymbol{D}_r^{-1/2}\boldsymbol{S}\boldsymbol{V}\). Chame de \(\tilde{\boldsymbol{x}}_i^T\) a linha \(i\) de \(\boldsymbol{D}_r^{-1/2}\boldsymbol{S}\). Usando \(s_{ij} = \sqrt{r_i/c_j}\,(p_{ij}/r_i - c_j)\), obtido na prova da Proposição 5.2, suas entradas são
\[ \tilde{x}_{ij} = \frac{s_{ij}}{\sqrt{r_i}} = \frac{1}{\sqrt{c_j}}\left(\frac{p_{ij}}{r_i} - c_j\right) \]
Ou seja, \(\tilde{\boldsymbol{x}}_i\) é o perfil da linha \(i\) centrado no perfil médio, com cada coordenada dividida por \(\sqrt{c_j}\). Essa divisão embute os pesos \(1/c_j\) da distância qui-quadrado na distância euclidiana comum:
\[ \|\tilde{\boldsymbol{x}}_i - \tilde{\boldsymbol{x}}_{i'}\|^2 = \sum_{j=1}^{J}\frac{1}{c_j}\left(\frac{p_{ij}}{r_i} - \frac{p_{i'j}}{r_{i'}}\right)^2 = d_{\chi^2}^2(i, i') \]
Resta ver que a multiplicação por \(\boldsymbol{V}\) não altera essas distâncias. Como \(\boldsymbol{V}^T\boldsymbol{V} = \boldsymbol{I}\), vale \(\boldsymbol{S}\boldsymbol{V}\boldsymbol{V}^T = \boldsymbol{U}\boldsymbol{\Lambda}\boldsymbol{V}^T\boldsymbol{V}\boldsymbol{V}^T = \boldsymbol{S}\), e portanto \(\boldsymbol{V}\boldsymbol{V}^T\tilde{\boldsymbol{x}}_i = \tilde{\boldsymbol{x}}_i\) para toda linha \(i\). Com \(\boldsymbol{f}_i = \boldsymbol{V}^T\tilde{\boldsymbol{x}}_i\), obtemos
\[ \|\boldsymbol{f}_i - \boldsymbol{f}_{i'}\|^2 = (\tilde{\boldsymbol{x}}_i - \tilde{\boldsymbol{x}}_{i'})^T\boldsymbol{V}\boldsymbol{V}^T(\tilde{\boldsymbol{x}}_i - \tilde{\boldsymbol{x}}_{i'}) = \|\tilde{\boldsymbol{x}}_i - \tilde{\boldsymbol{x}}_{i'}\|^2 = d_{\chi^2}^2(i, i') \]
Trocando \(\tilde{\boldsymbol{x}}_{i'}\) pelo vetor nulo, a mesma conta dá \(\|\boldsymbol{f}_i\|^2 = \|\tilde{\boldsymbol{x}}_i\|^2 = d_{\chi^2}^2(i, \boldsymbol{c})\). Para os níveis-coluna, basta repetir o raciocínio com \(\boldsymbol{G} = \boldsymbol{D}_c^{-1/2}\boldsymbol{S}^T\boldsymbol{U}\).
As coordenadas principais são, então, os perfis centrados e reescalados escritos na base dos vetores singulares, de modo parecido com os escores da ACP. Essa construção converte a métrica qui-quadrado dos perfis na distância euclidiana comum. É isso que autoriza a leitura visual do mapa, já que a régua que usamos no papel passa a ser a régua correta do problema.
Exemplo 5.4 (Coordenadas principais de streaming) Aplicando a Definição 5.8 aos vetores e valores singulares obtidos no Exemplo 5.3, calculamos as matrizes de coordenadas principais \(\boldsymbol{F} = \boldsymbol{D}_r^{-1/2}\boldsymbol{U}\boldsymbol{\Lambda}\) e \(\boldsymbol{G} = \boldsymbol{D}_c^{-1/2}\boldsymbol{V}\boldsymbol{\Lambda}\), apresentadas na Tabela 5.3.
Código
rotulos_linhas = ["Jovem", "Adulto", "Idoso"]
rotulos_colunas = ["Netflix", "Prime Video", "Max", "Disney+"]

F = D_r_inv_sqrt @ U[:, :2] @ np.diag(valores_singulares[:2])
G = D_c_inv_sqrt @ Vt.T[:, :2] @ np.diag(valores_singulares[:2])

coordenadas = pd.DataFrame({
    "Nível": rotulos_linhas + rotulos_colunas,
    "Variável": ["Faixa etária"] * len(rotulos_linhas) + ["Serviço"] * len(rotulos_colunas),
    "Dimensão 1": np.concatenate([F[:, 0], G[:, 0]]),
    "Dimensão 2": np.concatenate([F[:, 1], G[:, 1]]),
})

coordenadas.round(3).set_index("Nível").rename_axis(None)| Variável | Dimensão 1 | Dimensão 2 | |
|---|---|---|---|
| Jovem | Faixa etária | 0.503 | -0.290 |
| Adulto | Faixa etária | 0.129 | 0.433 |
| Idoso | Faixa etária | -0.632 | -0.143 |
| Netflix | Serviço | 0.401 | -0.079 |
| Prime Video | Serviço | 0.019 | 0.492 |
| Max | Serviço | -0.736 | -0.170 |
| Disney+ | Serviço | 0.426 | -0.372 |
5.5 Mapa de correspondência
Para construir uma representação gráfica no plano, retemos as duas primeiras dimensões principais, tomando os pontos \((f_{i1}, f_{i2})\) para as linhas e \((g_{j1}, g_{j2})\) para as colunas. O gráfico conjunto resultante é o mapa de correspondência (ou mapa simétrico). Como os valores singulares estão em ordem decrescente, o plano formado pelas duas primeiras direções captura a maior fração possível da inércia total, \((\lambda_1^2 + \lambda_2^2)/\phi^2\).
Embora as linhas e colunas pertençam a conjuntos distintos de níveis, suas coordenadas no mapa estão conectadas pelas fórmulas de transição:
\[ f_{ik} = \frac{1}{\lambda_k}\sum_{j=1}^{J}\frac{p_{ij}}{r_i}\,g_{jk} \qquad\text{e}\qquad g_{jk} = \frac{1}{\lambda_k}\sum_{i=1}^{I}\frac{p_{ij}}{c_j}\,f_{ik} \]
Ou seja, a posição de cada nível-linha é, a menos da constante \(1/\lambda_k\), uma média ponderada das posições das colunas, com pesos dados pelas frequências do seu perfil (\(p_{ij}/r_i\)). De forma recíproca, cada coluna é a média ponderada das posições das linhas.
CuidadoDistâncias entre linhas e colunas
No mapa simétrico, as distâncias euclidianas entre pontos da mesma nuvem (linha com linha, ou coluna com coluna) reproduzem distâncias qui-quadrado. Já a distância entre um ponto-linha e um ponto-coluna não tem interpretação clara, pois as duas nuvens vivem em espaços com métricas diferentes. O que avaliamos nesse caso é a direção em relação à origem. Pontos no mesmo quadrante e ao longo de direções próximas indicam associação positiva, com a combinação aparecendo mais do que o esperado, enquanto pontos em direções opostas indicam que ela aparece menos. Pontos próximos à origem têm perfil semelhante à média geral.
Exemplo 5.5 (Mapa de streaming) A Figura 5.3 exibe o mapa simétrico bidimensional gerado pelas coordenadas calculadas no Exemplo 5.4. Como há apenas duas dimensões não triviais (\(K = \min(3-1, 4-1) = 2\)), o mapa representa \(100\%\) da inércia total da tabela.
Código
import matplotlib.pyplot as plt

fig, ax = plt.subplots()
ax.scatter(F[:, 0], F[:, 1], marker="o", s=60, label="Faixa etária")
ax.scatter(G[:, 0], G[:, 1], marker="^", s=70, label="Serviço")

for rotulo, (x, y) in zip(rotulos_linhas, F):
    ax.annotate(rotulo, (x, y), xytext=(6, 6), textcoords="offset points")

for rotulo, (x, y) in zip(rotulos_colunas, G):
    ax.annotate(rotulo, (x, y), xytext=(6, -12), textcoords="offset points")

ax.axhline(0, color="0.75", linewidth=0.8)
ax.axvline(0, color="0.75", linewidth=0.8)
ax.set_xlabel(f"Dimensão 1 ({inercia_explicada[0]:.2%})")
ax.set_ylabel(f"Dimensão 2 ({inercia_explicada[1]:.2%})")
ax.set_xlim(-0.8, 0.65)
ax.set_ylim(-0.5, 0.6)
ax.grid(alpha=0.2)
ax.legend()
plt.tight_layout()
plt.show()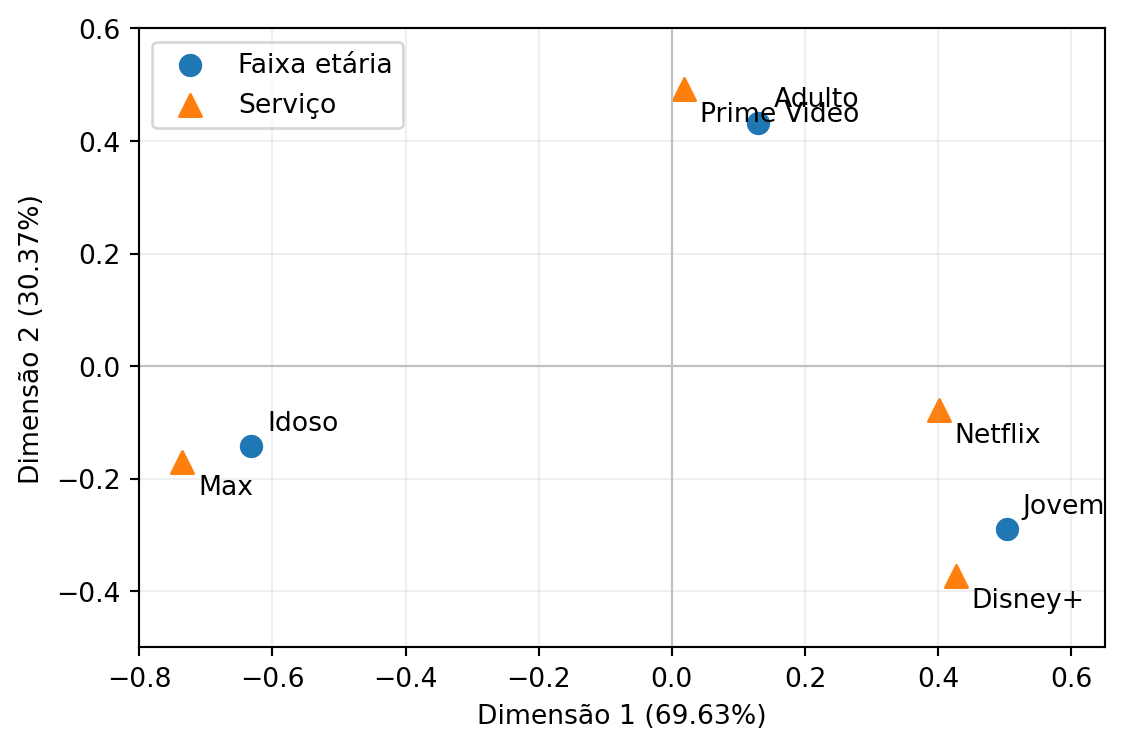
Na Figura 5.3, Netflix e Disney+ aparecem próximos, sinal de que têm perfis semelhantes, enquanto as três faixas etárias ficam bem afastadas umas das outras. O ponto Jovem cai no mesmo quadrante de Netflix (\(45\%\)) e Disney+ (\(30\%\)), que são justamente suas escolhas predominantes, enquanto os idosos concentram \(55\%\) das escolhas na Max e aparecem no polo oposto da primeira dimensão. O Prime Video fica praticamente sobre o eixo vertical, ou seja, a primeira dimensão quase não o distingue da média. É a segunda dimensão que o separa, levando-o para o alto do mapa ao lado dos adultos, \(45\%\) dos quais escolhem esse serviço.
Quando o espaço completo tem dimensão \(K > 2\), projetar os pontos no plano gera perdas. O cosseno ao quadrado mede a fração da distância ao quadrado do perfil até a origem que o plano das duas primeiras dimensões consegue capturar,
\[ \cos^2_{i1} + \cos^2_{i2} = \frac{f_{i1}^2 + f_{i2}^2}{\sum_{k=1}^K f_{ik}^2} \qquad\text{e}\qquad \cos^2_{j1} + \cos^2_{j2} = \frac{g_{j1}^2 + g_{j2}^2}{\sum_{k=1}^K g_{jk}^2} \]
Valores próximos de 1 indicam que a projeção do ponto é fiel. A influência de cada nível na orientação dos eixos é medida pelas contribuições (\(\operatorname{Ctr}\)) para a inércia da \(k\)-ésima dimensão:
\[ \operatorname{Ctr}_{ik} = \frac{r_i f_{ik}^2}{\lambda_k^2} \qquad\text{e}\qquad \operatorname{Ctr}_{jk} = \frac{c_j g_{jk}^2}{\lambda_k^2} \]
A contribuição pondera a posição do nível (\(f_{ik}^2\)) pela sua marginal (\(r_i\)). Por isso, um nível raro pode ficar longe da origem e ainda assim contribuir pouco para o eixo.
Exemplo 5.6 (Cor dos cabelos e dos olhos) O conjunto de dados clássico HairEyeColor relaciona a cor do cabelo e a cor dos olhos de 592 indivíduos. A Tabela 5.4 apresenta as contagens observadas entre quatro cores de cabelo (Preto, Castanho, Ruivo, Loiro) e quatro cores de olhos (Castanho, Azul, Avelã, Verde).
Código
import pandas as pd
import numpy as np
import prince
import matplotlib.pyplot as plt

dados = pd.DataFrame(
    [
        [68, 20, 15, 5],
        [119, 84, 54, 29],
        [26, 17, 14, 14],
        [7, 94, 10, 16],
    ],
    index=["Preto", "Castanho", "Ruivo", "Loiro"],
    columns=["Castanho", "Azul", "Avelã", "Verde"],
)
dados| Castanho | Azul | Avelã | Verde | |
|---|---|---|---|---|
| Preto | 68 | 20 | 15 | 5 |
| Castanho | 119 | 84 | 54 | 29 |
| Ruivo | 26 | 17 | 14 | 14 |
| Loiro | 7 | 94 | 10 | 16 |
A Figura 5.4 exibe o mapa simétrico ajustado pelo prince e a Tabela 5.5 reúne a qualidade de representação (\(\cos^2\)) e as contribuições (\(\operatorname{Ctr}\)) de cada nível.
Código
ca = prince.CA(n_components=3, random_state=SEED).fit(dados)

row_coords = ca.row_coordinates(dados)
col_coords = ca.column_coordinates(dados)
prop = np.array(ca.percentage_of_variance_)
acum = np.cumsum(prop)

fig, ax = plt.subplots(figsize=(5, 4))
ax.scatter(row_coords[0], row_coords[1], color="#4C78A8", marker="o", s=60, label="Cabelo")
ax.scatter(col_coords[0], col_coords[1], color="#E45756", marker="^", s=70, label="Olhos")

for rotulo, linha in row_coords.iterrows():
    ax.annotate(rotulo, (linha[0], linha[1]), xytext=(6, 6), textcoords="offset points")

for rotulo, col in col_coords.iterrows():
    ax.annotate(rotulo, (col[0], col[1]), xytext=(6, -12), textcoords="offset points")

ax.axhline(0, color="0.75", linewidth=0.8)
ax.axvline(0, color="0.75", linewidth=0.8)
ax.set_xlabel(f"Dimensão 1 ({prop[0]:.2f}%)")
ax.set_ylabel(f"Dimensão 2 ({prop[1]:.2f}%)")
ax.set_xlim(-0.6, 1.05)
ax.grid(alpha=0.2)
ax.legend(loc="upper right")
plt.tight_layout()
plt.show()
cos2_r = ca.row_cosine_similarities(dados)
cos2_c = ca.column_cosine_similarities(dados)
ctr_r = ca.row_contributions_
ctr_c = ca.column_contributions_

cos2_total_r = (cos2_r[0] + cos2_r[1]).round(3)
cos2_total_c = (cos2_c[0] + cos2_c[1]).round(3)

pd.DataFrame({
    "Variável": ["Cabelo"] * 4 + ["Olhos"] * 4,
    "Nível": list(dados.index) + list(dados.columns),
    "cos²": list(cos2_total_r) + list(cos2_total_c),
    "Ctr 1 (%)": list((ctr_r[0] * 100).round(1)) + list((ctr_c[0] * 100).round(1)),
    "Ctr 2 (%)": list((ctr_r[1] * 100).round(1)) + list((ctr_c[1] * 100).round(1)),
}).set_index(["Variável", "Nível"])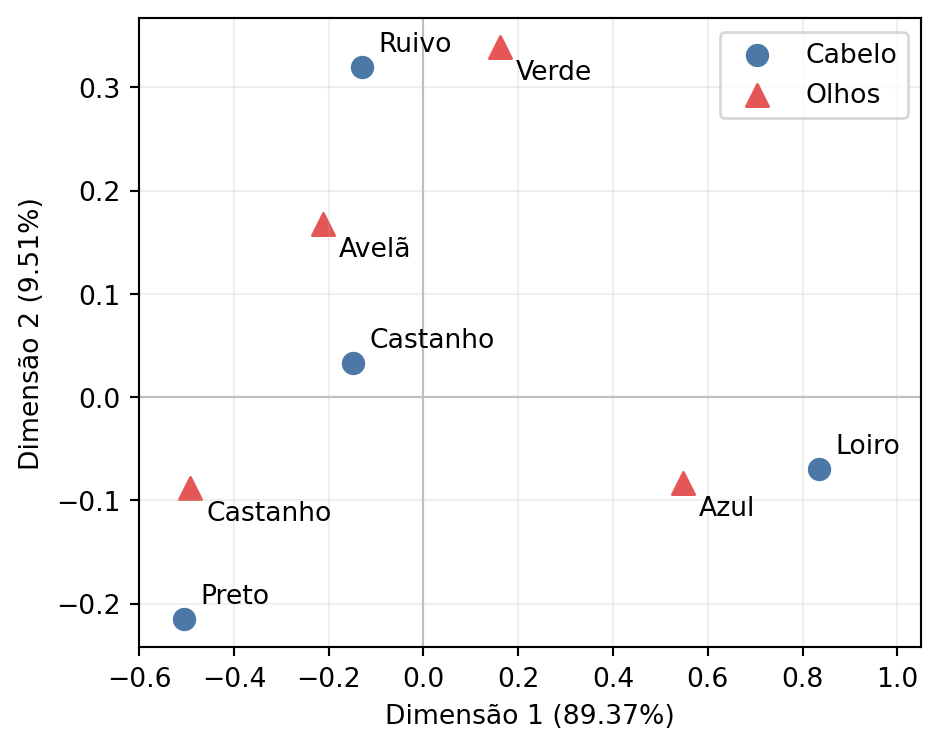
| cos² | Ctr 1 (%) | Ctr 2 (%) | ||
|---|---|---|---|---|
| Variável | Nível | |||
| Cabelo | Preto | 0.990 | 22.2 | 37.9 |
| Castanho | 0.906 | 5.1 | 2.3 | |
| Ruivo | 0.945 | 1.0 | 55.1 | |
| Loiro | 1.000 | 71.7 | 4.7 | |
| Olhos | Castanho | 0.998 | 43.1 | 13.0 |
| Azul | 1.000 | 52.1 | 11.2 | |
| Avelã | 0.879 | 3.4 | 19.8 | |
| Verde | 0.948 | 1.4 | 55.9 |
As duas primeiras dimensões retêm 98.9% da inércia total da tabela, e a Tabela 5.5 confirma que praticamente todos os níveis exibem \(\cos^2\) próximo de 1. A primeira dimensão ordena os níveis pela pigmentação, com os traços claros (cabelo loiro e olhos azuis) em um polo e os escuros (cabelo preto e olhos castanhos) no outro. A segunda dimensão isola o fenótipo ruivo, puxada principalmente pelo cabelo ruivo e pelos olhos verdes, com contribuições de \(55{,}1\%\) e \(55{,}9\%\).
5.5.1 Elementos suplementares
Assim como as variáveis exógenas da ACP, podemos levar ao mapa informações que não participaram do cálculo das coordenadas. Na AC elas recebem o nome de elementos suplementares. Um ponto suplementar é um perfil novo passado pela fórmula de transição, sem entrar na SVD. Um perfil \((p_1^*, \dots, p_J^*)\) sobre os \(J\) níveis-coluna coloca o ponto na nuvem das linhas, e um perfil \((p_1^*, \dots, p_I^*)\) sobre os \(I\) níveis-linha coloca o ponto na nuvem das colunas:
\[ f_k^* = \frac{1}{\lambda_k}\sum_{j=1}^{J} p_j^* g_{jk} \qquad\text{e}\qquad g_k^* = \frac{1}{\lambda_k}\sum_{i=1}^{I} p_i^* f_{ik} \]
Isso serve tanto para uma variável nova, cruzada com uma das variáveis ativas, quanto para um nível que preferimos deixar fora da tabela ativa, como respostas “Não sabe” ou “Prefere não responder”. Nos dois casos, o ponto aparece no mapa sem mexer na posição dos demais.
Exemplo 5.7 Suponha que a pesquisa do Exemplo 5.1 tivesse registrado também o sexo de cada entrevistado. Como o sexo não faz parte da tabela, ele entra como variável suplementar. Para projetá-lo no mapa, cruzamos o sexo com os serviços.
| Sexo | Netflix | Prime Video | Max | Disney+ | Total |
|---|---|---|---|---|---|
| Feminino | 72 | 36 | 36 | 36 | 180 |
| Masculino | 18 | 44 | 44 | 14 | 120 |
Cada sexo vira, assim, um perfil sobre os quatro serviços. O perfil feminino é \((0{,}4;\ 0{,}2;\ 0{,}2;\ 0{,}2)\) e, com as coordenadas dos serviços da Tabela 5.3 e \(\lambda_1 \approx 0{,}4720\),
\[ f_1^* = \frac{0{,}4 \times 0{,}401 + 0{,}2 \times 0{,}019 + 0{,}2 \times (-0{,}736) + 0{,}2 \times 0{,}426}{0{,}4720} \approx 0{,}216 \]
As demais coordenadas saem da mesma conta e estão no código a seguir.
Agora imagine que outras 30 pessoas tivessem respondido “Não sei” quando perguntadas sobre o serviço favorito, sendo 6 jovens, 6 adultos e 18 idosos. Essa resposta não expressa preferência por serviço nenhum, então faz sentido deixá-la de fora da tabela ativa. Ainda assim, “Não sei” é um nível da variável serviço, com perfil \((0{,}2;\ 0{,}2;\ 0{,}6)\) sobre as faixas etárias, e a segunda fórmula o coloca na nuvem das colunas, ao lado dos serviços.
Código
lam = valores_singulares[:2]

# Variável suplementar: sexo cruzado com os serviços, vai para a nuvem das linhas
sexo = np.array([[72, 36, 36, 36], [18, 44, 44, 14]], dtype=float)
f_sexo = (sexo / sexo.sum(axis=1, keepdims=True)) @ G / lam

# Nível suplementar: "Não sei" tem perfil sobre as faixas etárias
perfil_nao_sei = np.array([6, 6, 18]) / 30
g_nao_sei = (perfil_nao_sei @ F) / lam

fig, ax = plt.subplots()
ax.scatter(F[:, 0], F[:, 1], marker="o", s=60, label="Faixa etária")
ax.scatter(G[:, 0], G[:, 1], marker="^", s=70, label="Serviço")
ax.scatter(f_sexo[:, 0], f_sexo[:, 1], marker="o", s=90, facecolors="none",
           edgecolors="0.35", label="Sexo (suplementar)")
ax.scatter(*g_nao_sei, marker="^", s=90, facecolors="none",
           edgecolors="0.35", label="Não sei (suplementar)")

for rotulo, (x, y) in zip(rotulos_linhas + rotulos_colunas, np.vstack([F, G])):
    ax.annotate(rotulo, (x, y), xytext=(6, 6), textcoords="offset points")

for rotulo, (x, y) in zip(["Feminino", "Masculino", "Não sei"],
                          np.vstack([f_sexo, g_nao_sei])):
    ax.annotate(rotulo, (x, y), xytext=(6, -12), textcoords="offset points", style="italic")

ax.axhline(0, color="0.75", linewidth=0.8)
ax.axvline(0, color="0.75", linewidth=0.8)
ax.set_xlabel(f"Dimensão 1 ({inercia_explicada[0]:.2%})")
ax.set_ylabel(f"Dimensão 2 ({inercia_explicada[1]:.2%})")
ax.grid(alpha=0.2)
ax.legend(fontsize=8)
plt.tight_layout()
plt.show()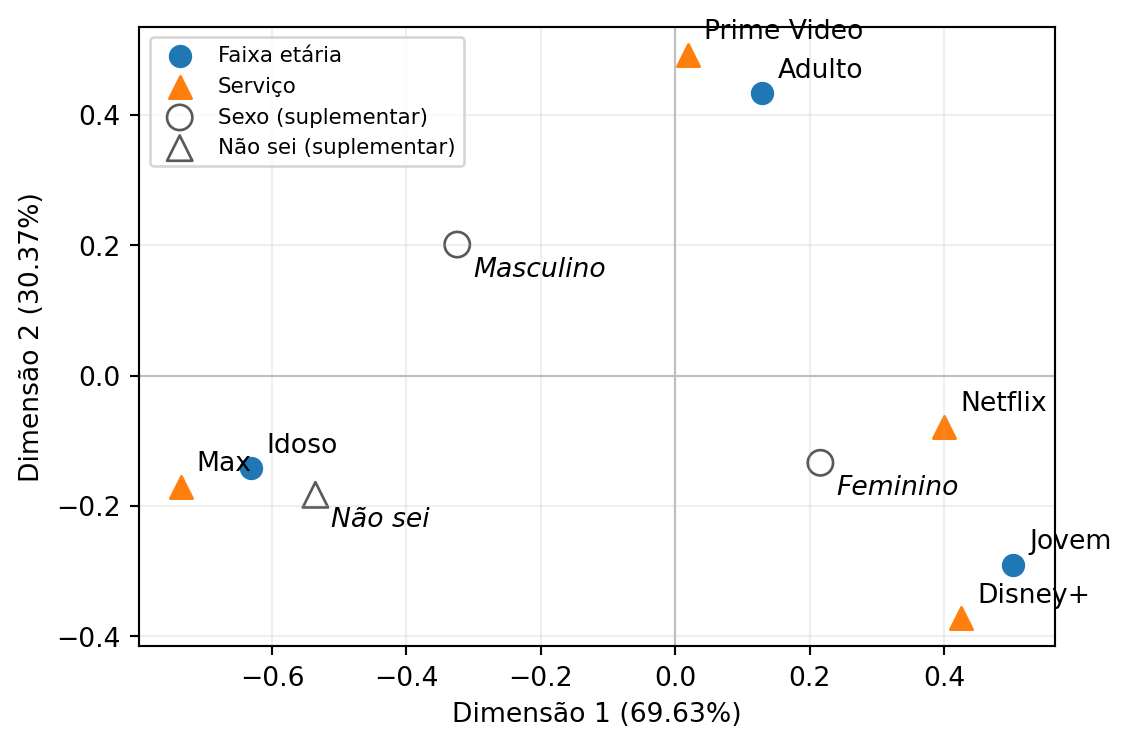
Na Figura 5.5 os dois sexos caem bem mais perto da origem do que qualquer faixa etária, sinal de que o sexo diferencia as preferências bem menos do que a idade. O feminino puxa, de leve, para o lado de Netflix e Disney+, e o masculino para o lado de Max e Prime Video. Já o “Não sei” aparece junto dos idosos, o que é coerente com 60% de quem não soube responder estar nessa faixa.
5.6 Exercícios
Exercício 5.1 O proprietário de uma joalheria catalogou 400 pedras preciosas de acordo com a qualidade do corte (Ideal, Premium, Good) e a tonalidade de cor (D, incolor; E, quase incolor; F, ligeiramente amarelada). A tabela de contingência observada é
| Corte / Cor | D | E | F | Total |
|---|---|---|---|---|
| Ideal | 90 | 60 | 30 | 180 |
| Premium | 40 | 70 | 40 | 150 |
| Good | 20 | 30 | 20 | 70 |
| Total | 150 | 160 | 90 | 400 |
a) Calcule a inércia total \(\phi^2\). Quantas dimensões são necessárias para representar toda essa inércia?
b) Se a joalheria tivesse catalogado 4000 pedras com exatamente as mesmas proporções, o que mudaria na inércia total, na estatística \(\chi^2\) e no p-valor do teste de independência?
c) Usando Python, faça a análise de correspondência e interprete o mapa.
Exercício 5.2 Dois analistas fizeram a análise de correspondência da mesma tabela. Na primeira dimensão, o primeiro obteve as coordenadas principais \(f_{i1}\) e \(g_{j1}\), e o segundo obteve \(-f_{i1}\) e \(-g_{j1}\). Algum deles errou? E se um terceiro analista tivesse invertido o sinal apenas das coordenadas das linhas, mantendo as das colunas?
Exercício 5.3 Na análise de correspondência de uma tabela \(5 \times 5\), as duas primeiras inércias principais são \(\lambda_1^2 = 0{,}15\) e \(\lambda_2^2 = 0{,}03\). Um nível-linha com marginal \(r_1 = 0{,}10\) tem, nas quatro dimensões da análise, as coordenadas principais
\[ (f_{11}, f_{12}, f_{13}, f_{14}) = (0{,}80;\ 0{,}10;\ 0{,}30;\ 0{,}10) \]
a) Calcule a qualidade de representação desse nível no plano das duas primeiras dimensões. A posição dele no mapa é confiável?
b) Calcule as contribuições desse nível para as duas primeiras dimensões. Para qual dos eixos ele é mais relevante?
Exercício 5.4 Em uma pesquisa de preferência por marcas em \(J\) regiões, as marcas A e B, do mesmo fabricante, têm perfis idênticos, isto é, \(p_{Aj}/r_A = p_{Bj}/r_B\) para todo \(j\).
a) Onde esses dois níveis aparecem no mapa de correspondência?
b) Mostre que, se A e B forem fundidas em uma única marca, somando suas contagens, as distâncias qui-quadrado entre as regiões não mudam.
5.7 Análise de correspondência múltipla
Em pesquisas de opinião, formulários socioeconômicos ou fichas de cadastro raramente temos apenas duas variáveis. Em geral, temos \(Q\) perguntas categóricas respondidas por \(n\) pessoas, e queremos um único mapa que mostre ao mesmo tempo como as respostas se associam e onde cada respondente se encontra.
Representar variáveis e indivíduos no mesmo plano é justamente o que o biplot fazia na ACP, e é nesse sentido que a ACM funciona como uma ACP para dados categóricos.
Definição 5.9 (Matriz indicadora) Considere uma amostra de \(n\) observações sobre \(Q\) variáveis categóricas, em que a \(q\)-ésima variável possui \(J_q\) níveis, com \(J = \sum_{q=1}^Q J_q\) níveis no total. A matriz indicadora \(\boldsymbol{Z}\) é uma matriz binária de dimensão \(n \times J\) dividida em \(Q\) blocos:
\[ \boldsymbol{Z} = \begin{pmatrix} \boldsymbol{Z}_1 & \boldsymbol{Z}_2 & \cdots & \boldsymbol{Z}_Q \end{pmatrix} \]
em que cada bloco \(\boldsymbol{Z}_q\) tem dimensão \(n \times J_q\). O elemento \((i, j)\) de \(\boldsymbol{Z}_q\) é igual a 1 se a \(i\)-ésima observação assinalou o \(j\)-ésimo nível da variável \(q\), e 0 caso contrário.
Como cada respondente escolhe exatamente um nível por variável, cada linha de cada bloco \(\boldsymbol{Z}_q\) contém uma única entrada 1. Consequentemente, cada linha da matriz completa \(\boldsymbol{Z}\) soma \(Q\), e a soma de todas as entradas de \(\boldsymbol{Z}\) é \(nQ\). As somas das colunas correspondem às frequências marginais de cada nível, \(n_j = \sum_{i=1}^n z_{ij}\).
Exemplo 5.8 Uma pesquisa sobre deslocamento urbano perguntou a doze pessoas onde moram (Centro, Bairro ou Rural), como vão ao trabalho (Carro, Ônibus ou Bicicleta) e quanto tempo levam no trajeto (Curto ou Longo). São \(Q = 3\) perguntas com \(J_1 = 3\), \(J_2 = 3\) e \(J_3 = 2\) níveis, totalizando \(J = 8\) níveis. Cada pergunta vira um bloco de colunas, e a resposta de cada pessoa vira um 1 na coluna do nível assinalado. A primeira pessoa, por exemplo, mora no centro, vai de bicicleta e tem trajeto curto.
\[ \boldsymbol{Z} = \left( \begin{array}{ccc|ccc|cc} \text{Centro} & \text{Bairro} & \text{Rural} & \text{Carro} & \text{Ônibus} & \text{Bicicleta} & \text{Curto} & \text{Longo} \\ \hline 1 & 0 & 0 & 0 & 0 & 1 & 1 & 0 \\ 1 & 0 & 0 & 0 & 0 & 1 & 1 & 0 \\ 1 & 0 & 0 & 0 & 1 & 0 & 1 & 0 \\ 1 & 0 & 0 & 1 & 0 & 0 & 1 & 0 \\ 0 & 1 & 0 & 0 & 0 & 1 & 1 & 0 \\ 0 & 1 & 0 & 0 & 1 & 0 & 1 & 0 \\ 0 & 1 & 0 & 0 & 1 & 0 & 0 & 1 \\ 0 & 1 & 0 & 0 & 1 & 0 & 0 & 1 \\ 0 & 1 & 0 & 1 & 0 & 0 & 0 & 1 \\ 0 & 0 & 1 & 0 & 1 & 0 & 0 & 1 \\ 0 & 0 & 1 & 1 & 0 & 0 & 0 & 1 \\ 0 & 0 & 1 & 1 & 0 & 0 & 0 & 1 \end{array} \right) \]
Toda linha tem exatamente três entradas iguais a 1, uma por pergunta, e portanto soma \(Q = 3\). O total geral é \(nQ = 36\). Já as somas das colunas contam quantas vezes cada nível foi assinalado, \((4, 5, 3 \mid 4, 5, 3 \mid 6, 6)\), e dentro de cada bloco elas somam \(n = 12\), porque toda pessoa responde a todas as perguntas.
As definições da ACS seguem valendo, com a matriz indicadora no papel da tabela de contingência. A matriz de correspondência é \(\boldsymbol{P} = \boldsymbol{Z}/(nQ)\) e, como cada linha de \(\boldsymbol{Z}\) soma \(Q\) e a coluna \(j\) soma \(n_j\), as marginais são
\[ r_i = \frac{1}{n} \qquad\text{e}\qquad c_j = \frac{n_j}{nQ} = \frac{p_j}{Q} \]
em que \(p_j = n_j/n\) é a proporção de respondentes que assinalaram o nível \(j\). Todos os indivíduos pesam o mesmo, e cada nível pesa conforme sua frequência. Dentro de um bloco as marginais somam \(1/Q\), então cada pergunta entra com o mesmo peso, não importa quantos níveis tenha.
5.7.1 Inércia na ACM
A matriz \(\boldsymbol{S}\) e a inércia total são calculadas como antes, mas a leitura muda. A hipótese de independência diz que cada pessoa responde conforme as marginais, espalhando massa por todos os níveis, e nenhum respondente faz isso, já que tem zeros em todos os níveis que não assinalou. Por isso a inércia da matriz indicadora não mede associação entre as perguntas.
Proposição 5.5 (Inércia total da matriz indicadora) Na análise de correspondência da matriz indicadora, a inércia do nível \(j\) é \((1 - p_j)/Q\) e a inércia total vale
\[ \phi^2 = \frac{J - Q}{Q} \]
qualquer que seja a associação entre as variáveis.
Prova. Substituindo \(p_{ij} = z_{ij}/(nQ)\), \(r_i = 1/n\) e \(c_j = p_j/Q\) na Definição 5.4:
\[ s_{ij} = \frac{p_{ij} - r_i c_j}{\sqrt{r_i c_j}} = \frac{(z_{ij} - p_j)/(nQ)}{\sqrt{p_j/(nQ)}} = \frac{z_{ij} - p_j}{\sqrt{nQ\,p_j}} \]
A coluna \(j\) de \(\boldsymbol{Z}\) é uma variável binária com média \(p_j\), e sua soma de quadrados em torno da média é \(\sum_i (z_{ij} - p_j)^2 = n p_j(1 - p_j)\). A inércia do nível \(j\) é, então,
\[ \sum_{i=1}^{n} s_{ij}^2 = \frac{n p_j (1 - p_j)}{nQ\,p_j} = \frac{1 - p_j}{Q} \]
Em cada uma das \(Q\) perguntas as proporções somam 1, então \(\sum_j p_j = Q\) e, somando sobre os \(J\) níveis, \(\phi^2 = (J - Q)/Q\).
A inércia depende apenas do número de níveis e da frequência de cada um, e não de como as perguntas se relacionam. A prova mostra ainda que \(\boldsymbol{S}\) é a matriz indicadora centrada, com cada coluna dividida por \(\sqrt{nQ\,p_j}\), o que reforça a leitura da ACM como uma ACP das variáveis indicadoras.
5.7.2 Solução e mapa de correspondência
A partir daqui, tudo segue como na ACS. Decompomos \(\boldsymbol{S} = \boldsymbol{U}\boldsymbol{\Lambda}\boldsymbol{V}^T\) e obtemos as coordenadas principais (Definição 5.8), agora com uma linha de \(\boldsymbol{F}\) por respondente e uma linha de \(\boldsymbol{G}\) por nível. O número de dimensões não triviais é \(K = J - Q\).
As fórmulas de transição ganham uma leitura simples. Como \(p_{ij}/r_i = z_{ij}/Q\), o perfil de um respondente é a lista dos \(Q\) níveis que ele assinalou, e as fórmulas viram médias:
\[ f_{ik} = \frac{1}{\lambda_k}\,\frac{1}{Q}\sum_{j \in C(i)} g_{jk} \qquad\text{e}\qquad g_{jk} = \frac{1}{\lambda_k}\,\frac{1}{n_j}\sum_{i \in I(j)} f_{ik} \]
em que \(C(i)\) reúne os \(Q\) níveis assinalados pelo respondente \(i\) e \(I(j)\) reúne os \(n_j\) respondentes que assinalaram o nível \(j\). A menos do fator \(1/\lambda_k\), cada pessoa fica no centro dos níveis que marcou e cada nível fica no centro das pessoas que o marcaram. Essa é a propriedade baricêntrica, e é ela que permite desenhar pessoas e níveis no mesmo mapa.
Exemplo 5.9 O código a seguir aplica a decomposição ao questionário do Exemplo 5.8 e desenha as doze pessoas junto dos oito níveis.
Código
import numpy as np
import matplotlib.pyplot as plt

Z = np.array([
    [1, 0, 0, 0, 0, 1, 1, 0],
    [1, 0, 0, 0, 0, 1, 1, 0],
    [1, 0, 0, 0, 1, 0, 1, 0],
    [1, 0, 0, 1, 0, 0, 1, 0],
    [0, 1, 0, 0, 0, 1, 1, 0],
    [0, 1, 0, 0, 1, 0, 1, 0],
    [0, 1, 0, 0, 1, 0, 0, 1],
    [0, 1, 0, 0, 1, 0, 0, 1],
    [0, 1, 0, 1, 0, 0, 0, 1],
    [0, 0, 1, 0, 1, 0, 0, 1],
    [0, 0, 1, 1, 0, 0, 0, 1],
    [0, 0, 1, 1, 0, 0, 0, 1],
], dtype=float)

niveis = ["Centro", "Bairro", "Rural", "Carro", "Ônibus", "Bicicleta", "Curto", "Longo"]
n, Q = Z.shape[0], 3

P_acm = Z / Z.sum()
r_acm = P_acm.sum(axis=1)
c_acm = P_acm.sum(axis=0)
S_acm = np.diag(1 / np.sqrt(r_acm)) @ (P_acm - np.outer(r_acm, c_acm)) @ np.diag(1 / np.sqrt(c_acm))

U_acm, lam_acm, Vt_acm = np.linalg.svd(S_acm, full_matrices=False)
tol = np.finfo(float).eps * max(S_acm.shape) * lam_acm[0]
lam_acm = lam_acm[lam_acm > tol]
K = len(lam_acm)

F_acm = np.diag(1 / np.sqrt(r_acm)) @ U_acm[:, :K] @ np.diag(lam_acm)
G_acm = np.diag(1 / np.sqrt(c_acm)) @ Vt_acm.T[:, :K] @ np.diag(lam_acm)
explicada = lam_acm**2 / np.sum(lam_acm**2)

fig, ax = plt.subplots()
ax.scatter(F_acm[:, 0], F_acm[:, 1], marker="o", s=60, label="Pessoa")
ax.scatter(G_acm[:, 0], G_acm[:, 1], marker="^", s=70, label="Nível")

# Pessoas com as mesmas respostas caem no mesmo ponto e dividem um rótulo
rotulos_pessoa = {}
for i, (x, y) in enumerate(F_acm[:, :2].round(6), start=1):
    rotulos_pessoa.setdefault((x, y), []).append(str(i))
for (x, y), ids in rotulos_pessoa.items():
    ax.annotate(", ".join(ids), (x, y), xytext=(6, 6), textcoords="offset points")

for rotulo, (x, y) in zip(niveis, G_acm[:, :2]):
    ax.annotate(rotulo, (x, y), xytext=(6, -12), textcoords="offset points")

ax.axhline(0, color="0.75", linewidth=0.8)
ax.axvline(0, color="0.75", linewidth=0.8)
ax.set_xlabel(f"Dimensão 1 ({explicada[0]:.1%})")
ax.set_ylabel(f"Dimensão 2 ({explicada[1]:.1%})")
ax.set_xlim(-1.7, 1.7)
ax.set_ylim(-1.3, 1.3)
ax.grid(alpha=0.2)
ax.legend()
plt.tight_layout()
plt.show()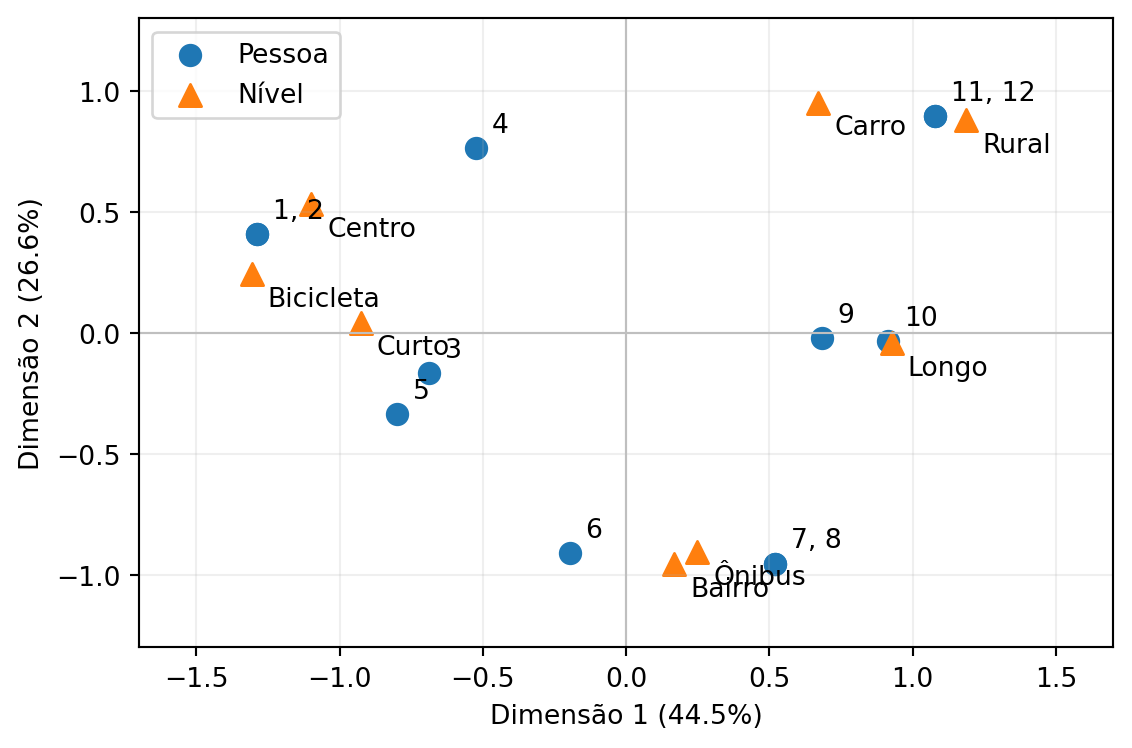
A análise devolve \(K = J - Q = 5\) dimensões, com autovalores 0.742, 0.443, 0.229, 0.184 e 0.068, que somam a inércia \(5/3\) prevista pela Proposição 5.5.
Na Figura 5.6, a primeira dimensão separa quem mora perto e chega rápido (Centro, Bicicleta e Curto) de quem mora longe e demora (Rural, Carro e Longo). As pessoas se espalham ao longo desse eixo na mesma ordem e, pela propriedade baricêntrica, cada uma fica perto dos níveis que assinalou. Quem deu exatamente as mesmas respostas, como as pessoas 1 e 2, ocupa o mesmo ponto do mapa.
A segunda dimensão não traz informação nova. Os pontos desenham um arco, com os níveis intermediários, Bairro e Ônibus, de um lado do eixo e os extremos, Centro, Bicicleta, Rural e Carro, do outro. Esse arco, ou ferradura, é conhecido como efeito Guttman e costuma aparecer quando as respostas seguem um único gradiente.
A matriz \(\boldsymbol{F}\) também serve fora do mapa. Cada respondente, que chegou como uma lista de respostas categóricas, sai da ACM como um vetor numérico, e \(\boldsymbol{F}\) faz na ACM o papel da matriz de escores da ACP (Definição 4.3). A pessoa 1 do questionário de deslocamento, que mora no centro, vai de bicicleta e tem trajeto curto, vira o ponto \((-1{,}29;\ 0{,}41)\) nas duas primeiras dimensões. Pela propriedade baricêntrica, esse escore é a média dos valores dos níveis que ela marcou, como uma pontuação de questionário com pesos escolhidos pelos próprios dados.
Poderíamos argumentar que \(\boldsymbol{Z}\) já é numérica e bastaria usá-la diretamente. A distância euclidiana entre duas linhas de \(\boldsymbol{Z}\), porém, só conta em quantas perguntas as duas pessoas discordam, e toda discordância pesa igual. A ACM usa a distância qui-quadrado entre os perfis, que na matriz indicadora, com \(p_{ij}/r_i = z_{ij}/Q\) e \(c_j = n_j/(nQ)\), fica
\[ d_{\chi^2}^2(i, i') = \frac{n}{Q}\sum_{j=1}^{J} \frac{(z_{ij} - z_{i'j})^2}{n_j} \]
Cada discordância pesa pelo inverso da frequência dos níveis envolvidos. As pessoas 6 e 7 discordam apenas no trajeto, entre Curto e Longo, assinalados por seis pessoas cada, e \(d_{\chi^2}^2 = 4(1/6 + 1/6) \approx 1{,}33\). As pessoas 1 e 3 também discordam em uma única pergunta, mas entre Bicicleta e Ônibus, assinalados por três e cinco pessoas, e \(d_{\chi^2}^2 = 4(1/3 + 1/5) \approx 2{,}13\). Em \(\boldsymbol{Z}\) os dois pares estariam à mesma distância, \(\sqrt{2}\). Pela Proposição 5.4, a distância euclidiana entre as linhas de \(\boldsymbol{F}\) reproduz essa distância qui-quadrado, e é isso que torna legítimo usar \(\boldsymbol{F}\) como entrada de técnicas que dependem de distâncias ou de variáveis numéricas, como a análise de agrupamentos e a análise discriminante.
5.7.3 Escolha das dimensões
Como a inércia total é fixada pelo número de níveis, os percentuais de inércia explicada saem baixos em ACM, e um primeiro eixo com 15% ou 20% é normal. Por isso, em vez de olhar os percentuais, comparamos cada autovalor com a inércia média por dimensão,
\[ \frac{\phi^2}{K} = \frac{(J - Q)/Q}{J - Q} = \frac{1}{Q} \]
O critério de Benzécri recomenda interpretar apenas os eixos que superam essa média, \(\lambda_k^2 > 1/Q\). No questionário de deslocamento, \(1/Q = 0{,}333\) e apenas os dois primeiros autovalores, \(0{,}742\) e \(0{,}443\), superam esse limiar, então as três últimas dimensões podem ser descartadas. A segunda passa no critério, mas já sabemos que ela descreve apenas o arco, e a leitura se concentra na primeira.
Níveis raros pedem cuidado. Pela Proposição 5.5, a inércia de um nível, \((1 - p_j)/Q\), cresce conforme ele fica raro e se aproxima de \(1/Q\), a inércia média por dimensão. Como quase ninguém marcou esse nível, sua inércia não se dilui em um eixo compartilhado, e a decomposição acaba reservando um eixo só para separar aquele punhado de pessoas. O remédio é fundir esses níveis com outros afins ou declará-los suplementares.
Exemplo 5.10 (Surto alimentar) O conjunto poison registra um episódio de intoxicação alimentar em um acampamento com 55 crianças. Para cada criança foram anotados 5 sintomas clínicos e o consumo de 6 alimentos, todos como variáveis binárias, além do diagnóstico geral.
Código
import pandas as pd
import prince
from adjustText import adjust_text

poison = pd.read_csv("dados/poison.csv")

sintomas = ["Nausea", "Vomiting", "Abdominals", "Fever", "Diarrhae"]
alimentos = ["Potato", "Fish", "Mayo", "Courgette", "Cheese", "Icecream"]

rotulos_var = {
    "Nausea": "Náusea", "Vomiting": "Vômito", "Abdominals": "Dor abdominal",
    "Fever": "Febre", "Diarrhae": "Diarreia", "Potato": "Batata",
    "Fish": "Peixe", "Mayo": "Maionese", "Courgette": "Abobrinha",
    "Cheese": "Queijo", "Icecream": "Sorvete",
}
sintomas_pt = [rotulos_var[v] for v in sintomas]
alimentos_pt = [rotulos_var[v] for v in alimentos]

dados_acm = poison[sintomas + alimentos].rename(columns=rotulos_var)
for col in dados_acm.columns:
    dados_acm[col] = np.where(dados_acm[col].str.endswith("_y"), "Sim", "Não")

dados_acm["Adoeceu"] = np.where(poison["Sick"] == "Sick_y", "Sim", "Não")

pd.DataFrame([
    {
        "Variável": col,
        "Sim": int((dados_acm[col] == "Sim").sum()),
        "Não": int((dados_acm[col] == "Não").sum()),
    }
    for col in dados_acm.columns if col != "Adoeceu"
]).set_index("Variável")| Sim | Não | |
|---|---|---|
| Variável | ||
| Náusea | 12 | 43 |
| Vômito | 22 | 33 |
| Dor abdominal | 37 | 18 |
| Febre | 35 | 20 |
| Diarreia | 35 | 20 |
| Batata | 52 | 3 |
| Peixe | 54 | 1 |
| Maionese | 45 | 10 |
| Abobrinha | 50 | 5 |
| Queijo | 48 | 7 |
| Sorvete | 51 | 4 |
As onze variáveis, sintomas e alimentos, entram como ativas, e o diagnóstico geral fica como suplementar, para que não influencie os eixos e sirva de conferência da leitura. Note, na Tabela 5.6, que peixe, batata, abobrinha e sorvete foram consumidos por quase todo mundo. O nível Não dessas variáveis é justamente o tipo de nível raro que acabamos de discutir, e vamos ver o efeito dele na análise.
Código
ativas = sintomas_pt + alimentos_pt
K_poison = dados_acm[ativas].nunique().sum() - len(ativas)

acm = prince.MCA(n_components=K_poison, random_state=SEED).fit(dados_acm[ativas])
autovalores = np.array(acm.eigenvalues_)
prop_poison = np.array(acm.percentage_of_variance_)

pd.DataFrame({
    "Dimensão": np.arange(1, K_poison + 1),
    "Autovalor": autovalores.round(3),
    "Inércia explicada (%)": prop_poison.round(1),
    "Acumulada (%)": prop_poison.cumsum().round(1),
}).set_index("Dimensão").rename_axis(None)| Autovalor | Inércia explicada (%) | Acumulada (%) | |
|---|---|---|---|
| 1 | 0.335 | 33.5 | 33.5 |
| 2 | 0.129 | 12.9 | 46.4 |
| 3 | 0.107 | 10.7 | 57.2 |
| 4 | 0.096 | 9.6 | 66.8 |
| 5 | 0.079 | 7.9 | 74.6 |
| 6 | 0.071 | 7.1 | 81.8 |
| 7 | 0.060 | 6.0 | 87.8 |
| 8 | 0.056 | 5.6 | 93.3 |
| 9 | 0.041 | 4.1 | 97.5 |
| 10 | 0.013 | 1.3 | 98.8 |
| 11 | 0.012 | 1.2 | 100.0 |
Com \(Q = 11\) variáveis ativas e \(J = 22\) níveis, a análise tem \(K = 11\) dimensões e o limiar de Benzécri é \(1/11 \approx 0{,}091\). A Tabela 5.7 mostra que as quatro primeiras dimensões superam esse limiar e somam 66.8% da inércia. A primeira se destaca, com 33.5% sozinha, enquanto as três seguintes ficam próximas umas das outras e do próprio limiar.
Código
coords_nivel = acm.column_coordinates(dados_acm[ativas])
coords_pessoa = acm.row_coordinates(dados_acm[ativas])
contrib = acm.column_contributions_

# Suplementar: cada nível do diagnóstico fica no centro de quem o assinalou, dividido por lambda_k
coords_sup = coords_pessoa.groupby(dados_acm["Adoeceu"].to_numpy()).mean() / np.sqrt(autovalores)
coords_sup.index = "Adoeceu: " + coords_sup.index

e_sim = coords_nivel.index.str.endswith("__Sim")

fig, ax = plt.subplots(figsize=(7.5, 5.5))
ax.scatter(coords_nivel.loc[e_sim, 0], coords_nivel.loc[e_sim, 1],
           color="#C44E52", marker="o", s=60, label="Sim")
ax.scatter(coords_nivel.loc[~e_sim, 0], coords_nivel.loc[~e_sim, 1],
           color="#4C78A8", marker="s", s=50, label="Não")
ax.scatter(coords_sup[0], coords_sup[1], color="0.35", marker="D", s=70,
           label="Adoeceu (suplementar)")

# adjust_text afasta os rótulos para que não se sobreponham
rotulos = [ax.text(x, y, nome.replace("__", ": "), fontsize=8)
           for nome, (x, y) in coords_nivel.iloc[:, :2].iterrows()]
rotulos += [ax.text(x, y, nome, fontsize=8, style="italic")
            for nome, (x, y) in coords_sup.iloc[:, :2].iterrows()]
adjust_text(rotulos, ax=ax, arrowprops=dict(arrowstyle="-", color="0.6", lw=0.5))

ax.axhline(0, color="0.75", linewidth=0.8)
ax.axvline(0, color="0.75", linewidth=0.8)
ax.set_xlabel(f"Dimensão 1 ({prop_poison[0]:.1f}%)")
ax.set_ylabel(f"Dimensão 2 ({prop_poison[1]:.1f}%)")
ax.grid(alpha=0.2)
ax.legend(loc="upper right")
plt.tight_layout()
plt.show()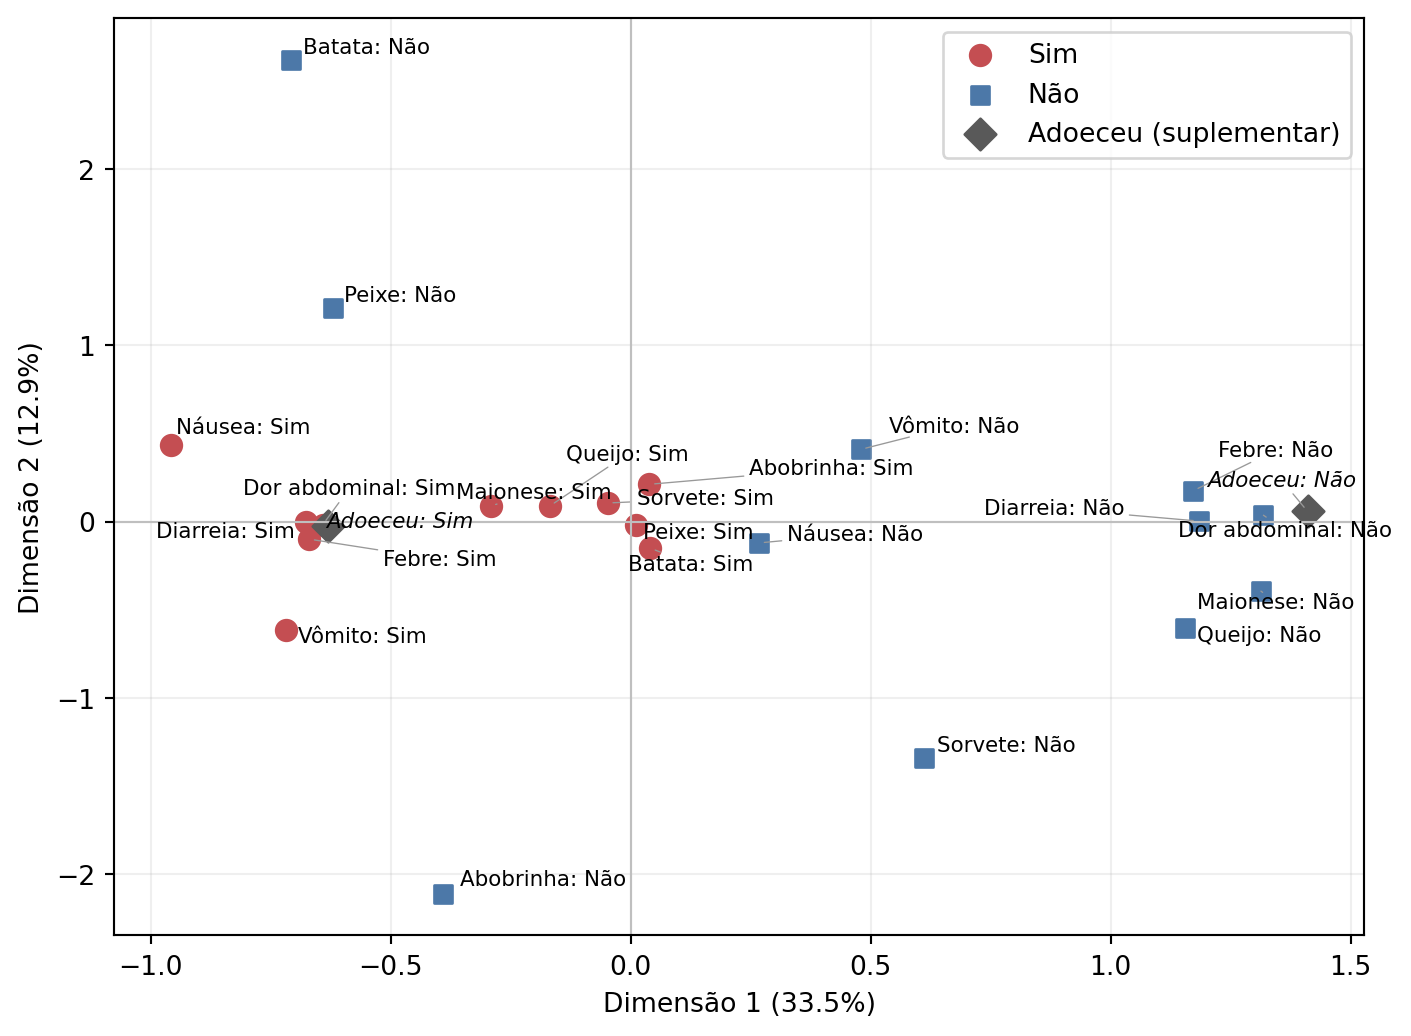
Na Figura 5.7, a primeira dimensão funciona como um gradiente de contaminação. Os Sim dos cinco sintomas se agrupam de um lado e os Não do outro, e o diagnóstico geral confirma a leitura, com Adoeceu: Sim e Adoeceu: Não nos extremos do eixo, sem ter participado da construção dele. Entre os alimentos, a maioria dos níveis fica perto da origem nessa dimensão, ou seja, ter comido ou não aquele alimento pouco tem a ver com os sintomas. A exceção é Maionese: Não, que cai do lado das crianças saudáveis, acompanhada de Queijo: Não. De fato, das 10 crianças que não comeram maionese, 8 não adoeceram, e a maionese aparece como o foco provável do surto.
A segunda dimensão mostra o efeito dos níveis raros. Batata: Não e Abobrinha: Não, assinalados por 3 e 5 crianças, ocupam os extremos do eixo e respondem juntos por 55% da contribuição dele. O eixo existe basicamente para separar essas oito crianças das demais e não descreve nenhum padrão do surto.
As dimensões 3 e 4 não aparecem no mapa, mas as contribuições contam a mesma história. Na terceira, Sorvete: Não, Batata: Não e Peixe: Não respondem por 23%, 21% e 21% da contribuição. Na quarta, Peixe: Não, assinalado por uma única criança, responde sozinho por 53%. Para limpar essas dimensões, bastaria declarar os níveis raros como suplementares.
5.7.4 Tabela de Burt
Muitos programas oferecem uma alternativa à matriz indicadora, que é aplicar a análise de correspondência à tabela de Burt.
Definição 5.10 (Tabela de Burt) A tabela de Burt é a matriz simétrica \(J \times J\)
\[ \boldsymbol{B} = \boldsymbol{Z}^T\boldsymbol{Z} = \begin{pmatrix} \boldsymbol{Z}_1^T\boldsymbol{Z}_1 & \cdots & \boldsymbol{Z}_1^T\boldsymbol{Z}_Q \\ \vdots & \ddots & \vdots \\ \boldsymbol{Z}_Q^T\boldsymbol{Z}_1 & \cdots & \boldsymbol{Z}_Q^T\boldsymbol{Z}_Q \end{pmatrix} \]
Fora da diagonal, o bloco \(\boldsymbol{Z}_q^T\boldsymbol{Z}_{q'}\) é a tabela de contingência entre as variáveis \(q\) e \(q'\). Na diagonal, \(\boldsymbol{Z}_q^T\boldsymbol{Z}_q\) é uma matriz diagonal com as frequências \(n_j\) dos níveis da variável \(q\).
Exemplo 5.11 No questionário do Exemplo 5.8, a tabela de Burt reúne as três tabelas de contingência entre moradia, transporte e trajeto, cada uma aparecendo duas vezes por simetria. As linhas seguem a mesma ordem das colunas.
\[ \boldsymbol{B} = \left( \begin{array}{ccc|ccc|cc} \text{Centro} & \text{Bairro} & \text{Rural} & \text{Carro} & \text{Ônibus} & \text{Bicicleta} & \text{Curto} & \text{Longo} \\ \hline 4 & 0 & 0 & 1 & 1 & 2 & 4 & 0 \\ 0 & 5 & 0 & 1 & 3 & 1 & 2 & 3 \\ 0 & 0 & 3 & 2 & 1 & 0 & 0 & 3 \\ \hline 1 & 1 & 2 & 4 & 0 & 0 & 1 & 3 \\ 1 & 3 & 1 & 0 & 5 & 0 & 2 & 3 \\ 2 & 1 & 0 & 0 & 0 & 3 & 3 & 0 \\ \hline 4 & 2 & 0 & 1 & 2 & 3 & 6 & 0 \\ 0 & 3 & 3 & 3 & 3 & 0 & 0 & 6 \end{array} \right) \]
O bloco entre moradia e transporte, por exemplo, mostra que, das quatro pessoas do centro, duas vão de bicicleta, uma de ônibus e uma de carro. Na diagonal reaparecem as frequências \((4, 5, 3)\), \((4, 5, 3)\) e \((6, 6)\), as mesmas somas das colunas de \(\boldsymbol{Z}\).
Aplicar a AC à tabela de Burt não produz uma análise nova. Os eixos são os mesmos da matriz indicadora, e as inércias principais da Burt são \(\lambda_k^4\), os quadrados das inércias da indicadora. As coordenadas dos níveis só mudam de escala, ficando multiplicadas por \(\lambda_k\) em cada eixo, então o mapa dos níveis é o mesmo desenho, com as dimensões fracas encolhidas mais do que as fortes.
Na prática, isso traz duas diferenças. Os indivíduos desaparecem, porque \(\boldsymbol{B}\) só tem níveis, e se quisermos as pessoas no mapa elas precisam entrar como pontos suplementares. Além disso, elevar as inércias ao quadrado concentra os percentuais nos primeiros eixos. No questionário de deslocamento, as duas primeiras dimensões passam de \(44{,}5\%\) e \(26{,}6\%\) para \(65{,}7\%\) e \(23{,}4\%\). A Burt também não resolve o problema da inércia fixada pelos níveis, já que os blocos da diagonal, que cruzam cada variável com ela mesma, continuam inflando a inércia total sem medir associação alguma.
5.8 Exercícios
Exercício 5.5 Um questionário socioeconômico reúne \(Q = 8\) variáveis categóricas com 3 níveis cada.
a) Calcule a inércia total da matriz indicadora, o número de dimensões não triviais e o limiar de Benzécri.
b) As duas primeiras dimensões têm autovalores \(\lambda_1^2 = 0{,}35\) e \(\lambda_2^2 = 0{,}20\), e as demais ficam abaixo do limiar. Quanto da inércia total essas duas dimensões explicam? Esse percentual indica que a análise é ruim?
Exercício 5.6 Retome o questionário de deslocamento do Exemplo 5.8.
a) Calcule a inércia e a distância qui-quadrado ao perfil médio dos níveis Rural e Bairro. Qual dos dois fica mais longe da origem e qual carrega mais inércia?
b) Mostre que cada pergunta \(q\) contribui com \((J_q - 1)/Q\) para a inércia total. Por que perguntas com mais níveis pesam mais na análise?
Exercício 5.7 (Cogumelos) O conjunto Mushroom, da UCI Machine Learning Repository, descreve 8.124 cogumelos de 23 espécies das famílias Agaricus e Lepiota. Cada cogumelo é caracterizado por 22 atributos morfológicos categóricos, como forma e cor do chapéu, odor, cor das lamelas e hábitat, e classificado como comestível ou venenoso. Use a ACM para descrever como esses atributos se associam, deixando a classificação comestível/venenoso como variável suplementar. Existe algum atributo que, sozinho, praticamente separa os dois grupos? Justifique todas as decisões tomadas, em especial o tratamento dos níveis raros e dos valores ausentes.